B站开源Index-Translate实测:150语言本地部署,企业级翻译终于能用了

B站开源Index-Translate,以JSON稳定输出和工程可用性为核心,9B版本翻译质量超越谷歌翻译。
B站开源的Index-Translate翻译模型,针对企业AI翻译项目中普遍存在的"翻对了却用不上"的工程落地痛点而设计。模型基于通义千问进行后训练,提供2B、9B、35B三个版本,支持150种语言。其核心差异化能力在于:原生稳定的JSON格式输出、灵活的数字与术语处理、以及对俚语古诗等文化负载内容的语义理解。测评数据显示,9B版本已超越谷歌翻译,35B A3B版本在多领域排名第一且无明显短板。模型已在Hugging Face全面开源,支持vLLM部署,并配有ASR、TTS和实时字幕等完整功能链路,社区也在推进面向普通硬件的GGUF量化版本。
AI翻译的真正痛点:翻对了,却用不上
做AI咨询这些年,一个反复出现的现象是:客户投诉翻译问题,但追查下去,大多数并不是翻译质量不行,而是翻译在工程落地环节出了岔子。这类问题甚至比翻译错误更棘手——翻错了至少知道去哪儿改,而“看起来全对、生产上却没法用”则让人无从下手。
常见的坑有三类:第一,AI翻译内容正确,但系统读不了输出的文件格式;第二,强文转换存在多种说法,客户误以为内容被擅自改动;第三,字幕逐句都对,但匹配到视频后声音和画面对不齐,或者好评翻译后在系统里搜不到。这些问题在语言学上完全合格,在工程上却彻底不可用。
B站近期开源的 Index-Translate 模型,正是冲着这类“工程可用性”去解决问题的。
模型概览:基于千问后训练的三个版本
Index-Translate 基于通义千问广告 3.5B 模型进行后训练,目前提供 2B、9B 和 35B 三个版本。2B 版本主打速度,适合对延迟敏感的场景;9B 版本在速度与能力之间取得平衡,是较为通用的选择;35B 版本(35B A3B)效果最佳,在多项测评中拿到第一。
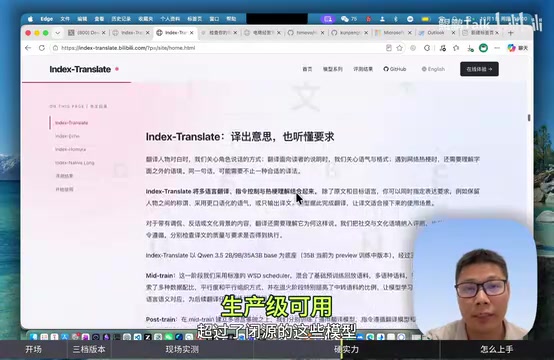
模型支持 150 种语言,这得益于千问基座本身就是多语言模型。B站在此基础上对小语种做了针对性的强化训练,强调翻译的泛化性,力图在各个语言和领域都没有明显短板——用形象的说法是“八边形战士”,而不是只擅长某一个领域的偏科模型。
关键差异:为工程落地设计的能力
真正让这个模型区别于普通翻译模型的,是它为落地场景设计的几个特性。
JSON 格式稳定输出
很多大模型不支持结构化的 JSON 输出,即便支持也不稳定——有时对有时错。而在企业级流程里,翻译结果往往要进入后续的工程加工环节,JSON 不稳定会直接导致流水线崩溃。Index-Translate 原生支持 JSON 格式输出,省去了大量二次加工和容错处理的工程成本。
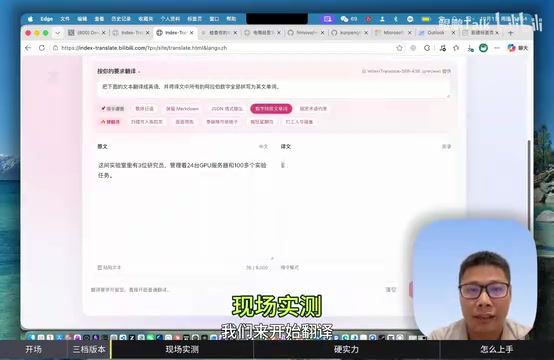
JSON(JavaScript Object Notation)是目前企业系统间数据交换最通用的格式。在翻译流水线中,上游系统通常会把待翻译文本打包成 JSON 发送给翻译服务,翻译结果也需要以 JSON 返回,才能被下游的内容管理系统、数据库或渲染引擎直接消费。如果模型输出的 JSON 结构不稳定——例如偶尔多出注释、括号不闭合、键名大小写不一致——解析器就会抛出异常,导致整条流水线中断。这也是为什么工程团队宁可选翻译质量稍逊但格式可靠的方案,而不敢用质量更好却需要手动清洗输出的模型。
数字与术语处理
模型可以把数字转换成英文单词,也能在需要时保留原始数字和英文,还支持约定术语的处理。这些看似琐碎的细节,恰恰是传统翻译模型容易翻车的地方,也是企业内容规范里最常见的硬性要求。
俚语、谚语与古诗
在处理俚语、谚语、口头禅乃至古诗翻译时,模型能较好地理解背后的真实含义,而不是生硬的字面直译。对日语敬语等有复杂语境规则的语言,也有不错的支持。
实测:实时翻译与同传效果
演示环境提供了文本翻译、语音翻译、语音转文字(ASR)、文字转语音(TTS)等完整功能。实测把一段中文语音实时翻译成英文字幕,输出的英文表达自然流畅——“I think this is really great, and I often post my videos on YouTube...”这类句子衔接得相当自然。
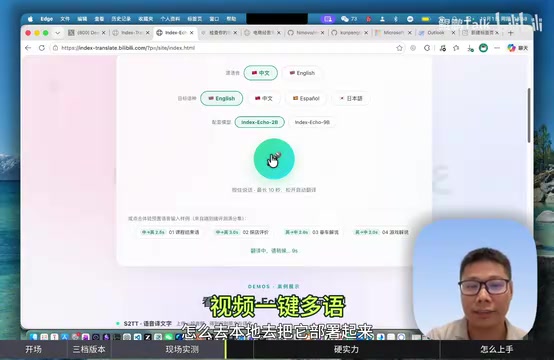
线上 demo 的切片最长不超过 10 秒,这主要受在线算力限制;若在本地部署则不存在该约束。ASR 与 TTS 模型结合起来,可以搭出一套同声传译的流程;配合长文档翻译功能,上传整篇文档即可一次性翻译完成。对经常把视频发到 YouTube 的创作者来说,这意味着可以直接产出英文配音和字幕版本。
性能对比:9B 打赢谷歌翻译
测评数据中最让人意外的一点:9B 版本在翻译质量上就能超过长期被视为难以撼动的谷歌翻译,同时也能轻松超越千问自家约 100B 规模的 flash 模型。35B A3B 版本更是在多个领域排名第一,且各领域能力均衡,没有明显弱项。
按作者的判断,这个模型已经达到生产级别、完全可用,并且超过了同类闭源模型的表现。需要说明的是,这些结论来自作者的实测与官方测评数据,具体表现仍建议按自身场景验证。
翻译质量评测通常使用 BLEU、COMET 等自动指标。BLEU 通过计算机器译文与参考译文之间的 n-gram 重叠率来打分,历史悠久但对语义的捕捉较弱;COMET 则基于预训练语言模型对译文进行语义层面的评分,与人工评分的相关性更高,是近年翻译领域更受认可的基准。"9B 打赢谷歌翻译"这一结论,通常是指在 COMET 或类似语义指标上的均分超越,而非每个句子都更好。因此在特定领域或语言对上,不同模型的优劣关系可能会发生变化,结合自身业务场景的针对性测试仍然必要。
本地部署与格式支持
模型已全部在 Hugging Face 上开源,GitHub 仓库也可查到。得益于千问架构,原始功能都能在本地复现,B站给出了通过 vLLM 方式部署推理的方案。
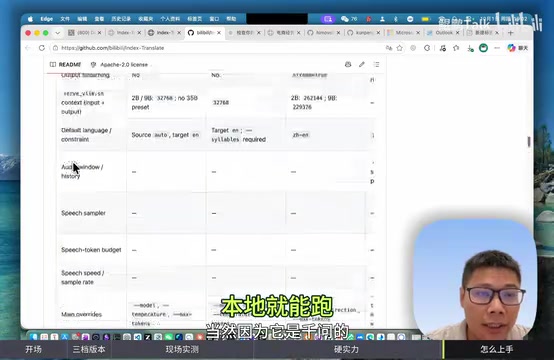
由于基座是千问,模型文件大小对熟悉该系列的用户并不陌生,社区很快会跟进 GGUF 等各种量化格式,届时普通笔记本也能本地运行,CPU 推理方案也在推进中。官网同时提供支持中文界面的在线体验,涵盖文本翻译、语音翻译、实时字幕、TTS 等完整功能。
vLLM 是目前主流的大模型推理加速框架,专为 GPU 集群上的高并发推理场景设计,核心技术是 PagedAttention——一种借鉴操作系统内存分页思想的 KV Cache 管理机制,可大幅提升 GPU 显存利用率和吞吐量。GGUF 则是面向边缘设备和消费级硬件的量化格式,由 llama.cpp 项目主导,支持将模型权重压缩到 4-bit 乃至更低精度,使普通笔记本的 CPU 或集成显卡也能运行十亿参数级别的模型。两种部署路径覆盖了从云端高并发服务到本地离线推理的不同需求,这对有数据合规要求、不能把内容传送到外部 API 的企业用户尤为重要。
小结
Index-Translate 的价值不在于单纯刷高翻译分数,而在于把“工程可用性”作为核心目标:JSON 稳定输出、数字与术语处理、150 语言覆盖、本地可部署,这些恰恰是过去让企业翻译项目反复踩坑的环节。对于需要把翻译真正嵌入生产系统的团队,这类开源模型降低了自建工程的门槛,值得按实际场景做一轮验证。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。