CAMP-II:用文件操作释放编码代理的长程记忆潜力
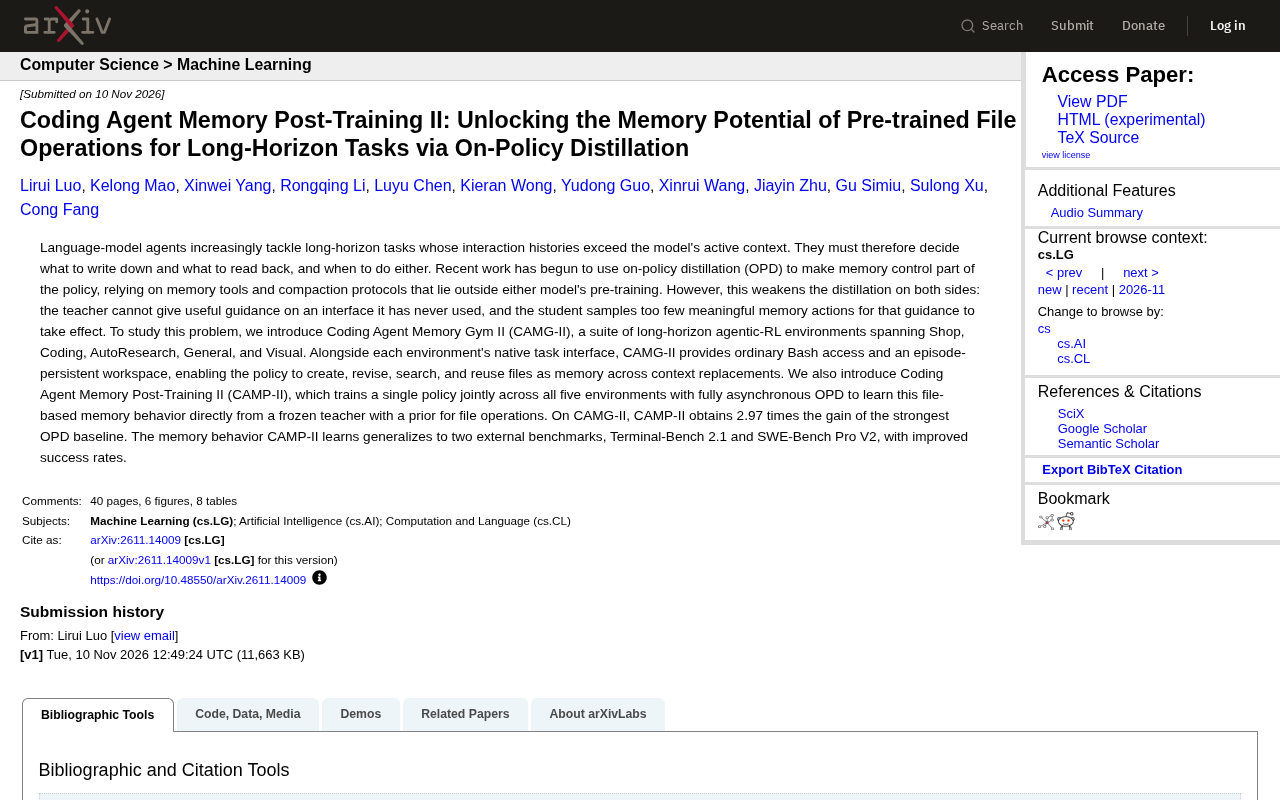
CAMP-II 用文件操作先验承载代理记忆,经异步 OPD 训练,增益达基线 2.97 倍并可迁移。
长程代理的交互历史会超出上下文窗口,代理需自主决定记忆的写读时机。现有用 OPD 训练记忆行为的方法面临冷启动困境:记忆工具与压缩协议不在预训练分布内,老师给不出有效指导,学生也采样不到足够的有意义记忆动作。CAMP-II 转而将记忆接口锚定在预训练已大量接触的 Bash 与文件操作上,构建覆盖五类长程环境的 CAMG-II,并用冻结的文件先验老师以完全异步 OPD 联合训练单一策略。结果显示其在 CAMG-II 上的增益达最强 OPD 基线的 2.97 倍,并迁移到 Terminal-Bench 2.1 与 SWE-Bench Pro V2。核心启示是:记忆接口应落在模型能力分布之内,而非追求全新精巧的工具设计。
长程任务正在成为语言模型代理的主战场,但一个根本矛盾始终存在:交互历史会迅速超出模型的活跃上下文窗口。代理必须学会自己决定写什么、读什么、何时执行这些操作。最近一项研究提出 Coding Agent Memory Post-Training II(CAMP-II),尝试用文件操作这一预训练中已有的能力来承载记忆,并通过在策略蒸馏(On-Policy Distillation, OPD)训练代理掌握这一行为。
现有记忆方案的瓶颈:工具与协议在预训练分布之外
近期有工作开始用 OPD 把记忆控制纳入策略本身,让模型在训练中学会调用记忆工具、执行压缩协议。问题在于,这些工具和协议并不在任何一个模型的预训练分布之内——老师模型从未用过这样的接口,自然给不出有效指导;学生模型在训练中采样到的有意义记忆动作又太少,不足以让这份指导真正生效。两边同时被削弱,蒸馏效果大打折扣。
这构成了一个典型的冷启动困境:记忆行为需要被教会,但教学所依赖的接口本身是陌生的。
On-Policy Distillation(同策略蒸馏) 是一种知识蒸馏变体,其关键特征是学生模型在训练过程中用自己的策略采样轨迹,老师模型再对这些学生实际访问到的状态给出监督信号。与离线蒸馏使用固定数据集不同,OPD 的监督分布随学生策略演化而动态变化,因此对老师能否在学生采样到的状态上给出有效指导高度敏感。若学生由于接口陌生而几乎不采样到有意义的记忆动作,老师就缺少可标注的状态;反之,若老师本身不熟悉该接口,即使状态出现也难以给出正确目标。这一机制解释了文中冷启动困境的根源:蒸馏效果同时取决于学生采样覆盖与老师在该覆盖上的能力。
CAMG-II:五类长程环境与纯 Bash 记忆接口
为了系统研究这个问题,研究团队构建了 Coding Agent Memory Gym II(CAMG-II),覆盖 Shop、Coding、AutoResearch、General、Visual 五类长程代理强化学习环境。
每个环境除原生任务接口外,还提供普通 Bash 访问和一个贯穿整个 episode 的持久化工作区。代理可以创建、修改、搜索、复用文件,把文件系统当作跨上下文替换的记忆载体。这一设计的关键在于:Bash 和文件操作是模型预训练阶段就大量接触过的,天然具备先验,不需要从零学习陌生工具。
CAMP-II:用文件先验冻结老师,异步 OPD 训练学生
CAMP-II 的核心思路是把预训练的文件操作先验变成教学资源。它使用一个冻结的、具备文件操作先验的老师模型,在全部五个环境中以完全异步的 OPD 联合训练单一策略,直接从老师那里学习基于文件的记忆行为。
由于接口落在老师的舒适区内,指导信号更有效;异步训练则让跨环境、跨轨迹的采样效率得到保障,学生能积累足够多的有意义记忆动作。
异步 OPD 指学生采样与老师打分/蒸馏更新不在同一条同步流水线上执行,而是由不同进程或不同环境实例并行推进,再通过缓冲或参数服务器交换数据。在跨五个异构环境联合训练单一策略时,各环境 episode 长度与任务节奏差异很大,同步训练会被最慢环境拖住。异步化让各环境独立采样、持续产出轨迹,学生参数更新与老师前向解耦,从而提升跨环境、跨轨迹的样本吞吐。代价是存在一定的策略滞后(stale policy)问题,需要通过缓冲管理和更新频率控制来缓解。
实验结果:增益显著,且可迁移到外部基准
在 CAMG-II 上,CAMP-II 取得的增益是最强 OPD 基线的 2.97 倍。更值得关注的是迁移性:学到的记忆行为泛化到了 Terminal-Bench 2.1 和 SWE-Bench Pro V2 两个外部基准,成功率均有提升。
这一结果说明,基于文件的记忆不是一个只对特定环境过拟合的 trick,而是可以在不同任务形态之间迁移的通用能力。
Terminal-Bench 2.1 与 SWE-Bench Pro V2 是评估长程代理能力的两个外部基准。Terminal-Bench 侧重在真实终端环境中完成多步骤系统操作任务,强调命令行交互与状态管理;SWE-Bench Pro V2 则面向真实代码仓库的软件工程问题修复,要求代理在大型代码库中定位、修改并验证。两者都不是 CAMG-II 的训练环境,任务接口与任务形态均有差异,因此在其上的成功率提升可作为记忆行为是否过拟合训练环境的检验。这也正是文中强调迁移性的原因:若增益仅来自对 CAMG-II 特定接口的适配,外部基准上不应出现稳定提升。
启示:把记忆能力锚定在预训练已有技能上
CAMP-II 的价值不只是一组数字。它提示了一条更务实的长程代理训练路径:与其设计全新的记忆工具和压缩协议,不如把记忆接口锚定在模型已经熟练掌握的能力上,让蒸馏的老师和学生站在同一片熟悉的土地上。文件系统恰好是这样一个接口——通用、持久、且早就在预训练语料中反复出现。
对于正在构建长程代理的团队而言,这意味着评估记忆方案时不应只看接口设计是否精巧,更要看它是否落在模型的能力分布之内。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。