Canva发布首个自研文生图模型:更低成本、更高可控性

Canva推出首个自研图像生成模型,向所有用户开放,主打更优效果、可定制与低成本。
Canva 正式发布其首个自研图像生成模型,并向所有用户开放使用,标志着这家在线设计工具公司从 AI 能力的使用者转向底层生成能力的建设者。官方将卖点概括为三点:生成质量更接近可用素材、对生成过程的控制粒度更细、使用成本更低。文章分析认为,设计平台自研模型有其必然性——通用文生图模型难以满足版式约束、品牌规范与可编辑图层等设计场景需求,而自研还能在推理开销上获得优化空间。对普通用户而言,图像生成将从附加功能变为默认选项;对行业而言,生成能力正从差异化卖点演变为基础设施。不过 Canva 未披露模型架构与训练细节,实际能力仍待规模化使用验证。
Canva 正式推出其首个自研图像生成模型,并向所有用户开放使用。这一动作意味着这家以在线设计工具起家的公司,不再只做模型的使用者,而是开始向底层生成能力延伸。
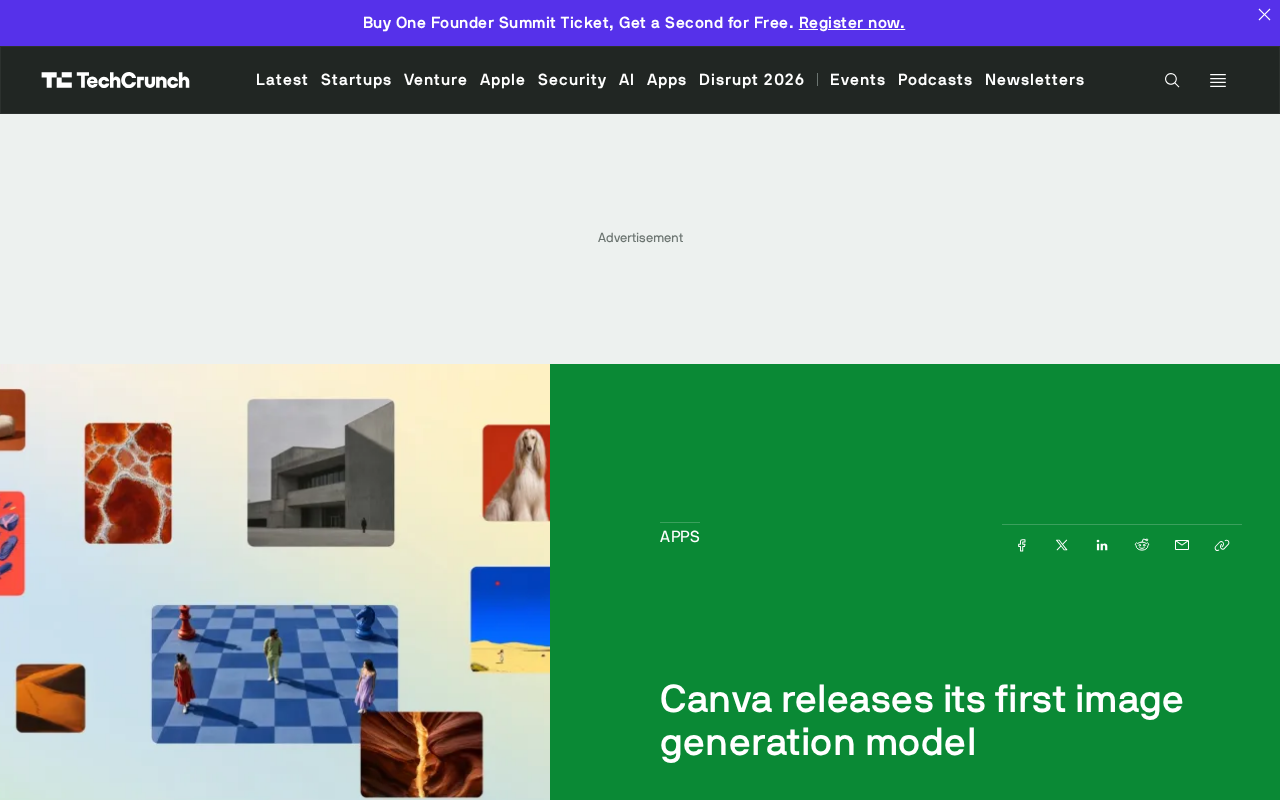
从设计工具到模型自研:Canva 的一步跨越
Canva 多年来通过模板化设计降低了普通人做视觉内容的门槛,其产品中的 AI 功能此前多依赖外部模型或合作方能力。此次推出自有图像生成模型,是 Canva 在生成式 AI 链路上向上游走的关键一步。
官方给出的定位很直接:所有用户都可使用,且在效果、可定制性和成本三个维度上同时做出承诺。对一个用户基数庞大的设计平台来说,把推理成本压下来,是让图像生成从"尝鲜功能"变成"日常功能"的前提。
文生图模型(Text-to-Image Model) 是一类以文本提示为输入、直接输出图像的生成式 AI 模型,通常基于扩散模型(Diffusion Model)或自回归 Transformer 架构。扩散模型的原理是先从纯噪声出发,通过多步去噪过程逐步还原出符合文本语义的图像;训练时则向真实图片逐步加噪,让模型学习逆向的去噪路径。近年来主流文生图模型(如 Stable Diffusion、Midjourney、DALL·E 系列)多采用潜在扩散(Latent Diffusion)方案,即在压缩后的潜空间内完成去噪,从而大幅降低算力开销。对平台型公司而言,是否自研这类模型,决定了它能否在推理成本、输出风格和领域适配上有自主调整空间。
三个关键词:更好、更可定制、更便宜
根据 Canva 的说法,新模型的核心卖点集中在三点:
- 质量提升:生成结果在整体观感上更贴近可用素材,而非单纯的演示级输出;
- 可定制性:用户对生成过程的控制粒度更细,这贴合设计场景中对构图、风格、元素位置的实际需求;
- 成本下降:官方强调更低的使用成本,这对高频使用设计工具的用户群体意义明显。
这三点的组合并不意外。设计类用户与通用聊天用户不同,他们往往需要反复调整同一张图,单次生成成本乘以迭代次数,才是真实的使用门槛。
为什么设计平台必须自己做模型
通用文生图模型能力已经相当成熟,但设计平台的需求有特殊性。模板、品牌规范、尺寸规格、可编辑图层,这些要素决定了平台不能只做一个"生成一张图然后下载"的管道。
自有模型让平台可以在训练和推理环节针对设计场景做优化,比如更稳定地遵循版式约束,或让生成结果更容易与后续编辑流程衔接。Canva 强调的"可定制性",很大程度上指向的正是这一层能力,而不只是提示词层面的微调。
另一个现实考量是成本结构。当图像生成成为平台的基础功能而非付费增值项,推理开销会直接压在平台的毛利上。自研模型给了平台优化成本的空间,这也是官方把"更低成本"与"更好性能"并列宣传的原因。
推理成本(Inference Cost) 指模型完成一次生成请求所消耗的算力开销,与训练成本不同,它随用户使用量线性增长,是平台长期运营中的持续性支出。图像生成的推理成本尤其高,因为扩散模型需要多步迭代去噪,单张图往往涉及数十次神经网络前向计算,分辨率越高、步数越多,开销越大。当生成功能面向海量免费用户开放时,单次成本乘以调用次数会直接侵蚀毛利。业界常用的降本手段包括模型蒸馏、减少采样步数、使用更小的潜空间分辨率,以及在专用加速硬件上做推理优化。这也解释了为何平台自研模型时,常把成本控制与效果提升放在同等重要的位置宣传。
可编辑图层与版式约束 是设计工具区别于通用文生图产品的关键。传统文生图输出的是扁平化位图,用户拿到后难以拆分元素、调整文字或替换局部素材;而设计工作流要求生成结果具备图层结构、可选中对象和可继承的品牌样式。让模型输出结构化、可编辑的结果,通常需要在生成阶段引入布局控制、分割掩码或与矢量/图层格式的对接机制,这已超出通用模型的默认能力范围。平台自研模型的价值之一,就是能把这类“生成即素材”的约束直接编码进训练与推理流程,使生成结果可无缝进入后续编辑环节,而不是停留在一次性出图的演示层面。
对普通用户和设计生态的影响
对普通用户而言,最直接的变化是图像生成能力从"额外功能"变成平台内的默认选项,使用门槛进一步降低。对专业设计者来说,值得观察的是这套模型与现有编辑工作流的衔接深度——生成结果能否保留可编辑性,往往比单张图的精美程度更重要。
对整个设计工具赛道而言,Canva 自研模型释放的信号比较清晰:生成能力正在从差异化卖点变成基础设施,工具层公司要么自建、要么深度绑定模型方,中间地带会越来越窄。
Canva 并未在此次发布中披露模型的具体架构、训练数据规模或参数细节,这些信息的缺失也让外界难以对其真实能力水平做出独立判断。模型的实际表现,还需要等用户规模化的真实使用反馈来验证。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。