Cerebras CS-4震撼发布:4万亿晶体管的晶圆怪兽,推理速度碾压GPU
Cerebras发布晶圆级引擎CS-4,以模块化部署和近存计算挑战GPU推理霸权。
Cerebras发布新一代晶圆级引擎系统CS-4,单芯片集成4万亿晶体管和90万个AI优化核心,官方称推理速度比GPU方案快一个数量级。系统由电源机架和计算背包两个模块化组件构成,电力与冷却先于算力就绪,几分钟即可完成部署。CS-4采用3D垂直堆叠,电源转换器直接置于晶圆上,供电路径从约50毫米缩短至半毫米,功率提升一倍;每个AI核心配备专用内存并紧邻逻辑电路,以近存计算缩短数据传输距离。模块化架构支持并行制造与后续迭代,官方称性能翻倍、组件数量减半。不过,晶圆级路线对制造、封装和散热要求极高,软件生态成熟度仍是现实挑战,其性能结论也尚待第三方基准测试验证。
当一块晶圆变成一个数据中心
在AI算力竞赛进入白热化的当下,Cerebras发布了其最新一代晶圆级引擎系统CS-4。官方给出的数字足够惊人:单颗芯片集成4万亿晶体管和90万个AI优化核心,推理速度比GPU解决方案快一个数量级——原始标题里那个"30倍"的说法,大致就来自这个"一个数量级"的描述。
据B站UP主的视频解读,CS-4的定位非常明确:专为在超大规模数据中心部署高速AI推理而打造。它的设计哲学围绕两个原则展开——从晶圆中榨取更多性能,同时让构建、部署和扩展都变得更简单。
这种"既快又简单"的追求,恰恰戳中了当前AI基础设施的痛点:性能提升往往伴随着系统复杂度的指数级上升。Cerebras的答案是把复杂度藏进模块化设计里。
**晶圆级引擎(Wafer-Scale Engine, WSE)**是一种将整片晶圆作为一个完整芯片来设计和制造的处理器架构,而不是像传统做法那样把晶圆切割成数百颗独立芯片再封装。其核心挑战在于:晶圆上难免存在制造缺陷,若按常规切割,任何缺陷都可能报废整颗芯片;Cerebras的解法是在设计时加入冗余核心和可重构互连,使芯片在部分核心失效时仍能通过片上网络绕过缺陷继续工作。此外,整片晶圆面积远大于单颗芯片,功耗和散热密度极高,必须依赖特殊封装与液冷方案。正因如此,晶圆级引擎才能在一块硅片上集成数十万级核心与海量片上内存,从根本上改变互连与内存访问的物理距离。
电源机架 + 计算背包:把超算部署变成"插积木"
CS-4由两个模块化组件构成:电源机架和计算背包。
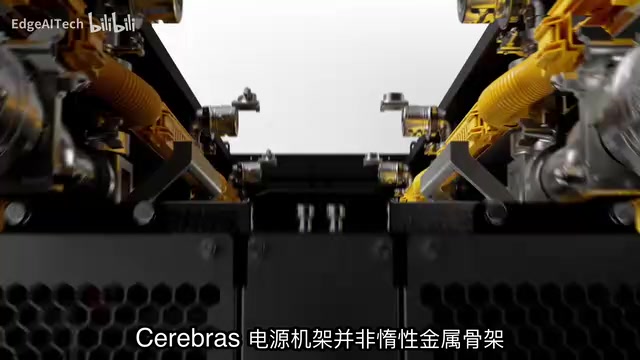
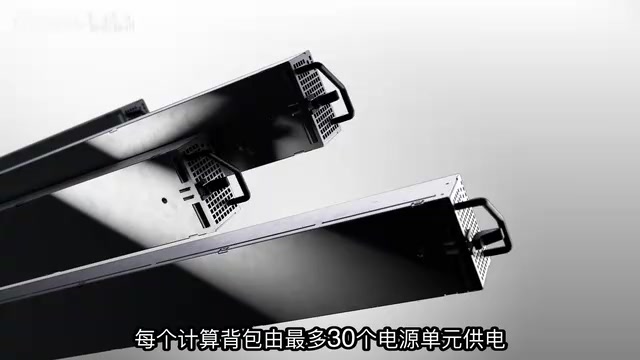
电源机架不是传统意义上的惰性金属骨架,它承担着供电、冷却水输送和网络基础设施的职能。每个计算背包最多由30个电源单元供电,机架以高达480伏的交流电输入,每个单元将其转换为54.5伏的直流电,供给晶圆所需的低压直流电。
这种设计的关键在于解耦:电源机架可以在计算背包并行制造的同时进行构建、测试和部署。也就是说,电力和冷却在算力到达之前就已就绪,从安装到推理的整个过程大幅提速。
计算背包则是紧凑型计算系统,每个背包内含一颗晶圆级引擎,以及使其以峰值效率运行所需的电源、冷却和IO接口。部署超算的复杂性被简化为"把计算背包安装到电源机架上"——模块化部署大规模AI集群,听起来就像在机房里插积木。
据视频介绍,电力、冷却水和数据连接均为自动完成,完整的CS-4可以在几分钟内上线,而不是几天。
3D垂直堆叠与半毫米供电:从硅片里榨性能
CS-4没有采用传统GPU板卡的平面布局,而是把组件垂直堆叠成3D结构。晶圆背后是一块铜质冷板,通过通道循环冷却水带走晶圆产生的热量;晶圆前方则是紧凑的电源转换器,直接将能量输送到计算单元中。
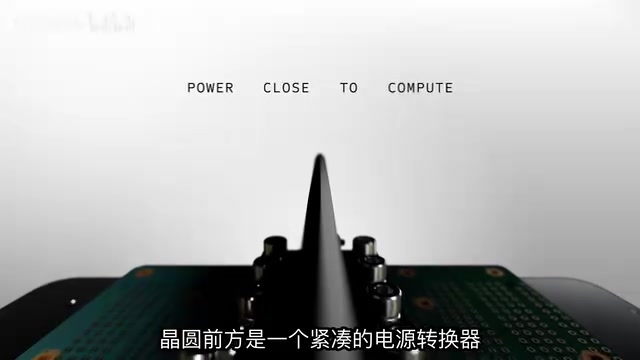
这里有个值得注意的工程细节:传统GPU板卡上,从电源转换器到处理器的电路路径大约为50毫米,而CS-4把电源转换器直接放在晶圆上,将这一距离缩短至半毫米,几乎消除了电力损耗。新的电源架构将输送到晶圆上的功率提升了一倍,从而支持更高的运行频率和更快的token生成速度。
在散热与供电这两个传统上制约芯片性能的环节上做文章,而不是单纯堆叠计算单元,这是Cerebras与GPU路线最本质的分野之一。
供电距离与电力损耗:在传统GPU板卡上,电源转换器(VRM)与处理器之间通常有数十毫米的PCB走线,电流在此路径上会产生电阻损耗(I²R损耗)和电压降,限制了大电流下的供电效率。Cerebras将电源转换器直接集成到晶圆表面,把供电路径缩短到半毫米量级,显著降低了损耗,并允许在相同电压下输送更大电流,从而支撑更高频率和更强算力。这种“供电贴近负载”的思路与3D堆叠、液冷一起,构成了晶圆级系统在物理层面的工程创新。
90万核心与内存近计算:GPU架构的另一种答案
全球最大的计算机芯片位于每个计算背包的核心。单个硅片上集成了90万个AI优化核心,通过纳米级导线连接——相比之下,GPU系统需要数千根电缆来完成互连。
内存架构是另一处关键差异。每个AI核心都拥有自己专用的内存,直接构建在使用它的逻辑电路旁边。将内存紧邻计算单元放置,大幅缩短了数据必须传输的距离,从而提供高带宽,实现最快的AI性能。
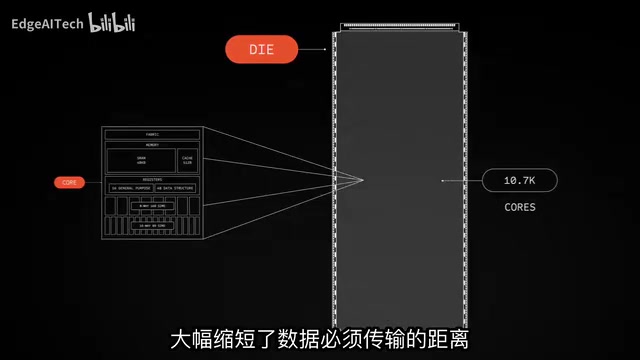
这正是"近存计算"思路的极致体现。当GPU集群为内存墙和互连带宽焦头烂额时,晶圆级集成把整个内存层级压缩到了一块硅片上。
**近存计算(Near-Memory Computing)**指将计算单元尽可能靠近存储数据的内存放置,以缩短数据搬运距离、降低延迟和能耗。在传统冯·诺依曼架构中,处理器与内存之间的数据搬运被称为“内存墙”,其带宽和功耗往往成为性能瓶颈。GPU虽然通过高带宽显存缓解了部分问题,但计算核心与显存之间仍需经过复杂的互连层级。晶圆级引擎把每个AI核心的专用内存直接构建在逻辑电路旁边,相当于把“内存墙”压缩到片上微米级距离,从而在带宽和能效上取得优势,这也是其推理速度宣称领先的架构基础之一。
性能翻倍、组件减半:模块化架构的长期账
Cerebras官方对CS-4的总结是:性能提升至两倍,组件数量减半。通过简化基础设施,CS-4瞄准的是下一代超高速推理场景。
更值得关注的是架构的可延续性。电源和冷却系统已为组件做好准备,同一套模块化架构使CS-4更易于维护、更易于扩展,并为未来几代晶圆级引擎预留了空间。换句话说,Cerebras卖的不只是一台机器,而是一个可以持续迭代的部署平台。
对于正在规划大规模推理集群的数据中心而言,这种"基础设施先行、算力后到"的模式,可能比单纯的性能数字更有吸引力。
晶圆级路线能否撼动GPU霸权?
从公开信息看,CS-4在推理速度、部署简化和能效路径上都给出了与GPU截然不同的答案。但需要冷静看待的是:晶圆级引擎对制造、封装和散热的要求极高,生态与软件栈的成熟度也是横亘在前的现实问题。
视频内容主要基于官方发布材料,缺少第三方基准测试的交叉验证。"快一个数量级"的结论在何种模型、何种负载下成立,仍有待实际部署数据检验。
可以确定的是,AI推理的算力供给正在从单一架构走向多元竞争。Cerebras CS-4的出现,至少证明了晶圆级集成这条路已经走到了可以规模化部署的阶段——而这对整个行业来说,本身就是个值得关注的信号。
相关推荐
Dioxus 全栈生产环境一年实践:收获与痛点
一位开发者分享 Dioxus 全栈框架在生产环境运行一年的真实体验,涵盖全栈 Rust 的类型安全收益、编译时间与生态成熟度等痛点,为技术选型提供参考。
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。