AI智能体架构拆解:从对话到自动化的工程实践指南

很多人对AI的认知还停留在网页聊天窗口:输入一句话,等它吐出一段回答。但真正让AI具备生产力价值的,是**智能体(Agent)**架构。本文系统拆解AI智能体的四层工程化设计逻辑——从底层运行范式到全链路自动化生态,帮你在看任何AI产品时都能一眼看透其运转机制。
从响应式模型到闭环智能体
我们平时用的ChatGPT、豆包、DeepSeek广告,本质上都是响应式模型:你输入什么,它吐出什么,非常被动,需要不断喂资料才能顺着话往下聊。而智能体的逻辑完全不同——它是一个闭环系统。
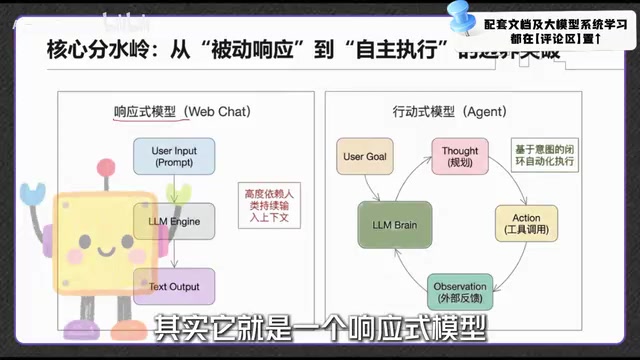
给智能体一个大目标(比如"帮我定行程"),它会自己思考第一步做什么、第二步用什么工具、执行完再检查结果,不满意就调整重来。这就像给助理下一个指令,它自己忙活直到把事办成,而不是你问一句它答一句。
智能体的三大核心要素
可以把大模型理解成整个系统的CPU,为了让它真正干活,需要三个模块配合:
- 规划(Planning):拆解任务的"脑回路",把模糊指令转化为具体动作
- 记忆(Memory):存储上下文与历史经验,无需反复叮嘱
- 工具调用(Tool Use):Agent的"手脚",能连网、调API、访问数据库
以"竞品调研并写报告"为例,在ReAct模式下,智能体会分三步走:先作为探索者去网上抓取数据,再作为分析师清洗筛选信息,最后作为写作者整理成报告。每个阶段职责和权限都不同——把模糊指令转化为具体执行步骤,正是当下AI工程实践最看重的核心能力。
ReAct模式背景:ReAct(Reasoning + Acting)是由谷歌研究团队于2022年提出的智能体推理范式,核心思想是将"思考链"与"行动执行"交织进行——模型不是先想完再做,而是边想边做边观察结果,每一步行动后的反馈都会影响下一步的推理。这种设计解决了纯思考模式"空想不落地"和纯执行模式"执行不反思"的双重缺陷,让智能体具备了类似人类解决复杂问题时的迭代调试能力。目前主流的智能体框架如LangChain、AutoGen都以ReAct或其变体作为默认的推理引擎。
API生态与成本工程
智能体这个"大脑"要调用外部能力,就得靠API。可以把API理解成AI世界的通用货币:Agent发送请求并附上API Key身份凭证,经网关层验证合法性与额度后转给后台模型,模型运算完毕再返回结果。
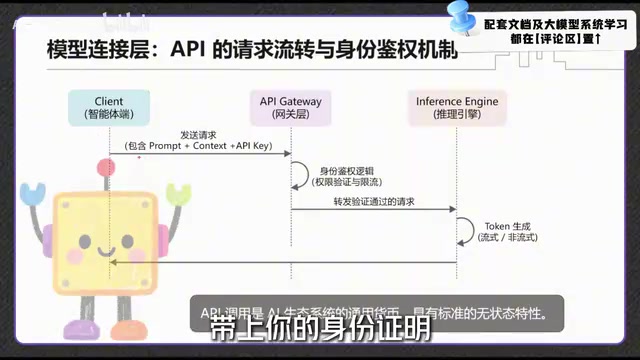
这是一个标准的无状态请求-响应过程——模型不记得上一次的对话内容,每次调用都是全新握手。
无状态API与会话管理:HTTP协议天然是无状态的,服务器不保留任何客户端的历史请求信息。对于大语言模型API而言,这意味着每次发送请求时,必须把所有相关的上下文历史一并塞入请求体,模型才能"记住"之前说了什么。这种设计大幅简化了服务端架构,但也带来了Token消耗随对话轮次线性增长的问题。实际工程中,开发者通常采用滑动窗口保留最近N轮对话、对历史内容做摘要压缩、或者借助向量数据库实现语义检索式的"长期记忆",以在上下文完整性与成本控制之间取得平衡。
模型不是越大越好
成本工程的核心在于:按任务复杂度动态路由模型。
- 简单分类、路由分发 → 用7B/8B小模型,速度快、成本极低
- 复杂代码生成、深度分析 → 才调用中大模型
一个务实的建议:不必死盯国外昂贵模型,国产的DeepSeek、通义千问广告等能力已相当强悍,性价比突出。简单任务走小模型、复杂任务走大模型,月度账单会好看很多。
追求"跑得稳"而非"跑得通"
工程实践中,网络波动、API超时、Token溢出都是常态。通过一个config.json配置改个端口,就能把调用Claude的代码无缝切换到DeepSeek——相当于"换了个加油站"。
但真正关键的是异常处理逻辑:握手失败要自动切换备用模型,请求超时、Token溢出要有自动截断或摘要机制。像GitHub上的开源中间件CC Switch,已经把这些熔断回退逻辑封装完毕,无需自己从头编写繁琐的判断代码。
MCP协议:让智能体从偏科生变全能选手
装好大脑、接上能源后,你会发现Agent还是个"偏科生"——遇到复杂文档或需要联网搜索时依然束手无策,因为它缺乏标准化的连接路径。解决方案就是MCP(Model Context Protocol,模型上下文协议)。
从点对点混乱到标准化接口
传统的Point-to-Point连接模式代价高昂:每增加一个工具,就得专门编写一套对接代码,工具越多代码越乱,维护困难且Agent容易"消化不良"。
MCP则像一个万能转换接口。Agent不需要了解数据库底层逻辑或网页代码细节,只需对着MCP这个"中间商"发出指令,实现一次开发、随处调用。
MCP协议的行业意义:MCP由Anthropic公司于2024年11月正式开源发布,设计目标是成为AI工具集成领域的"USB-C接口"——一个统一标准,让任何AI模型都能以同样的方式连接任何外部工具或数据源。在MCP出现之前,市场上存在LangChain Tools、OpenAI Function Calling、各家自研插件系统等多套互不兼容的集成规范,形成严重的生态碎片化。MCP采用JSON-RPC 2.0作为通信基础,定义了Resources(资源)、Tools(工具)、Prompts(提示模板)三类标准能力接口。目前微软、谷歌、Block等主流科技公司已陆续宣布支持MCP,这一协议正在快速成为智能体工具集成的事实标准,其生态价值可类比于Web领域的REST API规范。
MCP的三步工作流
- 协议握手:Agent主动询问MCP服务器的可用能力,MCP返回一份完整的技能清单
- 格式转换:像翻译官一样,把杂乱的HTML源码转成模型可读的结构化文本
- 指令代理:Agent下达简洁命令,MCP执行外部操作并将结果回传
整个过程中,Agent始终不关心具体实现细节,只专注核心业务逻辑。目前GitHub上已有大量开源MCP服务器——查天气、读本地文件、对接各类API的组件应有尽有,把这些"插头"接入Agent,能力边界立刻大幅拓展。
Skill模块化封装:架构的灵魂
即便Agent能够正常运转,如果每次任务都要输入冗长的提示词来"教新员工",不仅效率低下,Agent也容易被绕晕、输出质量下降。
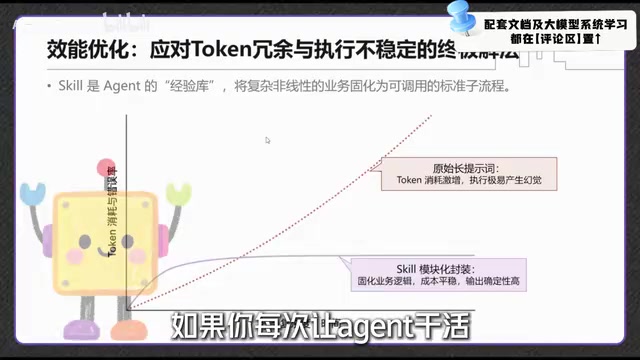
数据对比很直观:原始长提示词模式下,任务越复杂Token消耗越高、准确率反而下滑;引入Skill(将高频、高难度的业务逻辑封装成固定"经验包")后,性能曲线明显趋于平稳——相当于给Agent配了一本操作手册,遇到同类任务直接查手册执行,既省Token又稳定可靠。
Skill封装与提示词工程:Skill本质上是一种结构化的提示词工程(Prompt Engineering)实践,与软件工程中的"函数封装"高度同构。裸提示词(Raw Prompt)的问题在于:随着任务复杂度上升,提示词长度膨胀会触发大模型的"注意力稀释"效应——超长上下文中,模型对中间部分的信息关注度显著下降,这一现象在学术上被称为"Lost in the Middle"问题(斯坦福2023年论文有专门研究)。通过Skill将任务分解为小颗粒度的固定模块,每次调用只注入必要上下文,既规避了注意力稀释,又通过固定的System Prompt边界让模型输出格式更稳定可预期。这与软件工程中的"单一职责原则"不谋而合:一个Skill只做一件事,做好一件事。
模块化的防御性设计
设计一个高质量Skill需要把握三个要点:
- 输入规范:明确参数格式与必填项,从源头拦截大部分低级错误
- 过程约束:用System Prompt固化业务流程,每一步的动作与输出格式都提前划定边界
- 异常捕获(最关键):报错时不能卡死流程,要有自动重试或跳过机制,相当于为Agent装上安全保护罩
构建自动化生产线
将所有模块串联起来,就形成了一条真正的自动化生产线:左侧是Skill经验库,中间是大脑模型,右侧是MCP连接的各类外部工具。这不仅是任务执行,更是一个持续反馈的闭环——效果好的执行路径记录沉淀,出现错误就修正对应的Skill逻辑。通过持续迭代,Agent会越来越稳定,自动化覆盖范围也随之不断扩大。
结语:构建Agent像搭乐高
回顾整套架构:模型(大脑)→ API(能源)→ MCP(扩展能力边界)→ Skill(培养熟练工),构建AI智能体并没有想象中那么神秘,更像是搭乐高积木的过程。
你不需要是技术大牛,只要能把日常工作中最繁琐的重复性任务,一个个封装成Skill,慢慢就会拥有一个属于自己的、全天候运转的"数字员工"。理解了这套架构逻辑,面对任何AI产品,你都能看透它的运转本质。
核心要点
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。