拆解Claude Code与Codex:AI编程Agent循环的内部机制

拆解Claude Code与OpenAI Codex背后的Agent循环:工具调用、上下文管理、权限沙箱与子代理机制全解析。
AI编程助手的核心是"语言模型+执行外壳"的Agent循环:模型发出结构化工具调用,外壳执行并回传结果,如此循环直到模型不再请求工具。这一机制源于ReAct框架的"思考—行动—观察"模式,并在Claude Code和OpenAI Codex中有高度一致的实现。面对远超上下文窗口的真实代码库,Agent采用先搜索再按需读取的策略,并以压缩(将历史替换为摘要)控制token开销。权限模式与操作系统沙箱(macOS用Seatbelt,Linux用Bubblewrap)构成两套独立的安全控制,子代理则通过在独立上下文中处理复杂子任务、只向父代理返回摘要,实现了对庞大中间过程的有效隔离。SWE-bench以真实GitHub issue为评测任务,量化了Agent修复实际软件缺陷的能力。
AI编程助手到底是如何工作的
当你让Claude Code或OpenAI的Codex修复一个bug时,背后发生的事情远比"问个问题得个答案"复杂。根据Anthropic官方对Claude Code的文档,以及OpenAI公开的Codex源代码,这两款工具本质上都是语言模型加一层执行外壳(harness)的组合:模型负责提出要做的动作,外壳负责真正去执行,然后把结果喂回模型,如此循环往复,直到模型不再请求调用任何工具为止。
这篇文章基于一段YouTube技术讲解,结合两家厂商的公开资料,拆解这套"Agent循环"的每一个环节——从工具调用、循环控制,到上下文管理、权限沙箱,再到子代理与评测基准。
工具调用:模型本身什么都做不了
Claude Code的文档明确指出:没有工具的情况下,模型只能回复文本。真正让它具备"行动力"的,是两家API都支持的工具调用(tool calling)机制。
应用程序会用三个要素描述每个工具:名称、描述,以及一份规定输入格式的JSON schema。关键在于,模型从不自己执行任何操作——按Anthropic的文档,模型只是发出一个结构化请求(比如调用名为search的工具并附上搜索模式),由应用程序去实际运行,运行结束后再把工具结果回传给模型。
OpenAI的函数调用指南把这个往返过程拆成五步,最终以一个回复或更多工具调用收尾。两家厂商的做法在底层逻辑上高度一致。这种"思考—行动—观察"的交替模式,可以追溯到2023年ICLR上Shunyu Yao等人发表的ReAct论文,论文中特别指出:思考(thought)不改变环境,因此不产生观察(observation)。
ReAct(Reasoning + Acting)框架是理解现代编程Agent的重要背景。该论文的核心洞察在于,将语言模型的推理过程(Thought)与外部环境交互(Action)交织在一起,形成"思考→行动→观察"的闭环。与纯粹的链式思考(Chain-of-Thought)不同,ReAct中的思考步骤不会直接改变任何外部状态,只有Action才会触发工具执行并产生可观察的结果。这个设计使模型能够根据每一步的真实反馈动态调整后续计划,而不是一次性生成完整的操作序列。JSON Schema在工具定义中的作用也值得关注:它不仅规定了输入格式,还作为模型"理解"工具能力边界的契约——模型在训练中学会了如何根据Schema生成合法的调用参数,从而使工具调用具备可验证的结构化特性。
循环控制:什么时候停下来
整个Agent的核心是一个循环。Anthropic的文档把客户端循环描述为一个基于"停止原因"的while循环:只要停止原因是tool_use,就执行工具并继续;遇到其他停止原因就退出。
OpenAI的Agents SDK文档对其runner循环的描述几乎如出一辙——如果输出是没有工具调用的最终文本,运行结束;否则执行工具调用、追加结果、再次调用模型。为了防止无限循环,SDK源码设置了默认10轮的上限,超过就抛出名为max turns exceeded的错误。Anthropic的服务端工具循环同样有迭代上限。
在视频的玩具模拟中,这个保护机制体现得很直观:一个只会反复重跑测试、从不修复代码的策略永远无法完成任务,于是外壳在第10次调用时强制终止了它。
一次真实修复:6次模型调用的全过程
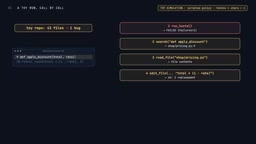
模拟中的玩具仓库有43个文件和一个bug——一个折扣函数错误地乘以折扣率,而不是乘以"1减折扣率"。整个修复过程清晰展示了循环如何运转:
- 调用1:运行测试,失败,错误信息点名了
applyDiscount函数 - 调用2:搜索该函数,定位到
pricing.py第9行 - 调用3、4:读取文件,编辑第10行的return语句
- 调用5:再次运行测试,通过
- 调用6:返回纯文本、无工具调用,循环停止
整个过程用了6次模型调用、5次工具调用。更值得关注的是上下文的膨胀:首次调用约300个估算token(主要是固定的系统提示和工具定义),到第6次调用时上下文已增长到约870个token。由于玩具循环每次都把完整对话重新发送一遍,6次调用总共发送了约3700个token——这正是真实场景中成本和延迟的来源。
上下文管理:当代码库塞不进窗口
真实项目的规模让"把所有代码读进来"变得不可能。SWE-bench论文报告,其任务仓库平均有43.8万行代码,远超模型的上下文窗口。即便在只有43个文件的玩具仓库中,读取每个文件也要约1.5万token,是Agent最终上下文的17倍。所以Agent的策略是先搜索、只读必要的那一个文件。
当接近上下文上限时,两家都有应对手段。Claude Code的文档描述它会先清除较旧的工具输出,必要时再对对话进行摘要;Codex源码则定义了一个触发自动压缩(compaction)的token阈值,压缩就是用摘要替换历史记录。
模拟中的第二个任务读取了全部36个辅助模块:不压缩的话,上下文会在第35次调用时突破1.6万token的玩具窗口;而启用75%阈值的压缩后,上下文在第26次调用时从约1.24万token降到约3200,发送的总token量减少了约三分之一。
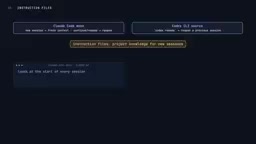
会话管理方面,Claude Code的每个新会话都从全新上下文窗口开始,继续或恢复会话则会重新打开此前的对话;Codex的命令行源码也描述了用于恢复交互会话的resume命令。两者都支持指令文件来承载项目知识:Claude.md在每个会话开始时加载,而Agents.md被定位为"给Agent看的README"——该格式源自OpenAI Codex、AMP、Google Jules、Cursor和Factory等多方协作,现由Agentic AI Foundation维护。
上下文窗口(Context Window)是语言模型单次能处理的最大token数量,超出这个限制模型就无法"看到"更早的内容。token是模型处理文本的基本单元,大致上英文每个单词约1-2个token,中文每个字约1-2个token,代码因含大量符号密度更高。以GPT-4o的128K token窗口为例,即便如此,43.8万行代码仍远超上限——这解释了为何Agent必须采用检索而非全量读入的策略。上下文压缩(Compaction)的本质是用较短的摘要替换较长的原始对话历史,代价是损失细节精度,换取继续处理更多轮次的能力。这与人类程序员在长时间工作后只记住关键结论、遗忘推导过程的认知机制颇为相似。压缩触发时机的选择(如75%阈值)直接影响任务成功率与API调用成本之间的权衡。
权限与沙箱:能做什么与敢做什么
Claude Code的文档和Codex源码都定义了两套彼此独立的控制:何时必须征求许可,以及命令在技术上能做什么。
Claude Code列出六种权限模式:Manual(文件编辑和shell命令前都询问)、Accept Edits(编辑文件不询问)、Plan(只探索和提方案,不改源码)、Auto(由分类器拦截高风险操作)、Don't Ask(拒绝一切会触发提示的操作),以及Bypass Permissions(文档说明仅用于隔离容器和虚拟机)。默认情况下,其Bash沙箱将权限限制在工作目录及相关目录内,不预先放行任何网络域名。
Codex源码则定义三种沙箱模式——Read Only、Workspace Write、Danger Full Access,以及On Request、Granular、Never三种审批策略。其默认预设是Workspace Write配On Request,网络访问默认关闭。底层上,两家在macOS都用Seatbelt、在Linux都用Bubblewrap做隔离。
Seatbelt(macOS)和Bubblewrap(Linux)是两款基于操作系统内核的沙箱工具,分别利用macOS的Sandbox框架和Linux的用户命名空间(User Namespace)与Seccomp机制实现进程隔离。它们的核心作用是限制进程可访问的文件系统路径、网络接口和系统调用,使得即便Agent意外生成了危险命令(如删除系统文件或外传数据),底层内核也会在执行层面拒绝该操作。这是"权限询问"之外的第二道防线——前者是软件层面的意图过滤,后者是操作系统层面的能力约束。两套控制独立运作意味着:即使用户选择了最宽松的权限模式(如Bypass Permissions),沙箱的硬性隔离仍然生效,这也是为何文档特别说明Bypass Permissions"仅用于隔离容器和虚拟机"——在那些环境中,容器本身已充当了外层沙箱。
子代理:把复杂任务分而治之
面对大型探索任务,两款工具都引入了子代理(subagent)机制。Claude Code的文档说明,每个子代理运行在自己的上下文窗口中,拥有独立的系统提示、工具访问权限和权限设置,只向父代理返回摘要。其内置子代理包括Explore、Plan和General Purpose。
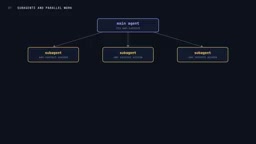
Codex源码定义的内置角色为Default、Explorer和Worker,其角色描述甚至鼓励并行派出多个Explorer。在模拟中,那个读取36个模块的调查任务被作为子代理运行——子代理在自己的上下文里做了38次模型调用,但当它返回时,父代理的上下文仅约370个token。这正是子代理的价值所在:把海量中间过程隔离在子上下文里,父上下文保持精简。
SWE-bench:衡量Agent能力的尺子
要客观评价这些工具,就离不开评测基准。SWE-bench由Carlos Jimenez等人于2024年在ICLR提出,包含来自12个Python仓库、2294个真实GitHub issue的任务。模型拿到issue和代码库,产出一个补丁,评测系统应用补丁并运行测试。
每个任务至少有一个"fail-to-pass"测试——修复前失败、修复后通过。按评分代码,只有当所有fail-to-pass测试通过、且所有原本通过的pass-to-pass测试仍然通过时,任务才算完全解决。原始论文中,Claude 2仅用检索(而非Agent循环)解决了1.96%的问题。后来维护者与OpenAI preparedness合作发布了SWE-bench Verified,这是经真实软件工程师确认可解的500道题子集。
SWE-bench的评测设计反映了软件工程任务的一个核心挑战:正确性的验证依赖已有测试套件,而非人工判断。"fail-to-pass"测试的要求确保了补丁真正修复了问题,"pass-to-pass"测试的要求则防止了"为了通过新测试而破坏已有功能"的过拟合解法。这种双重约束使SWE-bench比单纯的代码生成基准更接近真实工程场景。SWE-bench Verified子集的意义在于过滤掉了原始数据集中那些因题目描述模糊或本身存在缺陷而导致人类工程师也难以解决的问题,使评测结果更能反映模型的真实能力上限而非噪声。从Claude 2的1.96%到当前顶级Agent系统超过50%的解决率,这一跨度也直观展示了Agent循环机制相较于单次检索方式的巨大能力提升。
一句话总结Agent循环
按两家厂商的文档,一个编程Agent就是包裹在执行外壳里的语言模型:模型发出结构化工具调用,外壳执行并返回结果,循环重复直到模型不再调用工具。SDK设有默认轮次上限,压缩和子代理负责管理上下文,指令文件向上下文注入文本,权限与沙箱则由外壳强制执行。
理解了这套循环,再去看MCP(模型上下文协议)这类连接Agent与外部工具的标准,就会清晰许多——那也是这个主题值得继续深入的方向。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。