拆解DeepSeek Super Agent:真正狠的不是AI指挥AI

DeepSeek Super Agent 是研究原型,用 Router-Worker 两层架构和三层过滤机制节省人类注意力。
DeepSeek 的 Super Agent 并非正式产品,而是研究原型,官方 README 明确标注仅供参考。其核心价值不在于“AI 指挥 AI”的噱头,而在于用极简的两层架构(Router 和 Worker)将人的注意力从消息洪流中解放出来。Router 负责接收消息、记录上下文和派活,不写代码;Worker 独立承接每张工单,拥有独立环境和完整工具。消息进门前经过三道筛子(来源、授权、模型判断),过滤掉绝大多数噪音。工单直通机制让后续消息直接进入 Worker,省去 Router 绕路,对照实验显示 Router 决定数减少约 30%,Token 消耗降低约 37%。任务完成时间第 95 百分位从 29.5 分钟降至 15.7 分钟,但仅测调度协作,不测代码质量。文章还澄清了代码中未实现推测执行、链式记忆等特性,强调第一原则是用最少的人类注意力换最大的价值。
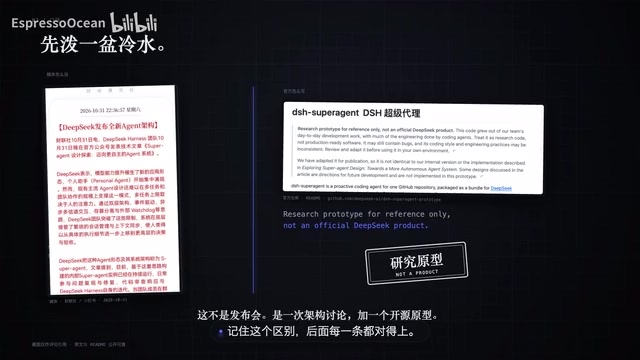
DeepSeek 的 Super Agent 最近被不少媒体解读为“全新 Agent 架构发布”,但官方 README 第一行就写着:研究原型,仅供参考,不是 DeepSeek 的正式产品。代码里实现的是一部分,文章里描述的是方向。把路线图当交付,是两回事。
真正值得看的,不是“AI 指挥 AI”这个噱头,而是它如何用一层架构把人的注意力从消息洪流里捞出来。
架构只有两层:Router 和 Worker
Super Agent 的架构非常克制,只有 Router 和 Worker 两层。Router 负责向前台接收消息、记录上下文、派活;它不写代码。代码里主绘画有 14 个应用工具,但没有 Write、Edit、Blob、Grab,也没有 Subagent。Worker 则向后承接每张工单:一个独立绘画、一个独立目录、一套完整工程工具。
一个负责决定做什么,一个负责真正做完。职责边界清晰,反而让系统更稳。
多智能体架构中的 Router–Worker 模式:这是一种常见的任务编排范式,核心思想是将“决策”与“执行”分离。Router(或称为 Orchestrator、Dispatcher)负责接收原始输入、维护上下文、判断意图并分配任务,通常不直接操作业务工具;Worker 则接收具体工单,在隔离环境中使用完整工具集完成任务。这种分层的好处是职责单一、故障隔离、易于横向扩展,但也引入了通信开销和状态同步问题。与早期单体 Agent 相比,Router–Worker 模式更接近分布式系统中的“调度器–执行器”模型,适合处理高并发、多来源的请求流。
消息进门前的三道筛子
真正的大头在消息进门之前。实验里一轮大约 300 条消息,只有 20 条是工作请求。第一道程序筛来源:这个群、这个仓库、这个人在不在范围里;第二道策略筛授权:在不在名单、有没有被 At 规则与不允许;第三道才轮到模型判断这条消息到底是不是活。
三道门走完,绝大多数噪音根本没见到模型。这不是提示词技巧,这是代码活。
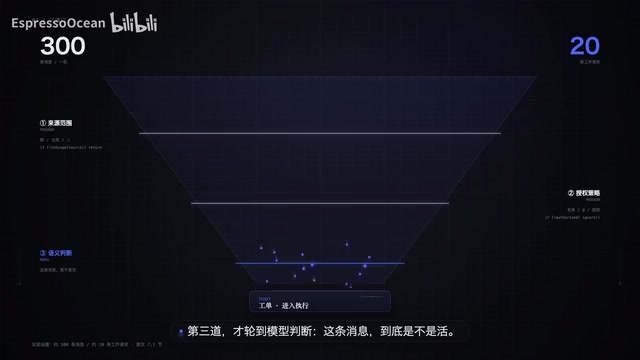
规则引擎与模型判断的混合过滤:在消息进入 Agent 系统前,先用程序化规则(如来源白名单、授权名单、@ 规则)进行快速筛选,只将疑似工作请求的消息交给模型判断。这种“规则先行、模型兜底”的设计能显著降低模型调用次数和 Token 消耗,同时避免模型被噪音干扰。规则引擎负责确定性、可审计的过滤,模型负责语义层面的模糊判断,二者互补。该模式在工业级 Agent 系统中常见,尤其适用于消息量大、噪音比例高的场景。
工单直通:省下的是一整条绕路
接下了后面每条消息还要回 Router 吗?不用。工单会订阅它出现的那个 Fred,后续评论、CAI 结果直接送进 Worker。DeepSeek广告 把直通拿掉做过对照:完成时间差不多,但 Router 的决定数多了约 30%,独缓存 Token 从 2323 万涨到 3177 万,增加约 37%。
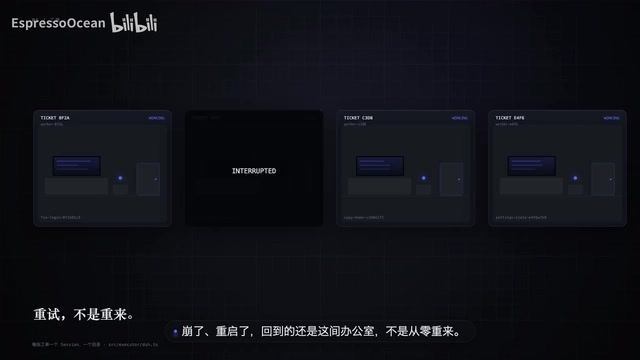
省的不是一句提示词,是一整条绕路。每张工单是一间独立办公室:独立的绘画、独立的目录、独立的分支和 PR,崩了回到的还是这间办公室,不是丛林重来。
还有一个容易误解的点:Worker 说 Ready 不等于事情完了。有 PR 的工单要等 PR 合并或者关闭才算结束。它把交付交给了真正的验收。
工单直通(Ticket Direct Pass)与上下文隔离:传统多智能体系统中,所有消息都先经过 Router 再转发给 Worker,导致 Router 需要反复处理同一工单的后续消息,增加决策次数和 Token 消耗。工单直通允许 Worker 直接订阅与其工单相关的后续事件(如评论、CI 结果),绕过 Router,从而减少路由开销。同时,每张工单拥有独立的运行环境(目录、分支、PR),实现故障隔离和状态独立,避免一个任务崩溃影响其他任务。这种设计借鉴了微服务中的“事件驱动”和“隔离舱”理念。
快了,但不是“效率翻倍”
在合成附在每种方案跑 5 次的实验里,任务完成时间的第 95 百分位从 29.5 分钟降到 15.7 分钟。注意,这只测调度和协作,不测代码质量。所以别写成效率翻倍。它不是让 AI 更会写代码,它是让多件事同时推进出来推进时少堵在你这儿。
代码里没有的东西
文章里的推测执行、一部 react 链式记忆、外部 watchdog,这个开源原型都没有实现。它有并发但没有提前猜测,有后台任务但没有一部 react 循环,有健康检查但没有进城内看门狗,也没有跨工单的长期记忆。
这不是黑的研究原型本来就不等于产品,但把路线图当交付是另一回事。
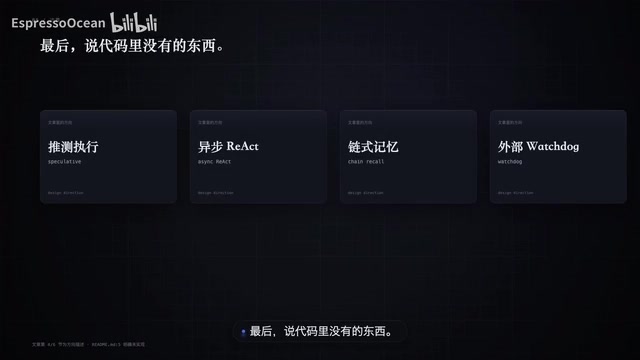
研究原型与产品交付的差距:官方 README 明确标注“研究原型,仅供参考”,意味着代码实现的是部分能力,而文章描述的可能是未来路线图。研究原型通常用于验证架构思想、进行对照实验,但不具备产品级的稳定性、安全性和完整功能。常见差距包括:缺少推测执行、链式记忆、外部监控等高级特性;未经过大规模生产环境测试;文档和接口可能不完善。读者需区分“已实现”与“规划中”,避免将路线图误认为交付成果。
第一原则:用最少的人类注意力换最大的价值
所以 DeepSeek 真正做的是:把人对 Agent 的请求先变成一张有授权的工单,再放进一个隔离的房间,最后只在值得的时候回来找你。它的第一原则写在 README 里——用最少的人类注意力换最大的价值。
算力会变便宜,模型会变强,只有你的注意力不会变多。未来拉开差距的可能不是你多会用 AI,而是你能否保住自己的注意力。你管 AI,还是 AI 并且?
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。