拆解LLM的"记忆"机制:本质只是上下文投喂
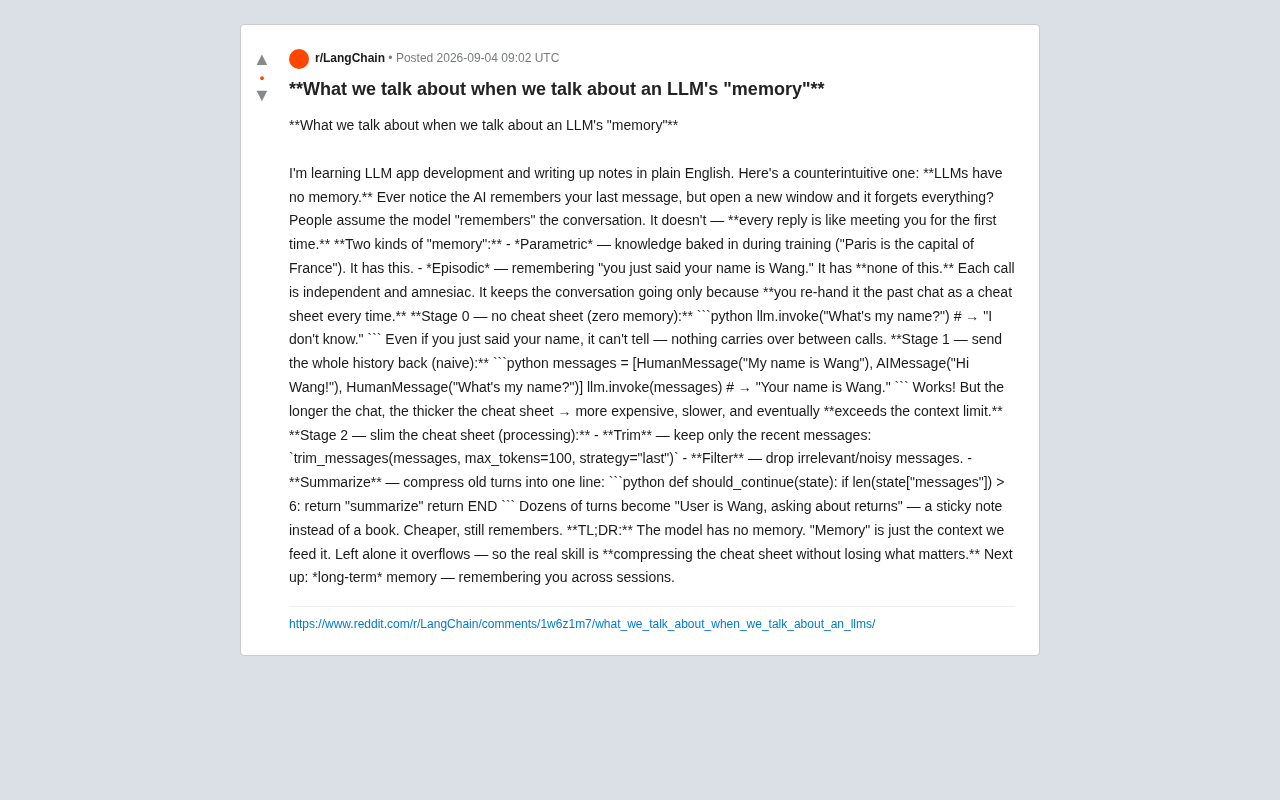
一个反直觉的真相:大模型根本没有记忆
很多人在使用 ChatGPT、Claude 等大语言模型时,都有一个隐含的假设:模型"记得"我们之前聊过什么。但真相恰恰相反——LLM 本身没有任何记忆能力。
你有没有注意到,AI 似乎能记住你上一条消息,但只要开一个新窗口,它就把一切都忘光了?这个现象揭示了一个关键事实:对模型来说,每一次回复都像是第一次见到你。它既不知道你是谁,也不记得刚才发生了什么。
这篇文章基于一位正在学习 LLM 应用开发的开发者在 Reddit 上分享的学习笔记,用通俗的方式拆解了"记忆"这个概念的本质,并给出了工程实践中的解决思路。
两种记忆类型:LLM有一种,缺一种
要理解为什么 LLM "没有记忆",需要先区分两种截然不同的记忆类型。
参数记忆:训练阶段固化的静态知识
参数记忆(Parametric Memory)是在训练阶段就固化进模型权重里的知识。比如"巴黎是法国的首都"、"水的化学式是 H₂O"这类通用事实。模型确实拥有这类记忆,它们被编码在数十亿甚至上万亿的参数当中。
从技术本质来看,参数记忆的底层机制是神经网络的权重矩阵。在训练过程中,模型通过反向传播算法不断调整这些浮点数参数,将海量文本中的统计规律编码为权重值。这个过程类似于人类通过反复学习将知识内化为长期记忆。以 GPT-4 为例,其参数量据估计超过万亿级别,训练数据覆盖了截止日期之前的大量互联网文本、书籍和学术论文。
训练完成后,这些知识就不会因为你和它的对话而更新——除非进行微调(Fine-tuning)或持续预训练(Continual Pre-training),而这两者都需要额外的训练流程和计算资源。
【扩展知识:微调与持续预训练的区别】 微调(Fine-tuning)和持续预训练(Continual Pre-training)是更新模型知识的两种主要方式,但它们的目标和方法截然不同。微调是在预训练模型基础上,使用特定任务的标注数据进行有监督训练,目标是让模型适应特定领域或任务格式。例如,将通用GPT模型在医疗问答数据上微调,使其更擅长回答医学问题。微调通常只需要数千到数万条样本,训练成本相对较低。而持续预训练则是继续用大规模无标注文本进行预训练,目标是更新模型的参数记忆——比如让2023年训练的模型学习2024年的新知识。持续预训练需要的数据量和计算资源都远大于微调,通常需要数十亿token的训练数据和数周的GPU集群时间。两者各有适用场景:微调适合定制化需求,持续预训练适合知识更新。
这也是为什么模型会有"知识截止日期"的原因。
情景记忆:LLM完全不具备的能力
情景记忆(Episodic Memory)是指记住"你刚才说你叫王"这类当下发生的具体事件。而这恰恰是 LLM 完全不具备的能力。
每一次 API 调用都是独立且失忆的(independent and amnesiac)。模型之所以能"接着聊",唯一的原因是:你每次都把过去的对话作为"小抄"重新递给了它。换句话说,所谓的对话记忆,本质上是应用层不断地把历史上下文重新喂给模型。
对话记忆的三个工程演进阶段
原作者用一个循序渐进的"小抄"比喻,清晰地展示了如何在工程上构建对话记忆。
阶段 0:零记忆状态——没有任何上下文
llm.invoke("What's my name?")
# → "I don't know."
即便你上一秒才说了自己的名字,模型也答不出来——因为在两次独立调用之间,没有任何信息被携带。这就是 LLM 的"出厂默认状态"。
阶段 1:发送全部历史——朴素但有效的做法
messages = [
    HumanMessage("My name is Wang"),
    AIMessage("Hi Wang!"),
    HumanMessage("What's my name?")
]
llm.invoke(messages)
# → "Your name is Wang."
这下能用了!但问题也随之而来:对话越长,小抄越厚。这带来三个直接后果——调用成本更高、响应速度更慢,并且最终会超出模型的上下文窗口限制(context limit)。
上下文窗口(Context Window)是指模型在一次推理中能处理的最大 token 数量。Token 是模型处理文本的最小单位,一个英文单词通常对应 1-2 个 token,一个中文字通常对应 1-2 个 token。早期的 GPT-3.5 上下文窗口仅有 4096 个 token(约 3000 个英文单词),而 GPT-4 Turbo 扩展到了 128K token,Claude 3 则达到了 200K token。
上下文窗口受限于 Transformer 架构中自注意力机制的计算复杂度——标准自注意力的计算量与序列长度的平方成正比,这意味着上下文翻倍,计算成本大约增长四倍。
【扩展知识:Transformer架构与自注意力机制】 Transformer是2017年Google提出的深度学习架构,彻底改变了自然语言处理领域。其核心创新是自注意力机制(Self-Attention),它允许模型在处理每个词时同时关注输入序列中的所有其他词。具体来说,自注意力通过Query、Key、Value三个矩阵计算词与词之间的相关性权重,这个计算过程的复杂度是O(n²),其中n是序列长度。这意味着如果上下文从4K token扩展到128K token,计算量会增长约1024倍。为了缓解这一问题,研究者们提出了多种优化方案:Sparse Attention只计算部分词对之间的注意力,Flash Attention通过内存优化加速计算,而Anthropic在Claude中使用的技术则进一步突破了这一限制。正是这个计算瓶颈,使得上下文窗口的扩展成为技术和成本的双重挑战。
此外,API 调用通常按 token 数量计费,上下文越长意味着每次调用的成本越高。
对于一个真实的生产级应用来说,这种朴素做法显然无法长期维持。
阶段 2:上下文压缩——真正的工程智慧
真正的工程智慧在于:如何在不丢失关键信息的前提下压缩上下文。原作者给出了三种常见的上下文压缩策略:
1. 裁剪(Trim)——只保留最近的若干条消息:
trim_messages(messages, max_tokens=100, strategy="last")
2. 过滤(Filter)——丢弃无关或噪声消息,只留下有价值的内容。
3. 摘要(Summarize)——把久远的对话压缩成一句话:
def should_continue(state):
    if len(state["messages"]) > 6:
        return "summarize"
    return END
通过摘要,几十轮对话可以被压缩成"用户叫王,正在咨询退货问题"这样一张便利贴,而不再是一整本书。结果就是:更便宜,同时依然记得住关键信息。
这三种压缩策略各有适用场景,值得深入理解。裁剪策略最简单直接,适合闲聊类场景,因为最近的对话通常最相关;但在需要引用早期关键信息的场景(如法律咨询中开头提到的案件编号)就会丢失重要上下文。过滤策略需要设计判断标准来区分"有价值"和"噪声"消息,可以基于规则(如过滤掉纯寒暄语句)或基于语义相似度来实现。摘要策略最为智能,它本身就利用 LLM 来生成对话摘要,但这引入了额外的 API 调用成本和延迟,而且摘要过程本身也可能丢失细节。在实际生产中,工程师往往会组合使用这三种策略——比如对最近 5 轮保留原文,对更早的对话生成摘要,对寒暄内容直接过滤。LangChain、LlamaIndex 等主流 LLM 应用框架都内置了这些记忆管理组件。
记忆不是模型能力,而是上下文管理的工程问题
这个视角对 LLM 应用开发者极具启发性。它把"记忆"从一个模糊的"模型是否智能"的问题,转化为一个清晰的上下文管理工程问题。
一旦理解了这一点,很多产品设计上的困惑就迎刃而解了:
- 为什么长对话会突然"忘记"开头说过的话?——因为超出上下文窗口后,早期消息被裁剪掉了。
- 为什么同样的问题在新会话里得到完全不同的回答?——因为新会话没有任何"小抄"。
- 为什么有些 AI 产品需要精心设计"系统提示词"?——因为这是模型每次都能看到的"永久小抄"。
真正的技术难点,从来不是让模型"拥有记忆",而是在有限的上下文预算内,决定哪些信息值得保留、如何高效压缩。这也是 RAG(检索增强生成)、向量数据库等技术流行的底层逻辑——它们本质上都是更智能的"小抄管理系统"。
RAG(Retrieval-Augmented Generation,检索增强生成)是 2020 年由 Facebook AI Research 提出的架构范式,其核心思想是:不把所有知识都塞进上下文,而是在需要时从外部知识库中检索最相关的片段,再注入到提示词中。这个过程依赖向量数据库(如 Pinecone、Weaviate、Milvus 等)来实现高效的语义检索。
【扩展知识:嵌入模型与向量化原理】 嵌入模型(Embedding Model)是将文本转化为高维向量的神经网络,它是RAG系统的基础组件。常用的嵌入模型包括OpenAI的text-embedding-3系列、开源的sentence-transformers等。这些模型通常将一段文本映射为512到4096维的浮点数向量,向量中的每个维度捕捉文本的某种语义特征。关键特性是:语义相似的文本在向量空间中的距离更近。距离通常用余弦相似度或欧氏距离来衡量。例如"苹果手机"和"iPhone"的向量会非常接近,而"苹果"和"香蕉"作为水果也有一定相似性。向量数据库正是利用这一特性,通过HNSW、IVF等近似最近邻算法,在数百万甚至数十亿条向量中快速找到最相关的几条记录,检索速度通常在毫秒级别。这种语义检索能力远超传统的关键词匹配,是现代AI应用的核心基础设施。
具体流程是:首先将文档切片并通过嵌入模型(Embedding Model)转化为高维向量存储在向量数据库中;当用户提问时,将问题同样转化为向量,通过近似最近邻搜索(ANN)找到语义最相关的文档片段;最后将这些片段拼接到提示词中供模型参考。
【扩展知识:向量数据库的技术架构】 向量数据库是专门为高维向量检索优化的存储系统,与传统关系型数据库有本质区别。传统数据库通过B树索引实现精确匹配查询,而向量数据库需要解决的是"找到最相似的向量"这一近似问题。主流算法包括:HNSW(Hierarchical Navigable Small World)构建多层图结构实现对数级检索复杂度;IVF(Inverted File Index)先将向量空间划分为多个聚类再在相关聚类中搜索;以及Product Quantization通过向量压缩减少内存占用。顶级向量数据库如Pinecone、Weaviate、Qdrant等都支持数十亿规模的向量存储,单次查询延迟通常在10-50毫秒。它们还提供元数据过滤(如按时间范围或用户ID筛选)、混合检索(结合关键词和语义)等高级功能。在RAG架构中,向量数据库的性能直接决定了检索质量和系统响应速度。
这种方式既解决了上下文窗口有限的问题,也解决了参数记忆无法更新的问题——只需更新向量数据库中的文档即可。
下一步挑战:跨会话的长期记忆方案
本文讨论的都是单次会话内的短期记忆管理。而更进一步的挑战是长期记忆:如何让 AI 在不同的会话之间也能记住你?
这就需要引入外部存储机制——比如将用户画像、历史偏好持久化到数据库,并在合适的时机检索出来注入到上下文中。这正是当前诸多 AI 助手产品竞相攻克的方向。
目前跨会话长期记忆的主流技术方案包括三大类。第一类是用户画像持久化,将对话中提取的用户偏好、基本信息等结构化数据存入关系型数据库或键值存储中。第二类是记忆向量化,将重要的对话片段转化为向量存储在向量数据库中,在新会话开始时通过语义检索注入相关历史记忆。第三类是知识图谱方式,将对话中的实体和关系提取出来构建图谱,实现更精确的记忆检索。
【扩展知识:知识图谱与图数据库】 知识图谱(Knowledge Graph)是一种以图结构存储实体和关系的知识表示方法,起源于Google在2012年提出的同名项目。在知识图谱中,节点代表实体(如人物、地点、概念),边代表关系(如"工作于"、"位于"、"是...的子类")。与向量数据库的"模糊语义匹配"不同,知识图谱提供精确的结构化知识。例如,向量检索可能返回语义相关的文档片段,而知识图谱可以精确回答"张三在哪家公司工作"并进一步推理出"张三的同事有哪些"。图数据库如Neo4j、Amazon Neptune等专门用于存储和查询图结构数据,支持Cypher、Gremlin等图查询语言。在长期记忆系统中,知识图谱特别适合存储用户的人际关系、兴趣偏好等结构化信息。实现难点在于如何从自然语言对话中自动提取实体和关系,这通常需要命名实体识别(NER)和关系抽取(RE)等NLP技术。
OpenAI 在 2024 年为 ChatGPT 引入的 Memory 功能、Google Gemini 的记忆系统,以及开源框架 Mem0 等,都在探索这个方向。核心挑战在于:如何自动判断哪些信息值得长期记忆、如何处理记忆冲突(例如用户更新了个人信息)、以及如何在隐私保护和个性化服务之间取得平衡。
结语
模型没有记忆,所谓的"记忆"只是我们喂给它的上下文。 放任不管,它就会溢出;因此真正的技能,是在不丢失关键信息的前提下压缩这张小抄。
对于每一位 LLM 应用开发者而言,把"记忆"理解为可控的工程变量,而非黑盒里的神秘能力,是构建可靠 AI 应用的第一步。
核心要点
- LLM 本身没有情景记忆能力,每次 API 调用都是独立的
- 参数记忆是训练时固化的静态知识,无法通过对话更新
- 对话记忆的本质是应用层将历史上下文重新喂给模型
- 上下文窗口的限制使得朴素的"全部历史"方案不可持续
- 上下文压缩的三种策略:裁剪、过滤、摘要
- RAG 和向量数据库是更智能的外部记忆管理系统
- 长期跨会话记忆需要外部存储和智能检索机制
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
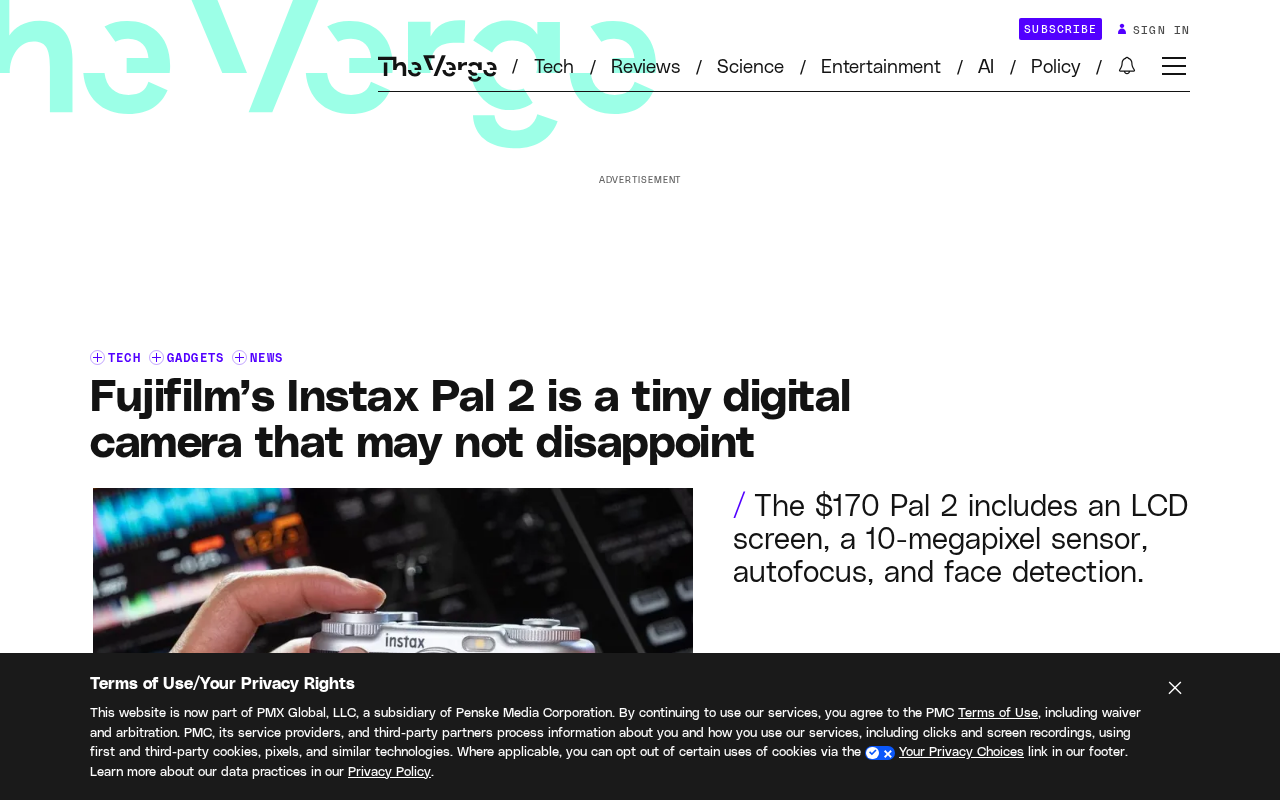
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
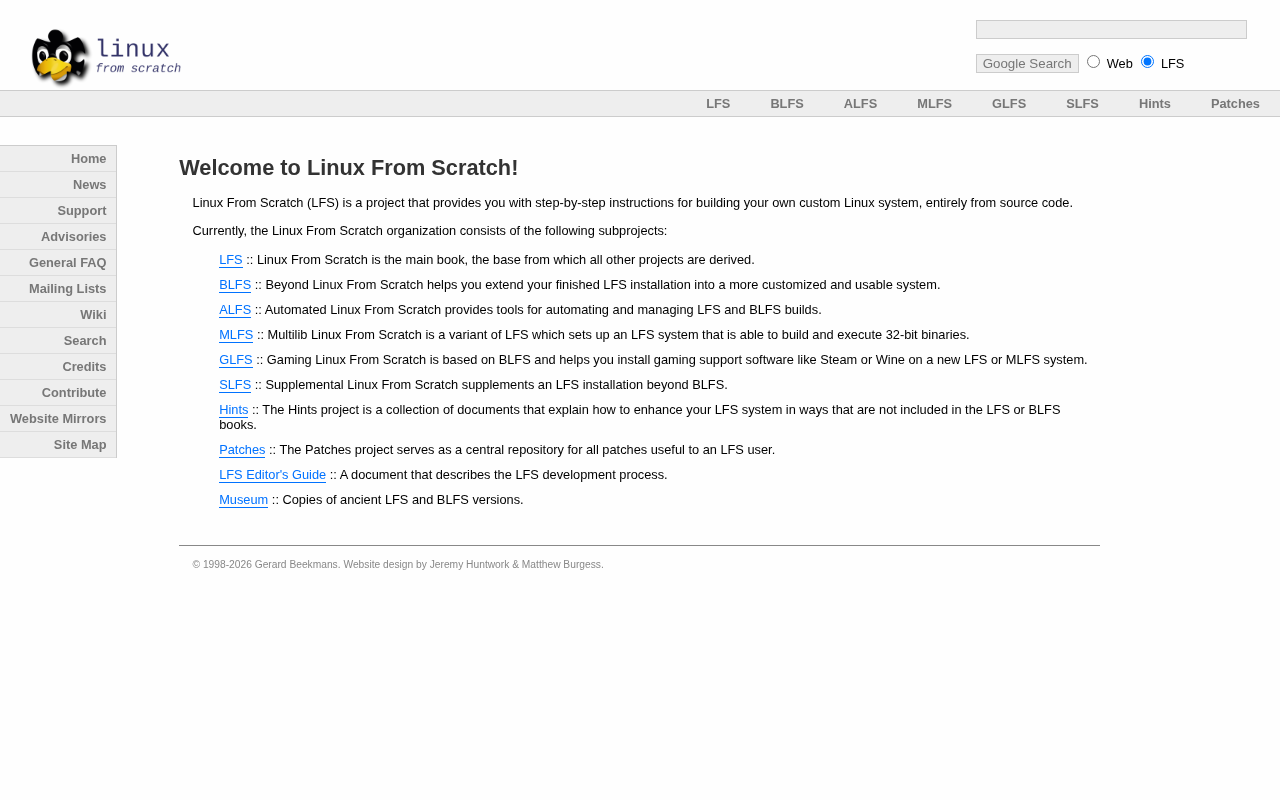
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。