拆解一则AI原生全栈工程师招聘:柏林团队要什么样的人
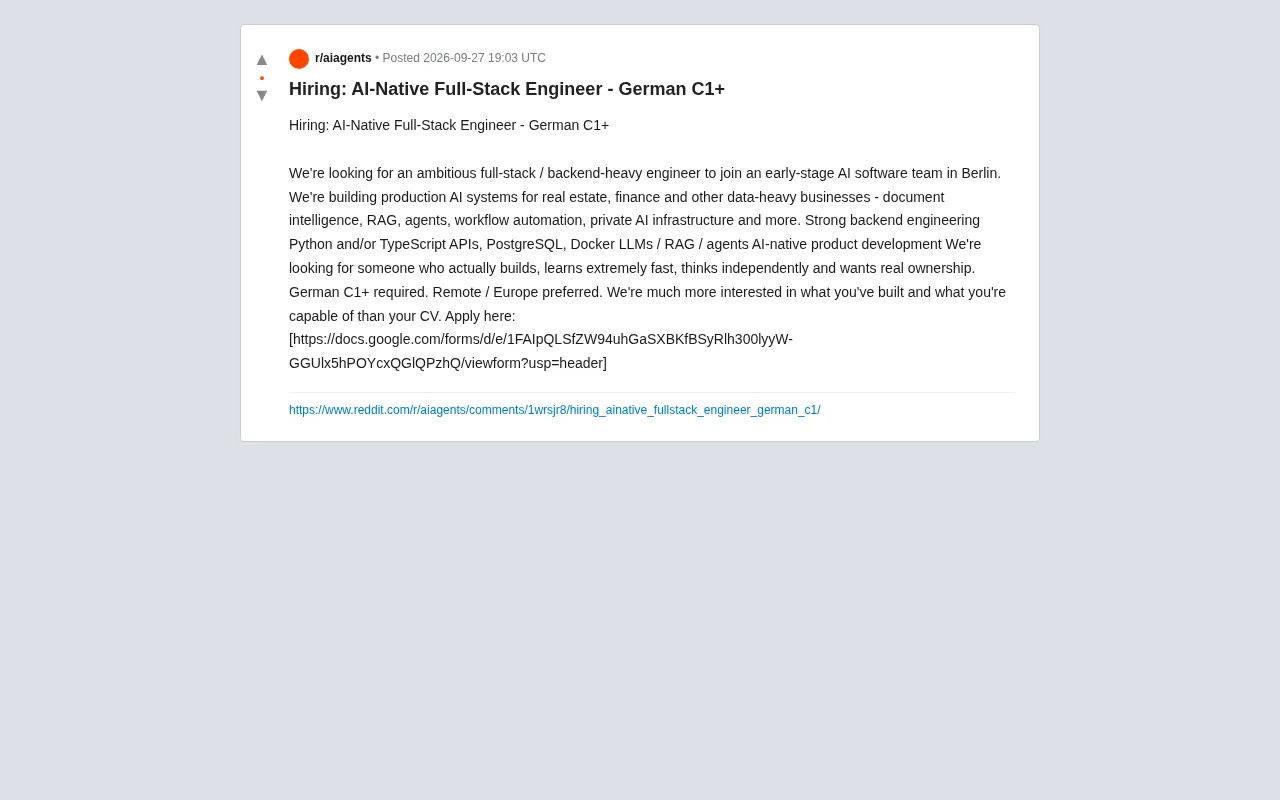
一则柏林AI创业招聘拆解了企业级AI落地的真实技术门槛与人才标准
一家柏林早期AI团队的招聘启事揭示了当前企业级AI应用层创业的典型技术画像:以Python/TypeScript、PostgreSQL、Docker构建务实后端,将RAG、Agents、文档智能落地于房地产与金融等数据密集行业,并提供私有化AI基础设施以满足数据合规需求。岗位强调"AI原生"——产品以AI为核心而非外挂,工程师须将AI工具深度融入开发工作流并具备极快的学习迭代能力。德语C1+要求和远程欧洲优先策略,进一步说明企业级AI落地高度依赖行业语境与本地市场理解。整体来看,这则招聘印证了应用层是AI创业主战场、私有化部署需求上升、技术招聘转向产出导向等几个正在发生的行业趋势。
一则招聘启事背后的行业信号
一家位于柏林的早期AI软件团队发布了招聘,寻找一名「AI原生」(AI-Native)的全栈/偏后端工程师。这条看似普通的招聘信息,实际上折射出当前AI应用层创业公司对人才的真实需求画像——它比传统的岗位描述更能说明「生产级AI系统」团队究竟在做什么、需要什么样的能力组合。
这家公司专注于为房地产、金融等数据密集型业务构建生产环境的AI系统,涉及的方向包括文档智能(document intelligence)、检索增强生成(RAG)、智能体(agents)、工作流自动化以及私有化AI基础设施。这几个关键词几乎串起了当下企业级AI落地的主线:不是做通用大模型,而是把大模型能力嵌入到具体行业的真实数据流程里。
技术栈拆解:这些要求意味着什么
招聘中列出的核心技术能力值得逐条解读,因为它们代表了AI应用团队的典型工程画像。
后端为主的全栈能力
岗位明确要求「强后端工程能力」,使用 Python 和/或 TypeScript 构建 API,配合 PostgreSQL 和 Docker。这套组合非常主流:Python 承担AI/数据处理逻辑,TypeScript 处理接口与前端衔接,PostgreSQL 作为可靠的关系型存储(也可通过 pgvector 支持向量检索),Docker 负责部署与环境一致性。
这透露出一个信息——AI创业公司并不需要花哨的技术栈,而是需要扎实、可维护、能快速交付的工程基础。真正的复杂度不在于框架选型,而在于如何把这些成熟工具组合成稳定运行的生产系统。
LLM / RAG / Agents 的实战经验
将「LLMs / RAG / agents」直接列为硬性能力,说明这已不再是加分项,而是准入门槛。对于处理房地产合同、金融文档这类场景,RAG 是让大模型「读懂」私有数据的关键手段,而 agents 则用于自动化多步骤的业务流程。这要求工程师不仅会调用 API,还要理解检索质量、上下文管理、幻觉控制等实际落地难点。
RAG(检索增强生成)的核心思路是将外部知识库的检索结果注入大模型的输入上下文,使模型能够回答其训练数据之外的私有或实时信息。典型流程包括三个环节:将文档切片后编码为向量并存入向量数据库(如 pgvector、Weaviate);用户提问时同样编码为向量并进行相似度检索;将检索结果拼接进 prompt 后由 LLM 生成答案。在房地产合同、金融报表等场景中,文档结构复杂、专业术语密集,检索质量直接决定输出准确性,因此分块策略、嵌入模型选择、重排序(reranking)以及幻觉检测都是必须解决的工程问题,而非仅靠调用一次 API 能完成的任务。Agents 则在 RAG 基础上进一步引入多步骤推理与工具调用能力,使模型能够自主分解任务、调用外部 API、执行代码并根据中间结果调整下一步行动,适合处理审批流、数据核验等需要跨系统协作的业务自动化场景。
「AI原生」到底指什么样的工程师
招聘中反复强调的一个词是 AI-native product development(AI原生产品开发),并特别指出他们更看重「你构建过什么、你有什么能力」,而不是简历本身。
这里的「AI原生」有两层含义:其一,产品从设计之初就以AI能力为核心,而非在传统软件上外挂一个AI功能;其二,工程师本人应当把AI工具深度融入自己的开发工作流,能借助AI快速学习、快速构建。招聘明确要求候选人「真正动手做、学得极快、能独立思考、渴望真正的所有权(ownership)」——这几乎是所有早期团队对核心成员的共同期待,但在AI领域尤为迫切,因为技术迭代速度远超以往。
值得注意的招聘条件
有两个附加条件颇具信息量。
第一是德语 C1+ 的硬性要求。这在技术岗位中并不常见,通常意味着团队服务的客户(房地产、金融)以德语区市场为主,工程师需要直接理解业务文档、与客户沟通,或参与本地化的产品设计。这也提醒我们,企业级AI落地高度依赖对行业语境的理解,语言与领域知识本身就是竞争壁垒。
第二是远程优先、偏好欧洲的用人策略。早期团队通过远程招募扩大人才池,同时用地域和语言限制保证协作效率与市场契合度,是一种务实的折中。
从这则招聘能读出的趋势
把这条信息放到更大的背景里看,它印证了几个正在发生的变化:
- 应用层是AI创业的主战场。相比训练基础模型,把RAG、agents、文档智能应用到房地产、金融等具体行业,门槛更可控、变现路径更清晰。
- 私有化AI基础设施需求上升。招聘明确提到「private AI infrastructure」,反映数据敏感行业对数据不出域、可控部署的强烈诉求。
- 人才评价标准正在转向「产出导向」。「更在意你造过什么而非你的CV」这句话,代表了技术招聘从资历崇拜向能力实证的迁移。
对于想进入AI应用领域的工程师而言,这则招聘几乎是一份能力清单:夯实后端基础、掌握RAG与agents的工程实践、能用AI工具放大自己的生产力,比堆砌一份漂亮的简历更有价值。
私有化AI基础设施(Private AI Infrastructure)通常指将大模型的推理服务、向量数据库、编排框架等组件全部部署在企业自有或私有云环境中,数据不经过任何第三方API。实现方式涵盖本地化部署开源模型(如 Llama 系列、Mistral)、使用 Ollama 或 vLLM 作为推理引擎,以及在私有环境中自建 RAG 管道。对于持有客户合同、征信记录、房产交易数据的金融和房地产企业,数据合规(GDPR等)与信息安全审计往往是采购AI解决方案的前置条件,这使得能够交付「可控部署」方案的供应商具备显著差异化优势,也解释了为何一个早期团队就已将私有化基础设施列为核心能力方向。
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。