溯源密度:破解AI内容透明度困境的新思路

研究提出"溯源密度"界面,将AI透明度从"贴标签"升级为可视化证据地图,实验显示辨别力效应量高达d=1.82。
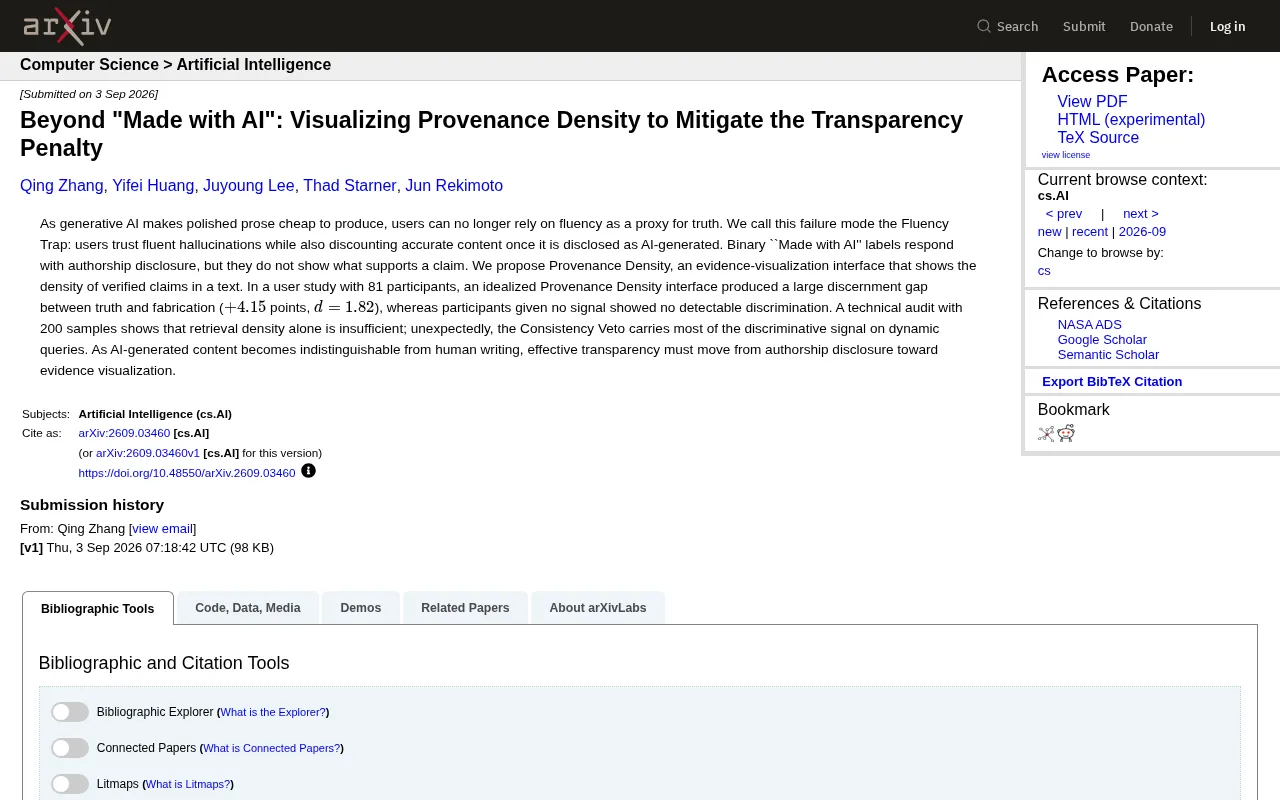
一篇arXiv论文指出,人类将"文字流畅"作为"内容可信"代理指标的习惯,在AI时代演变为"流畅性陷阱"——用户既会轻信流畅的AI幻觉内容,又会因"AI生成"标签不加区分地否定准确内容。针对此困境,论文提出"溯源密度"界面:不再关注作者身份,而是以细粒度可视化方式标示文本中经过验证的主张密度。81人用户实验显示,使用该界面后真假内容的辨别差距达+4.15分,效应量d=1.82,远超统计意义上的"大效应"阈值。技术审计还揭示一个意外发现:判别信号的主要来源并非检索到的引用数量,而是"一致性否决"机制——即检测主张是否与已验证事实相矛盾。论文由此论证,有效的AI透明度必须从"作者披露"转向"证据可视化"。
当流畅不再等于真实
生成式AI最大的能力之一,是让优美流畅的文字变得极其廉价。但这也带来了一个隐蔽的认知陷阱——一篇新发表于arXiv的研究论文将其命名为**"流畅性陷阱"(Fluency Trap)**。
研究者指出,人类长期以来把"文字流畅"当作"内容可信"的隐性代理指标。在AI时代,这条经验法则彻底失效:一方面,用户会轻信那些流畅但完全虚构的"幻觉"内容;另一方面,一旦某段文字被标注为"AI生成",用户又会不加区分地贬低它——即便内容准确无误。
这就构成了一个双重困境。当前主流平台采用的"Made with AI"二元标签,本质上只回答了"谁写的"这个问题,却完全没有回答"这段话凭什么可信"。作者身份的披露,并不能帮助读者判断具体主张是否有证据支撑。
什么是溯源密度:从"谁写的"到"凭什么信"
论文提出的核心方案叫做**"溯源密度"(Provenance Density)**。这是一种证据可视化界面,它不再纠结于内容的作者身份,而是直接展示文本中"经过验证的主张"的密度分布。
核心理念的转变
传统的透明度机制关注的是"披露作者"(authorship disclosure),而溯源密度关注的是"可视化证据"(evidence visualization)。这是一个根本性的视角转换。
对于一段文字,溯源密度界面会标示出:
- 哪些具体陈述能够被外部证据核实
- 这些证据的密集程度如何
- 哪些部分缺乏可靠支撑
读者由此获得的不再是一个笼统的"这是AI写的"警告,而是一份关于内容可信度的细粒度地图。
这种设计的意义在于,它承认了一个现实:随着AI生成内容与人类写作变得越来越难以区分,纠结于"是不是AI写的"已经意义不大。真正重要的是,无论谁写的,这段话背后到底有没有证据。
用户实验揭示显著的"辨别力鸿沟"
为了验证溯源密度界面的有效性,研究团队开展了一项包含81名参与者的用户研究,结果相当引人注目。
辨别力的量化差距
实验中,使用理想化溯源密度界面的参与者,在区分"真实内容"与"虚构内容"上表现出巨大的辨别力提升——真实与捏造之间的判别差距达到了**+4.15分**,效应量d=1.82。
在统计学上,d=1.82属于极大的效应量(通常d=0.8就被认为是大效应),说明证据可视化对提升用户判断力的作用非常显著。
作为对比,那些没有获得任何辅助信号的参与者"没有表现出可检测到的辨别能力"——他们几乎无法区分真假内容。这个对照结果恰恰印证了流畅性陷阱的存在:在缺乏证据线索时,人类面对流畅的AI文本几乎处于"裸奔"状态。
技术审计带来一个意外发现
除了用户研究,团队还对200个样本进行了技术审计,试图弄清楚溯源密度界面背后的判别信号究竟来自哪里。结论出人意料。
检索密度并不够用
研究者原本预期,"检索密度"(retrieval density,即能检索到多少支撑证据)是判别真伪的关键。但审计结果显示,仅靠检索密度是不充分的。
真正令人意外的是,在动态查询场景下,承担大部分判别信号的其实是**"一致性否决"(Consistency Veto)机制**。
所谓一致性否决,可以理解为一种"矛盾检测"逻辑:当一条主张与已验证的证据相互冲突时,系统会将其否决。相比于"能找到多少证据","是否存在与证据相矛盾之处"反而是更强的可信度判别指标。
这一发现对未来AI内容验证工具的设计具有实际指导意义——单纯堆砌检索到的引用来源,可能不如引入一致性校验机制来得有效。
AI透明度机制该往何处去
这篇论文的价值,不仅在于提出了一个具体的界面方案,更在于它对整个AI透明度讨论方向的重新定位。
从标签走向证据
目前,从社交媒体平台到监管机构,主流做法仍停留在给AI内容"贴标签"的阶段。但论文的核心论点是:当AI生成内容变得与人类写作无法区分时,有效的透明度必须从"作者披露"转向"证据可视化"。
这个转变有其深刻的合理性。贴标签解决的是"信任来源"的问题,但在AI时代,来源本身已经不再是可靠的信任基础。我们需要一套机制去帮助读者直接评估内容本身的可信度。
现实挑战与落地前景
需要清醒地看到,实验中使用的是"理想化"的溯源密度界面。在真实世界中,如何高效、准确地对海量内容进行主张级别的证据核实与一致性校验,仍是巨大的工程挑战。技术审计中揭示的一致性否决机制,或许正是走向实用化的一个重要突破口。
无论如何,这项研究为我们提供了一个清晰的方向:面对AI内容的洪流,我们真正需要的不是一句"这是AI写的",而是一份看得见证据的可信度地图。
相关推荐
MiniMax H3 开源视频模型本地部署实测:8G显存即可玩转
MiniMax H3 最新开源视频生成模型本地部署实测教程,支持文生视频、图生视频与首尾帧控制。8G显存即可运行,含ComfyUI部署流程、量化版本选择与实际应用效果分析。
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。