ChatGPT开始追踪你在其他网站的行为?广告数据采集引隐私争议
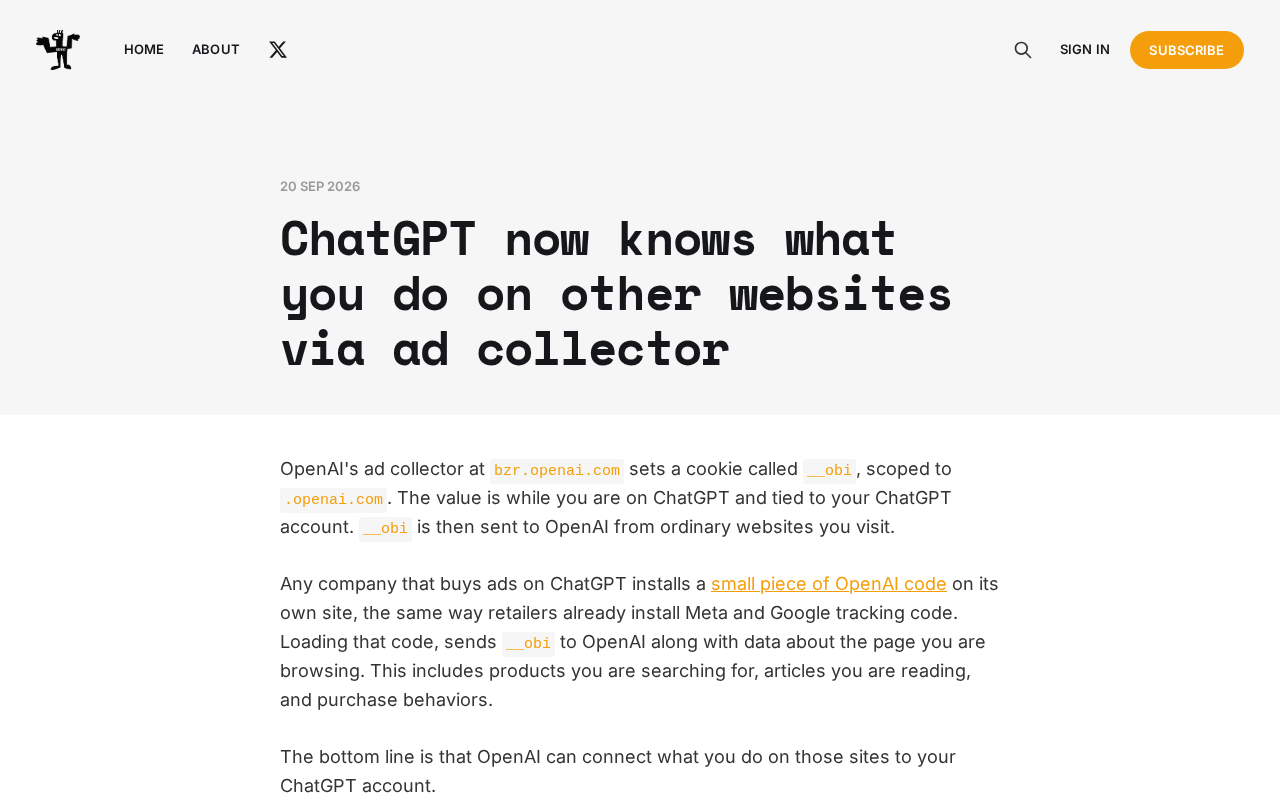
Hacker News帖子引发讨论:ChatGPT疑借广告采集机制获取用户跨站行为数据,隐私边界再受关注。
一则Hacker News帖子称ChatGPT可能通过广告数据采集机制,获知用户在其他网站的浏览与行为轨迹,尽管帖子本身信息有限,但触发了技术社区对AI产品隐私边界的讨论。广告采集体系通过追踪像素、Cookie及第三方数据合作,可将用户的跨站行为与AI对话数据打通,形成远超用户预期的详细画像。文章指出,AI个性化服务与用户隐私保护之间存在结构性张力:对话内容本就涉及健康、财务等高敏感信息,一旦叠加跨站行为数据,潜在风险显著放大。文章建议用户主动审查隐私设置、关注权限授权范围,并善用反追踪工具,同时呼吁以厂商官方声明为准,保持理性判断。
一则引发关注的隐私讨论
近日,Hacker News上一则标题为"ChatGPT now knows what you do on other websites via ad collector"的帖子引发了技术社区的讨论。帖子指出,ChatGPT可能通过某种广告数据采集机制,获知用户在其他网站上的行为轨迹。尽管这条讨论的规模不大(37个点赞、3条评论),但它触及了当前AI产品发展中一个日益敏感的话题——数据采集与用户隐私的边界。
需要说明的是,原始素材信息量有限,尚未提供技术层面的详细佐证或官方回应。因此本文更多是基于这一话题展开的行业观察与分析,而非对具体事实的确认。
广告数据采集意味着什么
"ad collector"(广告采集器)通常指一类通过广告网络、追踪像素(tracking pixel)、Cookie或第三方数据合作,收集用户跨站行为的机制。在传统的互联网广告生态中,这类技术早已普遍存在——广告平台通过它来构建用户画像,从而实现精准投放。
如果一款AI对话产品接入了类似的数据源,理论上它就能在对话中"了解"用户此前在其他网站的浏览、购买或搜索行为。这种能力对于个性化推荐固然有价值,但也意味着AI掌握的用户信息范围被显著扩大,远超单纯的对话内容本身。
对普通用户而言,问题的核心在于知情与同意:用户是否清楚自己的跨站行为正在被采集?这些数据又将如何被使用?
追踪像素(Tracking Pixel)是广告生态中最隐蔽的采集手段之一,通常是一张1×1像素的透明图片或一段JavaScript代码,嵌入在网页或邮件中。当用户加载页面时,浏览器会自动向第三方服务器发起请求,由此暴露用户的IP地址、设备信息、访问时间及来源页面。Cookie同步(Cookie Syncing)则允许不同广告平台之间交换用户ID,将同一用户在不同网站的行为数据关联起来,形成跨域用户画像。值得注意的是,随着苹果Safari和Firefox相继限制第三方Cookie,广告行业正在转向"指纹识别"(Browser Fingerprinting)等更难规避的技术——通过收集浏览器版本、字体列表、屏幕分辨率等参数组合,在不使用Cookie的情况下识别并追踪用户。如果AI平台接入了此类数据中间商(Data Broker)的服务,其所能构建的用户画像将远比用户所能意识到的更为全面。
AI产品的数据边界之争
随着大型语言模型走向商业化,如何在"提供更智能的个性化服务"与"保护用户隐私"之间取得平衡,正成为整个行业的难题。
一方面,个性化确实能提升产品体验。AI若能结合用户的实际兴趣与历史行为,给出的回答会更贴合需求。另一方面,AI对话往往涉及高度私密的内容——健康、财务、情感等,一旦这些对话数据与跨站行为数据打通,形成的用户画像将极其详尽,潜在的隐私风险也随之放大。
这也是为什么这类话题即便讨论量不大,仍能触动技术社区的敏感神经。用户对AI产品的信任,很大程度上建立在对数据使用透明度的期待之上。
这一争议的监管背景同样值得了解。欧盟《通用数据保护条例》(GDPR)明确要求数据处理须有合法依据,且用户有权知晓数据被如何使用;美国目前缺乏统一的联邦隐私立法,但加州《消费者隐私法案》(CCPA)赋予了加州居民查询和删除个人数据的权利。2023年,意大利数据保护机构曾以"缺乏合法数据处理依据"为由临时封禁ChatGPT,迫使OpenAI增加了更明确的用户告知机制。这说明对于AI产品数据实践的监管审查正在收紧,"告知后同意"原则在AI个性化场景下如何落地,仍是监管机构和企业都在摸索的课题。
用户可以关注哪些方面
在官方尚未给出明确说明前,用户可以从几个角度保持警惕:
- 审查隐私设置:定期检查所用AI产品和账户的隐私与数据共享选项,关闭不必要的个性化追踪。
- 留意权限授权:在授权第三方登录或数据连接时,注意其请求的数据范围。
- 关注官方声明:对于此类传闻,以厂商的正式隐私政策和公告为准,避免被未经证实的信息误导。
- 善用浏览器防护:使用反追踪插件、清理Cookie等手段,减少跨站行为被采集的可能。
结语
这条Hacker News讨论本身信息有限,更多是抛出了一个值得警惕的议题:当AI产品越来越深地嵌入我们的数字生活,它们所能触及的数据边界也在不断扩展。对于用户和监管方而言,推动数据采集的透明化与可控化,将是AI时代绕不开的课题。在更权威的信息出现前,保持理性关注、审慎对待自己的数据授权,是每位用户可以采取的务实态度。
相关推荐
Superpowers Skill 实测:一句话让 AI 编程助手跑完整个开发流程
Superpowers 是一套用于 Claude Code、Cursor 等 AI 编程助手的 14 个 Skill 集合,通过完整开发流程方法论让 AI 从需求审问到代码交付全程自主完成。本文详解其安装配置与图书管理系统实战演示。
WorkBuddy零基础实战:让AI从聊天工具变成办公员工
WorkBuddy零基础实战教程:一款支持飞书钉钉腾讯文档、装好即用的桌面AI智能体。本文解析它与Codex的核心差异、使用成本、常见认知误区及Excel、Word文件自动化办公场景,助你从AI提问者进化为AI管理者。
AI Agent零基础入门指南:从概念到项目实战的学习路径
AI Agent零基础入门到精通的系统学习路径:从环境配置、提示词工程、工具调用等基础概念,到ReAct、RAG、多智能体协同架构,再到私人助手、自动化办公等项目实战,帮你构建清晰的智能体开发知识框架。