ChatGPT跨设备回复克里奥尔语?一则Reddit帖引发的隐私猜想

Reddit帖子引发AI跨设备数据关联猜疑,技术分析指向巧合与账号共享更为合理
一则Reddit帖子称,父亲在使用AI助手时收到了西非克里奥尔语回复,而发帖者本人此前在另一台设备上刚好搜索过相关内容,由此引发了AI是否跨设备关联用户数据的猜疑。文章逐一拆解了更具说服力的技术解释:人类大脑容易在随机事件中寻找模式(小样本错觉);家庭成员若共用同一AI账号,跨会话记忆功能会自然产生"数据串联"的错觉;主流大模型的训练为离线批量进行,单次搜索不可能在数小时内实时影响他人的回复结果。文章同时承认,这一事件折射出AI产品数据透明度不足、用户无法追溯模型异常输出等真实问题,并为用户提供了自查步骤,呼吁AI厂商正面回应隐私透明度课题。
一个耐人寻味的用户遭遇
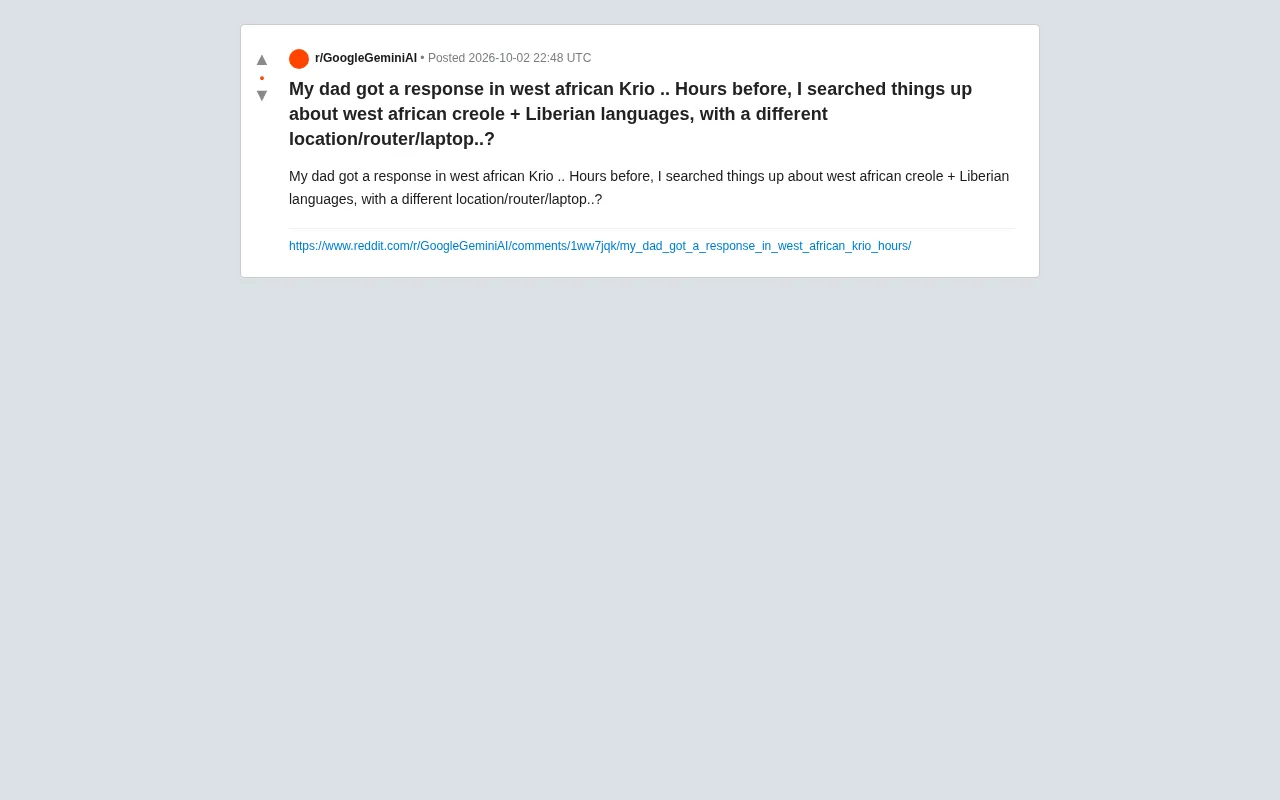
近日,一则Reddit帖子引发了不少讨论。发帖者称,自己的父亲在使用AI助手时收到了一段用西非克里奥尔语(Krio)书写的回复,而就在几小时前,这位发帖者本人曾用另一台笔记本电脑、另一个路由器、不同的地理位置,搜索过关于西非克里奥尔语和利比里亚语言的相关内容。
这种看似巧合的关联让发帖者感到困惑:难道AI系统在不同设备、不同网络、不同账号之间,悄悄把两个人的行为数据关联到了一起?
为什么这件事会让人警觉
西非克里奥尔语(Krio)是塞拉利昂的主要通用语之一,利比里亚也有相近的英语基克里奥尔变体。对大多数用户来说,AI助手主动输出这类小众语言的概率并不高。正因为稀有,这位发帖者才会把父亲收到的回复,与自己几小时前的搜索行为联系在一起。
这背后触及的是一个普遍的用户焦虑:我们的搜索和对话数据,是否会跨设备、跨账号被打通? 当一个在设备A上发生的行为,看似影响了设备B上的输出时,人们很自然会怀疑数据被集中画像了。
更可能的技术解释
在把这件事解读为"隐私泄露"之前,有几个更朴素的技术原因值得先考虑。
巧合与小样本错觉
人类大脑擅长在随机事件中寻找模式。AI模型在回答某些开放性或模糊问题时,偶尔会切换语言,尤其当输入中包含歧义、非英语词汇或模型"误判"了用户意图时。一次孤立的克里奥尔语回复,完全可能是模型自身的随机行为,而非数据关联的结果。
家庭网络与账号的隐性共享
即便发帖者强调使用了"不同的路由器和位置",但如果父子二人共用同一个AI账号、同一套登录凭证,或曾在同一设备上登录过,那么对话历史、记忆功能(如ChatGPT的Memory)或个性化设置就可能产生跨会话影响。许多AI产品的"记忆"特性正是为了跨对话保持上下文。
ChatGPT的Memory(记忆)功能于2024年初正式推出,允许模型在不同对话之间保留用户偏好、背景信息和过往交流内容。这些记忆条目存储于账号层面而非设备层面,这意味着只要登录同一账号,无论使用哪台设备或哪个网络,模型都能调取相同的记忆库。除ChatGPT外,Google Gemini、Claude等主流产品也有类似的跨会话上下文保留机制。对家庭共用账号的场景来说,一个家庭成员触发的记忆条目(例如"用户对某种语言感兴趣")完全可能在另一个家庭成员的对话中被激活,产生看似神秘的"数据关联"效果,而实际上不过是账号内部的正常功能运作。
模型训练与用户数据的边界
需要澄清一个常见误解:主流大模型不会实时地把某个用户几小时前的搜索,即时注入到另一个用户的回答里。模型权重的训练是离线、批量进行的,单次搜索不可能在数小时内改变模型对他人的输出。因此"我搜索了,几小时后它就对别人这么回答"在技术上并不成立。
大型语言模型的训练流程通常分为预训练(Pre-training)和微调(Fine-tuning)两个阶段,二者都是在静态数据集上离线完成的,整个过程可能耗时数周乃至数月。模型一旦部署上线,其权重便被固定下来,日常用户的对话数据并不会立即反向影响模型的参数。部分服务商会定期收集用户反馈用于后续版本的训练,但这同样是批量、延迟处理的,并非实时管道。少数产品提供所谓"联网搜索"或"实时检索"功能,但那是在推理阶段临时拉取外部信息,与修改模型权重是两回事。理解这一区别,有助于判断"数小时内影响他人回复"在技术上为何几乎不可能发生。
这类帖子反映的真实问题
尽管这则个案很可能是巧合,但它折射出的用户顾虑是真实且值得重视的:
- 数据透明度不足:用户往往不清楚AI产品到底收集了什么、如何跨设备关联账号。
- 记忆功能的双刃剑:个性化记忆提升了体验,却也让用户担心"它记得太多"。
- 缺乏可验证的解释:当模型出现异常输出时,用户几乎无法追溯原因,只能凭直觉猜测。
用户可以怎么做
如果你也遇到类似的"诡异关联",不妨做几件事来排查:
- 确认涉事设备是否登录了同一个AI账号或共享了登录状态。
- 检查并清理AI助手的"记忆"或历史记录设置。
- 复现问题——用全新的无痕会话、全新账号再试一次,看是否还能稳定重现。
- 若确实能稳定复现跨账号的数据串联,再向服务提供商反馈并保留证据。
结语
这则Reddit帖子本身只是一段未经证实的个人叙述,缺乏可复现的证据和技术日志,很难据此断定AI系统存在跨设备数据打通。更合理的判断是:这更可能是模型随机行为与人类模式识别心理叠加的产物。但它所引出的隐私透明度讨论,恰恰是当下AI产品亟需正面回应的课题。
相关推荐
Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。
Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。
“黑色十月”:AI挖出史上3%严重漏洞?
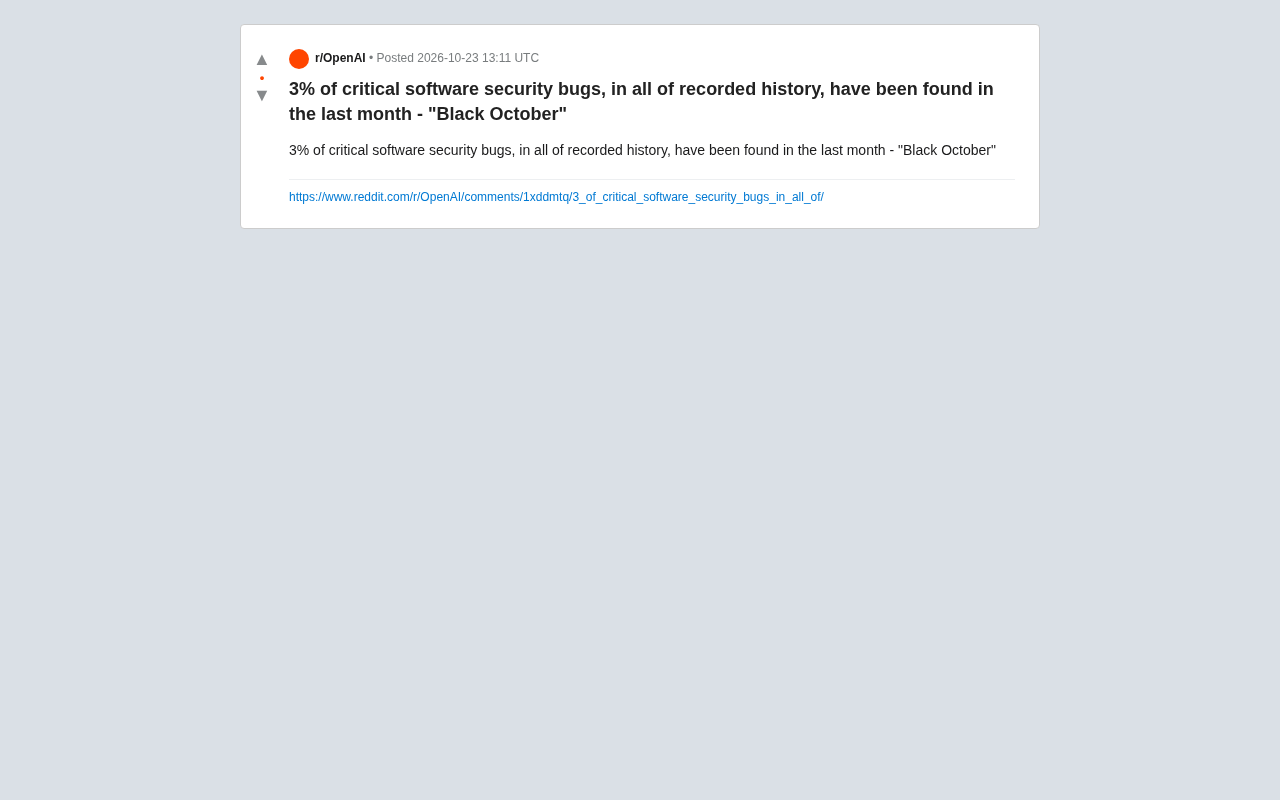
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。