ChatGPT伪造《纽约客》漫画并盗用真实漫画家签名引争议
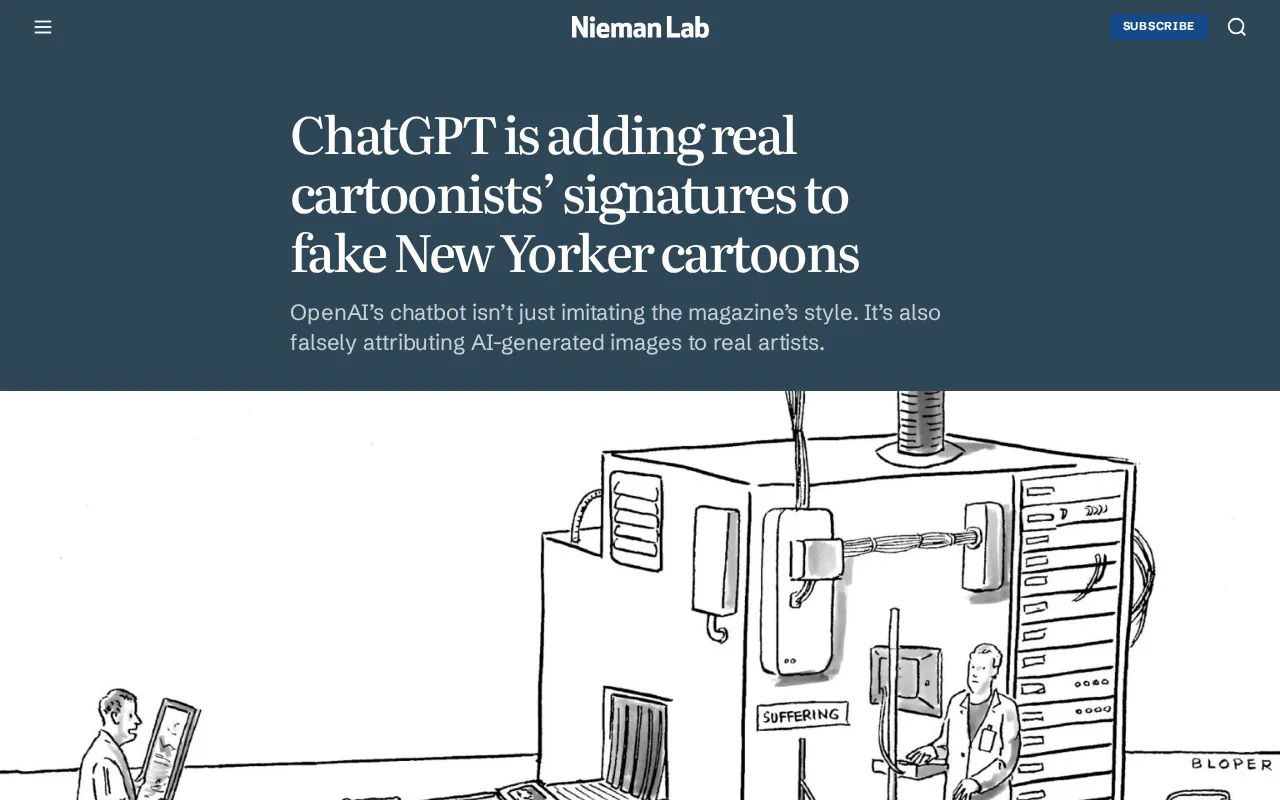
ChatGPT仿制《纽约客》漫画时复现真实作者签名,揭示生成式AI在版权与身份盗用上的深层风险。
ChatGPT在生成仿《纽约客》风格漫画时,会将真实漫画家的签名附加其上,使问题从"风格模仿"升级为"身份盗用"。这一现象的技术根源在于模型对训练数据的记忆性再现——签名作为高度重复出现的局部特征,被模型与特定风格深度绑定并原样输出。对漫画家而言,这意味着未经授权的"背书",可能损害声誉并侵犯姓名权;对OpenAI及《纽约客》母公司康泰纳仕而言,则同时引发版权与品牌保护层面的法律风险。业界应对方向包括输出端的签名过滤、训练数据的去标识化处理,以及AI生成内容的合成标注,但现有防护在签名这一细粒度层面仍存在明显漏洞。
事件概述
近日一则在Hacker News上引发讨论的消息指出:ChatGPT在生成仿《纽约客》(The New Yorker)风格的漫画时,会在图片中加入真实漫画家的签名。这意味着AI不仅模仿了知名刊物的视觉风格,还把在世或已故漫画家的个人署名直接复制到了从未由他们创作的作品上。
这一现象触及了生成式AI版权与署名伦理的核心痛点——当模型学习了大量受版权保护的作品后,它不仅会复刻风格,还可能"原样吐出"训练数据中的敏感元素,包括本应属于创作者个人身份标识的签名。
为什么签名问题格外敏感
签名等于身份与背书
漫画家的签名并非普通图形,而是其身份的法律与声誉标识。当AI生成的"假《纽约客》漫画"上出现某位真实漫画家的签名时,相当于在未经授权的情况下,让这位艺术家为一件他从未参与的作品"背书"。
如果这些图像被误认为真迹并在网络传播,可能对漫画家的声誉造成损害,也可能构成对其姓名权和商标性权益的侵犯。
暴露训练数据的记忆问题
从技术角度看,模型能准确还原特定漫画家的签名,说明训练数据中包含了大量带签名的原始作品,且模型对这些细节产生了"记忆"(memorization)。这类记忆性输出是生成式模型长期被诟病的隐患之一——它表明模型并非单纯"学习抽象风格",而是某种意义上存储并再现了具体的受保护内容。
模型记忆(memorization)在学术上通常分为两类:逐字记忆(verbatim memorization)指模型能几乎原样复现训练集中的特定样本;模板式记忆(template memorization)则指模型记住了某种高度重复的结构或风格模式。漫画家签名的复现属于前者——签名作为图像中高度独特且反复出现的局部特征,会被模型以较高置信度与特定风格绑定存储。研究者已发现,训练数据中某类样本出现次数越多,模型对其细节的记忆程度越高(即"记忆与重复频率正相关")。这也解释了为何越是知名、作品量大的漫画家,其签名越容易被模型准确还原。现有的差分隐私(Differential Privacy)等训练技术理论上可抑制此类记忆,但会以牺牲模型生成质量为代价,目前大型图像生成模型鲜少将其作为标准训练配置。
版权与品牌双重风险
《纽约客》的漫画是该刊物最具辨识度的品牌资产之一,拥有独特的构图、线条和幽默调性。AI批量仿制这种风格本身已处于版权灰色地带,而叠加真实署名后,风险从"风格模仿"升级为"身份盗用"。
对OpenAI等模型提供方而言,这类输出既可能招致漫画家个人的法律诉求,也可能引发《纽约客》母公司康泰纳仕(Condé Nast)在品牌保护层面的关注。此前多起针对AI公司的版权诉讼,正是围绕训练数据是否合法使用、输出是否构成侵权展开。
目前围绕AI生成内容的版权诉讼已形成若干标志性案例。Getty Images起诉Stability AI,指控其未经授权抓取数百万张受版权保护的图片用于训练,并在输出图像中出现Getty水印残影——与本文所述签名问题高度类似。此外,多位艺术家联合起诉Midjourney和DeviantArt,核心主张之一即"风格+署名元素"的组合输出构成对创作者衍生权(derivative work rights)的侵犯。这些诉讼尚未全部终审,但已促使部分法院开始讨论"AI训练是否构成合理使用"这一根本性问题。对OpenAI而言,图像生成领域的法律风险叠加签名盗用争议,意味着其面临的不仅是版权合规压力,还有更难量化的创作者社群信任损耗。
业界需要怎样的防护机制
从讨论中可以提炼出几个值得模型厂商重视的改进方向:
- 输出过滤:在图像生成环节识别并移除真实人名签名、水印、刊物logo等身份标识。
- 训练数据治理:对受版权保护的作品进行更谨慎的授权或去标识化处理。
- 溯源与标注:为AI生成内容添加清晰的合成标记,避免被误认为真迹。
这些措施并非全新概念,但该事件说明现有防护在"签名"这一细粒度层面仍有明显漏洞。
结语
虽然该话题在Hacker News上的讨论规模有限(82分、约10条评论),但它以一个具体而尖锐的案例,呈现了生成式AI在创作伦理上的灰色地带:模型能力越强,越容易在不经意间复现训练数据中的敏感元素。对于创作者权益保护和AI厂商合规而言,签名盗用都是一个不容忽视的信号。
(注:本文基于单一来源报道,具体技术细节与官方回应有待进一步核实。)
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。