ChatGPT与Codex共享额度:OpenAI未公布的关键细节

ChatGPT与Codex将共享用量池,即时聊天豁免,但各套餐token额度未公布。
OpenAI 帮助中心确认,2026 年 12 月起 ChatGPT 普通对话与 Codex 编程将共用同一个用量池,Plus、Pro 和 Business 用户均受影响,即时风格的快速聊天不占用该池。用量以 token 计量,消耗速度取决于模型与任务复杂度,重模型处理大型代码库会显著更快消耗预算。触及限额后仅有等待重置、升级套餐或购买 credits 三个选项。OpenAI 未公布变更确切日期与各套餐的 token 额度,任何精确数字均为猜测。文章另交叉验证了美团 LongCat 2.5 的全面发布,并提醒其参数声明存争议、基准为公司自报、开源权重尚未上线。
OpenAI 正在悄然改变付费用户的用量规则。从 2026 年 12 月起,ChatGPT 的日常对话与 Codex 的编程会话将共用同一个用量池,Plus、Pro 和 Business 用户都将受到影响。但最关键的细节——每个套餐到底包含多少 token——OpenAI 并未在帮助中心更新中透露。
共享用量池意味着什么?
根据 OpenAI 帮助中心 2026 年 10 月 31 日更新的《Understanding ChatGPT and Codex Usage Limits》文章,此前 ChatGPT 普通对话与 Codex 编程拥有各自独立的额度池。你可以用完对话额度而不影响编程额度,反之亦然。Codex 与 ChatGPT 内部的工作工具原本已经共享一个池,而 12 月的变更将把普通对话也拉入这个池中。
换句话说,聊天与编程之间的额度墙将被拆除。OpenAI 明确表示用量以 token 计量——模型读写的最小文本单位。你发送的每个提示和收到的每个回答都会消耗 token。这就是为什么额度不以消息数或分钟数计算,而是以 token 计算。
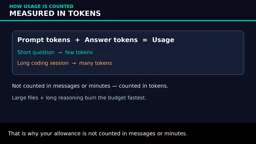
不同任务消耗 token 的速度差异巨大。一个简短问题消耗很少,而处理大文件、长推理的编码会话则消耗巨大。预算消耗速度取决于两个因素:你选择的模型和交给它的任务。更重的模型进行深度推理或处理大型代码库,会比轻量模型回答简单问题消耗更多 token。
Token 与上下文窗口
Token 是语言模型处理文本的最小单位,通常一个英文单词对应 1 个 token 左右,中文则约 1.5–2 个字符对应 1 个 token。模型每次推理都需要将输入文本切分为 token,再逐个生成输出 token,因此计费与限额普遍以 token 为基准。与 token 密切相关的概念是上下文窗口(context window),即模型单次会话中能够“记住”的最大 token 数,包括输入与输出。上下文窗口越大,模型可一次性处理的长文档、大型代码库就越多,但每次请求消耗的 token 也相应增加。理解 token 与上下文窗口的区别,有助于判断为何长代理任务(multi-step agent)会比单轮问答消耗更多预算:代理需要反复读写中间结果,每一步都叠加 token 开销。
一个重要的例外:即时聊天不占用额度
OpenAI 表示,即时风格的快速聊天(instant chat)不会从共享池中扣除用量。如果你只需要快速答案并使用即时聊天,它不应消耗你用于长对话或 Codex 编程会话的预算。这个例外值得记住——12 月之后,它可能成为你处理小问题的首选方式。
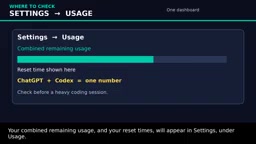
OpenAI 还表示,你将在设置中的“用量”页面看到完整的剩余用量和重置时间。这一点很重要,因为一旦聊天和编程共享一个池,你需要一个统一的仪表盘,而不是两个猜测。在 12 月之前,养成查看用量屏幕的习惯,了解共享额度还剩多少、何时重置,以便围绕它规划重度编程工作。
即时聊天(Instant Chat)的定位
即时聊天通常指 ChatGPT 中面向快速问答的轻量模式,其特点是低延迟、简短回答,背后往往由较小或经过蒸馏的模型驱动,而非完整推理模型。与之相对的是深度推理模式(如 o 系列或带“思考”按钮的模型),后者会在回答前生成内部推理 token,耗时更长、消耗更大。OpenAI 将即时聊天排除在共享池之外,实质是鼓励用户把简单查询分流到低成本通道,从而把共享预算留给长对话与 Codex 编程会话。这一设计也意味着,用户需要主动判断任务复杂度:事实查询、简短改写适合即时聊天;多轮调试、代码生成则更适合消耗共享额度的重型模型。
触及限额后的三个选项
根据 OpenAI 的说法,触及限额后你有三个选择:等待重置、升级套餐,或为符合条件的特性购买 credits。帮助中心的措辞中没有第四个选项。如果你依赖 Codex 完成日常工作,不要让大型编程任务落在用量周期末尾而没有备用计划,因为等待重置可能会暂停你的工作。
OpenAI 自己的说法是,它预计大多数用户需要等待的频率不会比现在更高。这是 OpenAI 的预期,不是保证,也不是对你账户的承诺。如果你是轻度用户,这个预期可能成立;如果你是重度 Codex 用户,或每天运行长时间代理会话,你应该在 12 月密切关注用量屏幕,并根据自己的数据判断。
OpenAI 留下的空白
这是最关键的部分:OpenAI 没有公布 12 月变更的具体开始日期,也没有公布每个套餐在新共享池下的额度大小。我们不知道 Plus、Pro 或 Business 各获得多少 token。在 OpenAI 公布这些数字之前,任何声称知道 12 月具体 token 数量的视频都是在猜测。
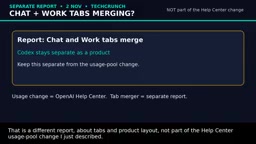
另一个需要区分的报道:TechCrunch 在 11 月 2 日的一篇独立报道称,OpenAI 正在合并 ChatGPT 的 Chat 和 Work 标签页,而 Codex 作为产品保持独立。这是关于标签页和产品布局的不同报道,不属于帮助中心用量池变更的一部分。用量变更由 OpenAI 帮助中心确认,标签页合并是另一则 11 月报道,不要将两者混为一谈。
多源交叉验证:美团 LongCat 2.5 的发布
在另一个独立事件中,美团于 2026 年 11 月 1 日至 2 日全面发布了 LongCat 2.5 模型。据多个来源报道,LongCat 2.5 并非全新模型——它早在 9 月 25 日就以 API 预览形式存在。此次新在全面发布。美团将其描述为面向长周期代理任务的原生多模态模型,代理可以在多步骤、多工具、多检查中持续运行,而非回答一个简短问题。
美团列出 1.6 万亿总参数,每 token 约激活 480 亿。但需要谨慎:10 月 29 日的一篇报道指出,这些数字沿用自 LongCat 2.0 的模型卡,因此参数声明存在争议,尚未定论。更清晰的是上下文窗口:100 万 token 上下文,最多 12.8 万 token 输出。
美团还表示,LongCat 2.5 使用更长的代理动作序列训练,包括包含失败的序列,使代理学会恢复并继续,而不仅仅是遵循完美路径。模型针对中国国产芯片优化,指向一款设计为在中国境内硬件上良好运行的模型。
LongCat 2.5 目前可通过 LongCat Chat 网站(longcat.chat)和 LongCat API 使用。美团称 API 兼容 Claude Code、Codex 和 Hermes 工具,明确面向已使用编程代理的开发者。开源权重发布计划被描述为“即将到来”,尚未上线。如果你看到声称开源权重已在 GitHub 上的帖子,那是超前于事实的。
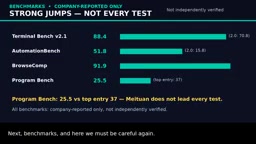
基准测试方面,所有数字均为公司报告,未经独立验证。美团报告 Terminal Bench 2.1 为 88.4,高于 2.0 的 70.8;Automation Bench 为 51.8,高于 15.8;BrowseComp 为 91.9。如果这些数字成立,是强劲跃升。但美团并非领先所有测试——在 Program Bench 上,LongCat 2.5 得分为 25.5,而最高条目为 37。
价格方面,美团列出限时 API 定价:输入每百万 token 30 美分,缓存输入每百万 token 0.6 美分,输出每百万 token 1.20 美元。这是限时价格,应视为开放测试而非永久费率。比较代理模型成本时,记住长代理任务消耗大量 token,因此每百万价格和每任务总 token 数都重要,而不仅仅是标价。
混合专家(MoE)架构与“总参数/激活参数”
LongCat 2.5 公布的“1.6 万亿总参数、每 token 约激活 480 亿”是典型的混合专家(Mixture-of-Experts, MoE)架构表述。MoE 模型由多个专家子网络和一个路由机制组成,每次前向传播只激活部分专家,因此总参数量可以远大于单次计算实际用到的参数量。总参数决定模型容量上限,激活参数则更直接影响推理算力与成本。这也解释了为何参数声明容易引发争议:不同来源可能混淆总参数与激活参数,或沿用旧版模型卡。评估 MoE 模型时,应同时关注总参数、激活参数、训练数据与上下文窗口,而非仅看单一数字。
需要关注但尚未发生的事
Qwen 4 仍未发布。有报道称 11 月 2 日至 8 日窗口,但这只是报道阶段的言论,没有官方确认,不要将 Qwen 4 视为已发布。Kimi K3.1 Pro 开源权重定于 11 月 4 日,但尚无仓库。当日期到来时,检查实际仓库再相信任何下载链接。
你应该做什么
如果你同时使用 ChatGPT 和 Codex,现在就开始关注用量屏幕,思考哪些工作适合即时聊天、哪些适合轻量模型、哪些重度编程任务值得消耗完整的共享预算。如果你关注代理模型,用同样的纪律观察 LongCat 2.5:测试实时聊天和 API,等待独立基准验证,等待真正的 GitHub 发布再称其为开源。
12 月起,ChatGPT 和 Codex 共享一个预算,即时聊天保持豁免,而预算的确切大小仍未公布。LongCat 2.5 已全面发布,拥有大上下文、混合基准表现,开源发布仍待到来。
Credits 与用量重置机制
OpenAI 提到的“为符合条件的特性购买 credits”,是指超出套餐限额后按需购买的额外用量额度,通常以 token 或请求数为单位计价,并与特定功能(如 Codex 编程会话)绑定。Credits 与套餐内包含的用量不同:套餐额度按周期重置,未用完通常不结转;credits 则是付费增量,有效期与适用范围以官方条款为准。触及限额后的三个选项——等待重置、升级套餐、购买 credits——分别对应时间成本、订阅成本与按量成本。对于依赖 Codex 的重度用户,提前估算单次编程会话的 token 消耗,并在周期前段安排重任务,比在周期末尾被动等待重置更可控。
相关推荐

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。

AI Agent实战教程:从零搭建企业级智能体
从传统程序与智能体的本质区别讲起,系统解析智能体的感知、决策、行动核心闭环,梳理规则引擎到大模型+工具调用+记忆系统的技术演进,并拆解企业级智能体的四大技术栈与典型应用场景,适合零基础入门。