成员推断攻击的幻觉:语言模型真的记住了训练数据吗

语言模型的成员推断信号在真实条件下几乎为零,看似有效的检测结果均源于方法论缺陷。
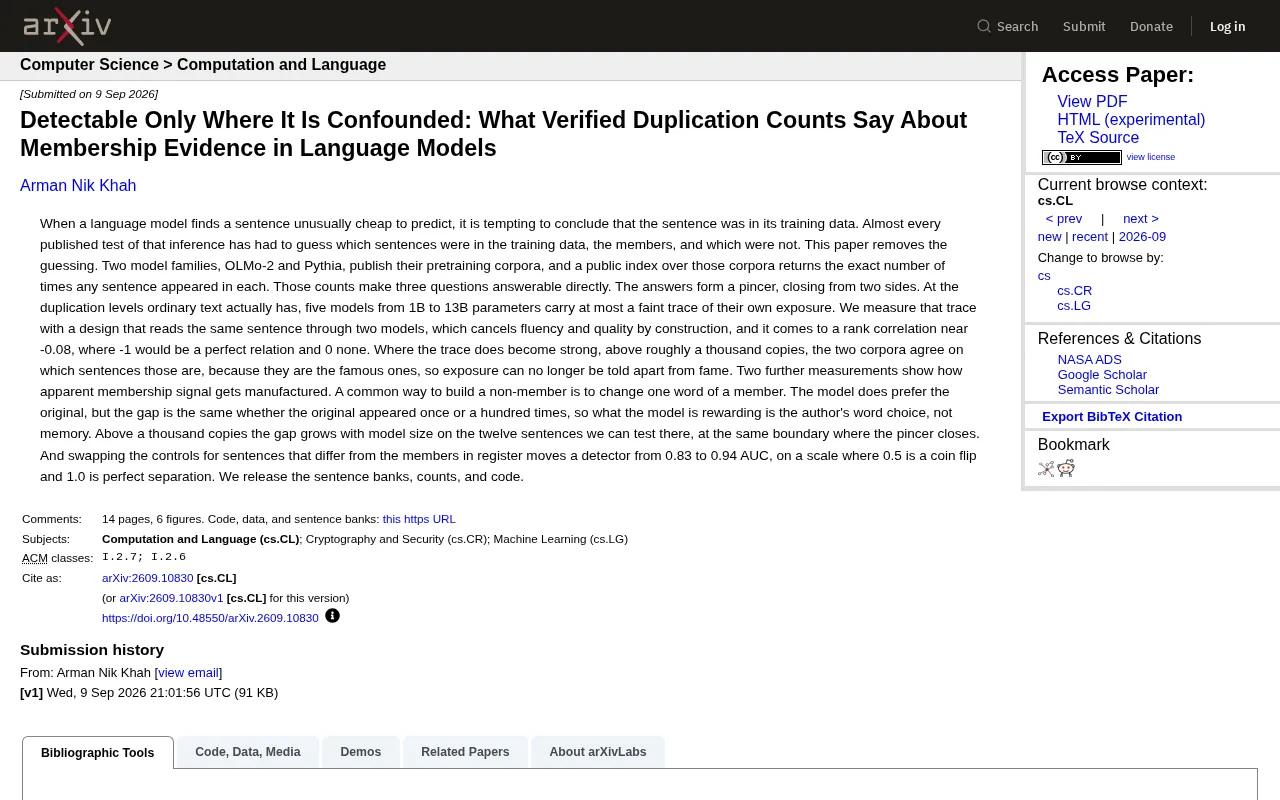
一篇新 arXiv 论文利用公开预训练语料(OLMo-2 与 Pythia)及可精确查询文本重复次数的索引,首次以真实标签系统评估了成员推断攻击(MIA)的有效性。核心发现是一把"钳子":在普通文本的真实重复水平下,模型对"是否见过某句话"的可检测痕迹极其微弱(秩相关约 -0.08);而在重复次数超过千次的高重复区间,训练暴露信号虽然显著,却与文本的社会知名度完全混淆,无法区分。论文进一步揭示,两类常见做法——换词法构造非成员、使用不同语域的对照句——都会人为夸大检测性能(AUC 从 0.83 飙升至 0.94),但这些"成功"检测的是措辞习惯和文体差异,而非模型记忆。这对以 MIA 为技术基础的隐私审计和版权诉讼提出了严肃警告。
一个诱人却危险的推论
当一个语言模型对某个句子的预测异常"轻松"时——也就是这个句子的困惑度(perplexity)极低——研究者往往会得出一个直觉性的结论:这个句子一定在模型的训练数据里。这类推断构成了**成员推断攻击(Membership Inference Attack, MIA)**的核心逻辑,也是隐私审计、版权争议和数据污染检测等一系列热门议题的技术基石。
然而,几乎所有已发表的成员推断测试都存在一个致命的方法论缺陷:它们不得不去"猜测"哪些句子在训练数据中,哪些不在。 由于绝大多数模型的预训练语料是闭源的,研究者只能依赖启发式方法构造"成员"(members)与"非成员"(non-members),而这种猜测本身就可能引入系统性偏差。
一篇新发布的 arXiv 论文(arXiv:2609.10830)正是要"移除这种猜测"。作者利用了两个公开预训练语料的模型家族——OLMo-2 和 Pythia——以及一个覆盖这些语料的公开索引,可以精确返回任意句子在语料中出现的确切次数。这一经过验证的重复计数,让原本模糊的成员推断问题第一次有了直接答案。
双向合围:成员推断信号几乎不存在
论文的核心发现被作者形象地称为一把"钳子"(pincer),从两侧同时合围,压缩了"模型记忆可被检测"这一命题的生存空间。
普通文本:几乎读不到训练暴露痕迹
在普通文本实际具有的重复水平下,从 1B 到 13B 参数的五个模型,对其"自身曾经见过的内容"至多只携带一丝微弱的痕迹。为了排除句子本身流畅度和质量的干扰,作者设计了一个巧妙的方法:用两个不同的模型读取同一个句子,通过对比在构造上抵消掉流畅度与文本质量的影响。
结果令人警醒——这种痕迹的秩相关系数(rank correlation)仅约为 -0.08。在这个尺度上,-1 代表完美相关,0 代表毫无关系。换句话说,在真实文本的重复分布下,模型"是否见过某句话"与它预测该句子的难易程度之间,几乎没有可靠的联系。
高重复文本:训练暴露与"名气"无法区分
那么成员推断信号在哪里变强?答案是:当句子的重复次数超过约一千次时,痕迹确实变得显著。但这里出现了第二重合围——两个语料对"哪些句子是高重复的"高度一致。原因很简单:这些高重复句子往往是那些"名句",它们在互联网上被反复引用、广泛传播。
于是问题来了:当一个句子既在训练数据里反复出现、又在整个文化语境中广为人知时,模型的低困惑度究竟来自"训练暴露"还是来自"名气"?两者已无法被区分。 检测器看似捕捉到了成员信号,实则捕捉到的是文本的知名度。
虚假成员信号是如何被"制造"出来的
论文进一步揭示了两种常见做法如何人为制造出虚假的成员推断信号,这对整个 MIA 研究领域是一次尖锐的方法论反思。
换词法:奖励的是作者措辞而非模型记忆
构造非成员的一种常见做法是:拿一个成员句子,修改其中一个词,得到一个"看起来像但不在训练集里"的对照句。实验确实显示模型更偏好原句。但关键在于——无论原句在语料中出现过一次还是一百次,这个偏好差距都是一样的。
这意味着模型奖励的并不是"记忆",而是作者的用词选择:原句用的词更符合语言的自然分布,改动后的词让句子变得别扭。这个偏好与是否真正"见过"无关。只有在重复次数超过一千次时,这个差距才开始随模型规模增长——但那正是前述钳子合围、训练暴露与名气纠缠不清的边界地带。
对照句的语域陷阱:从 0.83 到 0.94 的虚高AUC
更能说明问题的是第二个实验。当研究者把对照句替换为语域(register)与成员句不同的句子时,一个 MIA 检测器的 AUC 从 0.83 一路飙升到 0.94。在这个尺度上,0.5 相当于随机猜测,1.0 是完美分离。
0.94 的 AUC 看起来是一个相当强的检测器,足以让人相信"模型的记忆是可检测的"。但真相是:检测器根本没在检测记忆,它只是在检测成员句与非成员句之间的文体与语域差异。只要对照句的分布与成员句不匹配,检测性能就会被系统性地夸大。这也解释了为何过去许多成员推断攻击研究报告了乐观的检测结果——它们的"成功"很可能建立在有偏的对照集之上。
对隐私审计与AI版权争议的启示
这项工作的意义远超一篇技术论文的范畴。近年来,从新闻机构起诉 AI 公司使用其内容训练模型,到用户担忧个人数据被语言模型记忆,成员推断攻击被广泛视为一种可以"证明模型看过某段文本"的技术手段。
但本研究给出的结论相当克制:在真实文本的重复水平下,语言模型对自身训练暴露的可检测痕迹微乎其微(秩相关约 -0.08)。 那些看似有效的检测结果,要么落在训练暴露与名气无法区分的高重复区间,要么是由有偏的对照集人为放大的。
这提醒我们,在把成员推断攻击的结果作为法律或政策证据时必须格外谨慎——一个高 AUC 数字,可能只是文体差异的伪影,而非真正的模型记忆证据。
值得称道的是,作者公开了句子库、重复计数与全部代码,为后续研究提供了可复现的基准。这种以"验证过的真实标签"取代"猜测"的实验范式,或许才是成员推断研究走向严谨的正确方向。
结语
这篇论文的标题本身就是它的结论:"仅在被混淆处才可检测"(Detectable Only Where It Is Confounded)。 语言模型的成员信号并非不存在,而是只有在与名气、语域、措辞等混杂因素纠缠时才显得强大——一旦剥离这些混淆因素,真正归因于"记忆"的信号便近乎消失。对于任何试图用困惑度来判断"模型是否见过某段文本"的人来说,这都是一个必须正视的现实。
相关推荐
MiniMax H3 开源视频模型本地部署实测:8G显存即可玩转
MiniMax H3 最新开源视频生成模型本地部署实测教程,支持文生视频、图生视频与首尾帧控制。8G显存即可运行,含ComfyUI部署流程、量化版本选择与实际应用效果分析。
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。