离谱的开源模型命名:从Qwen魔改版看社区乱象

一个荒诞超长的开源模型名在Reddit走红,折射出微调社区命名混乱的集体困境。
Reddit本地大模型社区流传的超长模型名`Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF`引发广泛共鸣。文章逐一拆解其中各标签的含义:GGUF是真实的量化格式,27B是参数规模,而TURBO/MAX/NEO等则是无技术定义的营销词汇,Uncensored代表去除安全对齐,Cold-Fusion等词对应特定的模型合并配方。这一乱象的根源在于Hugging Face等平台缺乏命名规范,加之模型合并技术门槛低、风靡社区,创作者为提高可见度竞相在名称里堆砌关键词。过度冗长的命名带来了可发现性下降、可复现性差和信任成本上升等实际问题。对普通用户的建议是:聚焦基础模型、参数规模和量化格式三项核心信息,其余标签仅供参考。
一个让人哭笑不得的模型名字
最近在Reddit的本地大模型社区流传着这样一个模型名称:Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF。发帖人只配了一句话:"it be like that"(事情就是这样)。
这条帖子之所以引发共鸣,是因为它精准戳中了开源模型社区一个长期存在的现象——魔改模型的命名正在变得越来越冗长、越来越离谱。这个名字堆砌了至少十几个标签,几乎把能加的后缀全加上了,读起来更像是一串关键词的随机组合,而非一个正经的模型标识。
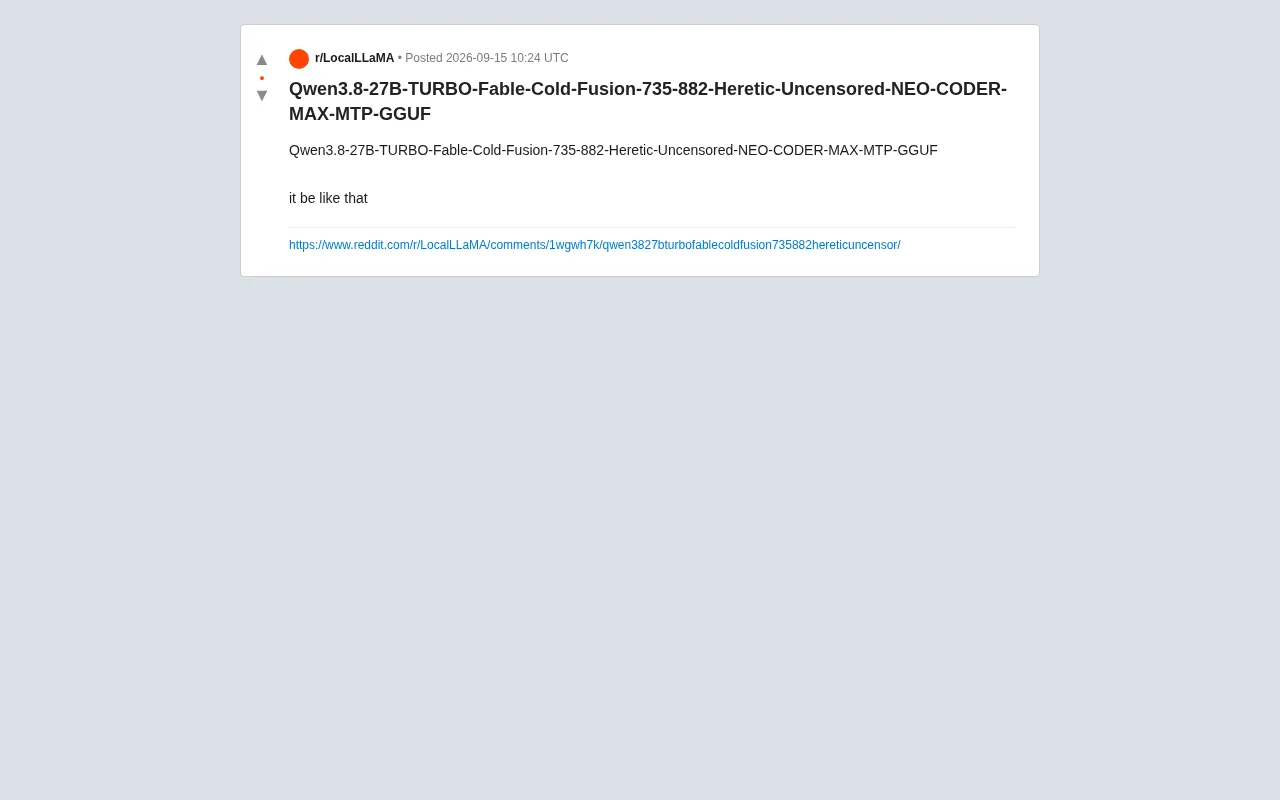
需要说明的是,这个具体名称大概率是社区调侃式的夸张产物,并非官方发布。它以一种黑色幽默的方式,把当前微调模型命名的混乱状态浓缩到了一行文字里。
拆解这串"缝合怪"名称
把这个名字拆开看,每个片段其实都对应着社区中真实存在的命名习惯:
基础模型与规模
- Qwen3.8:暗示基于阿里通义千问(Qwen)系列,版本号本身就带着夸张成分。
- 27B:模型参数量,270亿参数属于中等规模。
- GGUF:这是真实存在的量化格式,由 llama.cpp 项目定义,用于在本地设备上高效运行模型。
GGUF 格式由 llama.cpp 项目于2023年引入,取代了此前的 GGML 格式。它将模型权重、超参数、词表等所有必要信息打包进单一文件,并支持多种量化精度(如 Q4_K_M、Q8_0 等),使普通消费级 GPU 甚至 CPU 也能运行数十亿参数的大模型。量化的核心思路是用更低位数的整数近似表示原始的浮点权重,以此换取更小的显存占用和更快的推理速度,代价是模型精度有一定损失。GGUF 文件名通常会直接标注量化级别,因此是模型名称中少数具有明确技术意义的后缀之一。
各种"性能"与"特性"后缀
- TURBO / MAX / NEO:这类词汇本身没有技术定义,纯粹是营销式的"更强"暗示。
- Cold-Fusion / Fable:往往指代模型合并(merge)技术或特定的微调数据集配方名称。
- Heretic / Uncensored:表示这是"去审查"版本,移除了原模型的安全对齐限制。
- CODER:暗示针对代码任务做了优化。
- MTP:可能指 Multi-Token Prediction(多token预测)等技术特性。
- 735-882:这类数字组合通常是模型合并时的层数配比或版本迭代编号。
把这些元素叠加在一起,就得到了一个信息过载却又难以解读的名字。
模型合并(Model Merging)是指将两个或多个已训练模型的权重按某种算法融合,得到一个新模型,而无需重新训练。常见方法包括 SLERP(球面线性插值)、TIES-Merging(修剪冲突参数后合并)和 DARE(随机丢弃部分权重后合并)等。合并的吸引力在于成本极低——无需 GPU 算力,只需对权重文件做数学运算——因此在社区中极为流行。"Cold-Fusion""Fable"等词往往是某次特定合并实验的自定义配方名,记录了参与合并的模型组合与层权重比例,但若不附上完整配置文件,仅凭名称几乎无法复现。数字串如"735-882"通常正是这类配方版本号或层插值比例的痕迹。
为什么模型命名会失控
这种现象的背后,是开源微调生态的高度活跃与缺乏规范并存。
在 Hugging Face 等平台上,任何人都可以上传自己微调或合并的模型。为了在海量模型中脱颖而出,也为了向潜在使用者"一目了然"地传达模型特点,创作者倾向于把所有卖点都塞进名字里:基础模型是什么、参数多大、用了什么合并方法、是否去审查、擅长什么任务、量化格式是什么……
当模型合并(model merging)技术流行后,情况进一步恶化。合并模型本身就是多个模型的"缝合",其命名自然也倾向于把各个来源模型的名字拼接起来,层层叠加之下,名称长度指数级增长。
Hugging Face 作为当前最主流的开源模型托管平台,截至2024年已托管超过100万个模型仓库,其中相当大比例是社区微调或合并的衍生模型。平台本身并未强制规范命名格式,模型的可见度主要依赖搜索关键词匹配和下载量排名。这在客观上激励创作者将尽可能多的描述性词汇塞入模型名,形成一种"关键词堆砌"的军备竞赛。与之形成对比的是,学术界和大型实验室发布模型时通常遵循简洁的内部命名规范(如 GPT-4、Llama-3-8B),因为它们依靠品牌认知度而非名称本身来传递信息。
长名字带来的真实困扰
看似只是玩笑,但过度冗长的命名确实制造了实际问题:
可发现性下降:名字里堆满关键词,反而让人抓不住重点,难以判断模型到底适合什么场景。
可复现性差:像735-882这样的数字,如果作者不专门说明,外人根本无法理解其含义,也就无从复现或验证。
信任成本上升:Uncensored、TURBO这类词汇缺乏统一标准,使用者很难仅凭名字判断模型的真实质量和安全边界。
对于想在本地部署模型的开发者和爱好者来说,面对这样的命名,往往需要额外花时间去阅读模型卡(model card)才能搞清楚它到底是什么。
社区的自嘲与反思
这条帖子能引起广泛共鸣,说明社区成员对这种现象心知肚明。用一句轻描淡写的"it be like that"来收尾,既是无奈,也是一种集体自嘲。
从更积极的角度看,这类调侃其实是社区自我修正的信号。当命名混乱到了成为笑柄的程度,也许会推动更多创作者回归简洁、规范的命名习惯——用清晰的模型卡说明技术细节,而不是把一切都塞进文件名。
对于普通用户,面对这类"缝合怪"模型时的建议也很实际:不要被花哨的后缀迷惑,重点看基础模型、参数规模、量化格式这三项核心信息,其余标签仅作参考,实际效果还需自己测试验证。
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
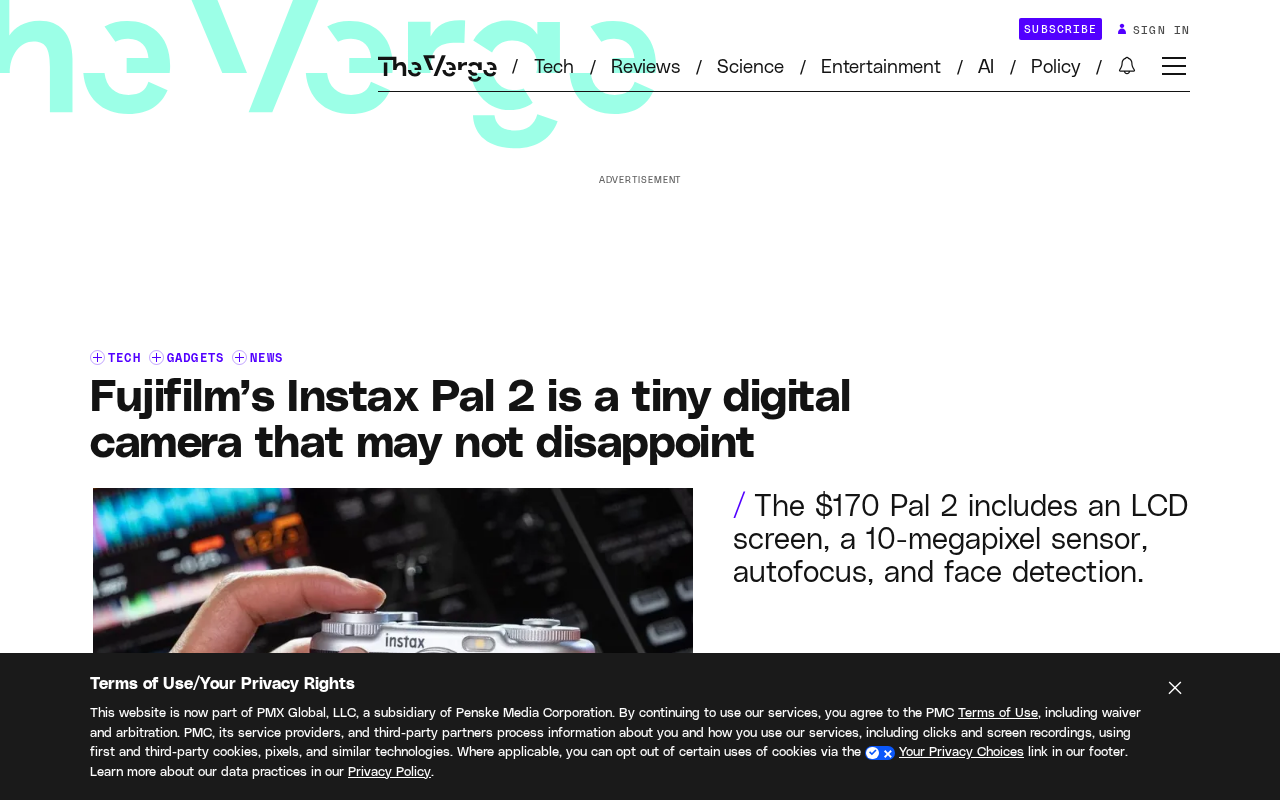
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
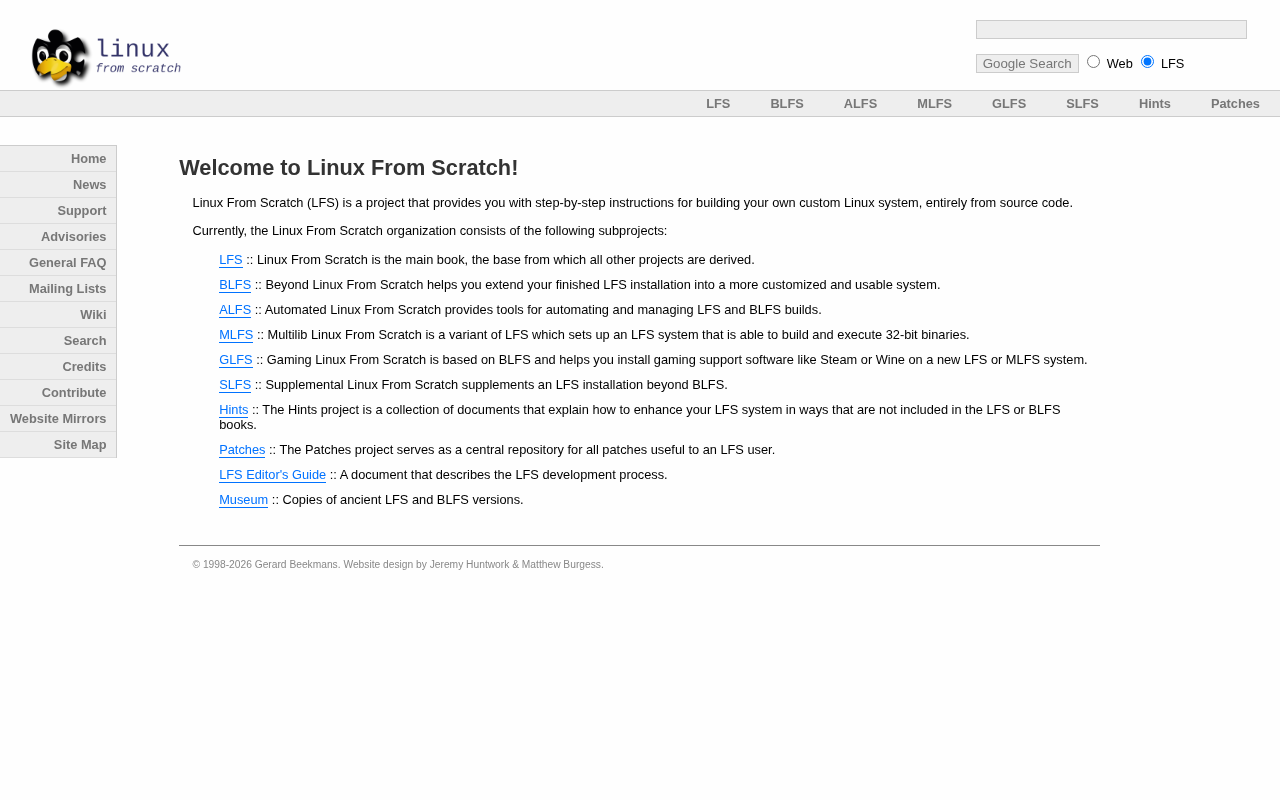
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。