CHO-Bench:上下文提示如何影响LLM广告排名?

CHO-Bench将LLM广告的上下文提示写作量化为优化问题,揭示排序器偏好分化与预算边际递减。
文章介绍了CHO-Bench这一离线基准,它把LLM对话广告中广告主撰写“上下文提示”的经验性问题转化为可量化的优化任务(CHO)。研究定义了在预算约束下构造提示以提升广告排名的目标,设计了覆盖What、Who、When三个维度的七种生成策略及一个Unified策略,并在五个数据集上完成超过119万次配对评估。结果显示:上下文提示确实能提升排名,但单策略平均增益相近,Unified策略无持续优势;基于嵌入与基于LLM的排序器偏好不同信息维度,不存在通用最优写法;增加提示预算可继续提升排名但边际收益递减。研究据此提出模型特定的提示选择与预算感知的生成聚合方向,同时指出结论限于所评估的离线排序环境。
随着LLM对话逐渐成为用户获取信息与服务的入口,广告的投放逻辑也在发生变化。传统搜索广告依赖用户输入的关键词,而LLM广告面对的是开放式的对话——用户的需求可能根本不会以“买某物”的形式出现。ChatGPT Ads允许广告主提供一段自然语言描述的“上下文提示”,说明自己提供什么、谁可能用得上、什么场景下有用,作为广告排序的额外依据。但这段提示到底该怎么写,目前并没有答案。CHO-Bench的提出,正是为了把这个问题变成可以量化研究的问题。
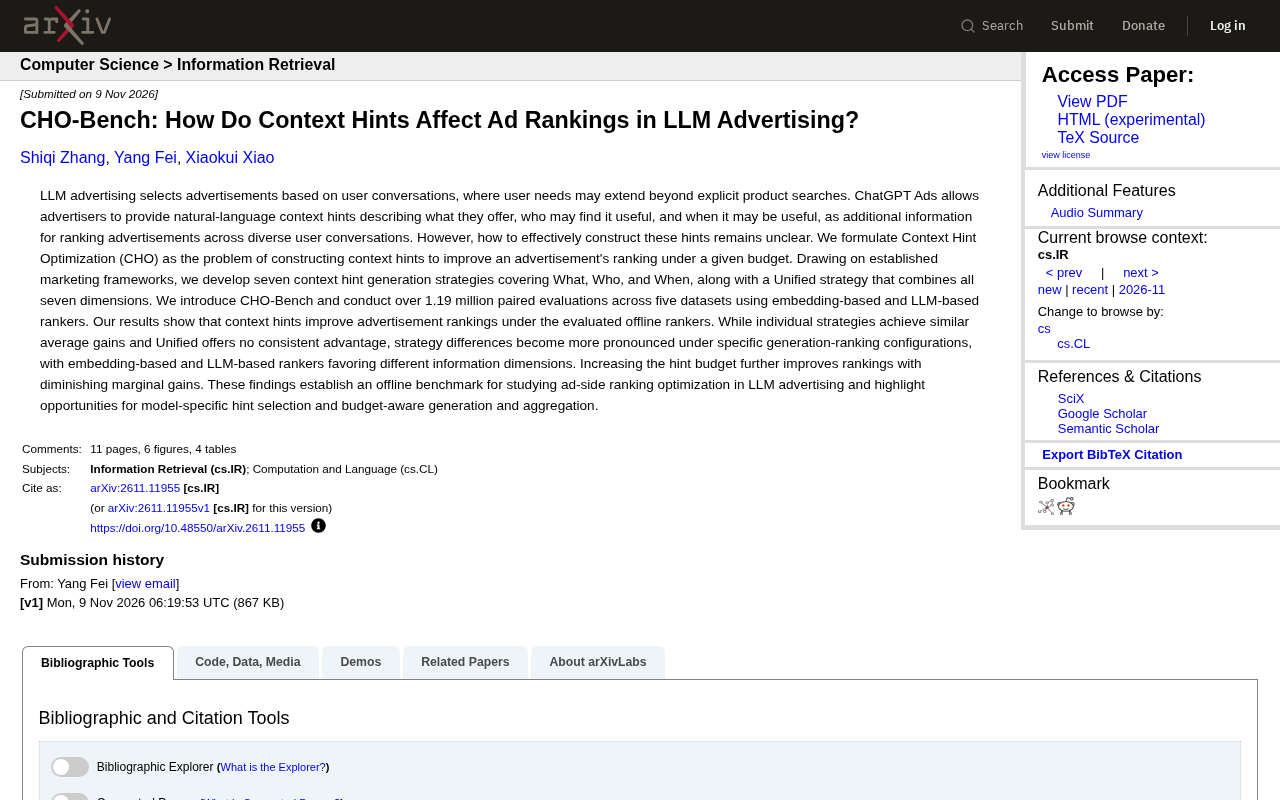
上下文提示优化:把“怎么写广告描述”变成可求解问题
研究将“上下文提示优化”(Context Hint Optimization,CHO)定义为:在给定预算下,构造上下文提示以提升广告排名的任务。这个定义有两层含义。一层是效果导向——提示的最终目的是让广告在相关对话中获得更好的排序位置;另一层是约束导向——提示不能无限膨胀,生成提示本身有成本,预算有限。
这实际上是把广告主在LLM广告中的核心操作抽象成了一个优化问题。与关键词竞价不同,广告主不再只是选择“买哪些词”,而是要用自然语言主动表达自己的适用场景。表达得好不好,直接影响到广告能否被系统识别为与当前对话相关。
ChatGPT Ads 与上下文提示的背景
ChatGPT Ads 是 OpenAI 在对话式产品中探索的广告形式:广告不再附着于搜索结果页的关键词,而是出现在用户与 LLM 的自然对话流程中。由于对话内容往往并不包含明确的购买意图表达,系统需要额外的信号来判断某条广告是否与当前对话相关。广告主提供的“上下文提示”(context hint)正是这样一种信号——一段由广告主撰写的自然语言说明,描述自己提供什么、适合谁、在什么场景下有用。排序系统会将这段提示与当前对话内容进行相关性比对,作为广告排序的额外依据之一。这也意味着,提示的写法本身成为广告主可以优化的变量,而这正是 CHO-Bench 试图系统研究的对象。
七种生成策略:围绕What、Who、When展开
研究借鉴成熟的营销框架,设计了七种上下文提示生成策略,覆盖三个维度:What(广告主提供什么)、Who(谁可能觉得有用)和When(什么时机下有用)。此外还有一个Unified策略,把七个维度的信息合并在一起生成提示。
这些策略的设计思路并不复杂:让广告主从不同角度描述自己的产品与服务。但研究关心的是,不同维度的信息在不同排序器下是否等效。毕竟LLM广告的排序可能由基于嵌入的相似度计算完成,也可能由LLM本身来判断相关性,两种机制对文本信息的敏感点未必相同。
119万次配对评估:提示确实能提升排名
为了验证效果,研究构建了CHO-Bench,并在五个数据集上进行了超过119万次配对评估,覆盖基于嵌入(embedding-based)和基于LLM(LLM-based)两类排序器。
核心结论是:在所评估的离线排序器下,上下文提示能够提升广告排名。这是一个偏积极的信号,说明广告主主动补充的信息确实会被排序系统利用。
但进一步的发现更值得注意。单个策略之间的平均增益相近,Unified策略也没有表现出持续优势——把所有维度的信息堆在一起,并不比只写一个维度更好。换句话说,提示的信息量和排名效果之间不是简单的加法关系。
配对评估与两类排序器
“配对评估”指的是将同一对话上下文与两条广告(或同一广告的两种提示版本)成对比较,由排序器给出相对偏好或排名,从而在无需真实投放的情况下量化提示的效果。这种设计使研究能够在受控条件下进行大规模重复实验,119 万次的规模也正是由此而来。
在排序器方面,基于嵌入(embedding-based)的方式将对话与广告提示分别编码为向量,通过余弦相似度等度量计算相关性;基于 LLM(LLM-based)的方式则直接把对话与广告信息放入提示词,由大模型判断相关性或给出排序。前者计算高效、成本低,后者语义理解更强但推理开销大。两者对文本特征的敏感点不同,这也是研究中排序器偏好出现分化的技术根源。
排序器偏好分化:嵌入模型和LLM各有所好
当研究深入到具体的“生成-排序”配置时,策略差异开始变得明显。基于嵌入的排序器和基于LLM的排序器偏好不同的信息维度。这意味着不存在一种通用的最优提示写法,广告主需要根据目标排序器的特性来选择提示内容。
这个发现对实际投放有直接含义:如果广告主不知道广告系统内部用什么方式判断相关性,就很难确定提示应该侧重What、Who还是When。研究由此提出的方向是“模型特定的提示选择”——针对不同排序机制定制提示策略。
预算的边际递减:写得更多,未必排得更高
研究还考察了提示预算的影响。增加提示预算可以进一步提升排名,但边际收益递减。这符合直觉:当提示已经足够清晰地表达广告主的核心信息后,继续追加内容带来的排序提升会越来越小。
这一结果把CHO问题从“如何写得更好”扩展到了“写多少才划算”。对于有成本约束的广告主而言,预算感知的生成与聚合策略可能是更实际的优化方向——不是追求信息最全,而是在有限预算下选择最有效的表达组合。
提示预算与边际收益递减
提示预算在此处指生成上下文提示所允许消耗的资源,通常以长度(token 数)或生成成本来衡量。研究中“预算增加带来排名提升但边际收益递减”的结论,与信息检索中的经典现象相呼应:当文本已经覆盖核心语义时,继续追加内容的增量信息有限,甚至可能引入噪声、稀释关键信号。对广告主而言,这意味着最优提示并非越长越全,而是在预算约束下选取信息密度最高的表达组合。这也解释了为何 Unified 策略把全部维度堆叠在一起却没有持续优势——它提高了预算消耗,却未必提高有效信息量。
离线基准的意义与边界
CHO-Bench的定位是一个离线基准,用于研究LLM广告中广告侧的排名优化。它提供了可复现的评估框架和跨数据集的大规模配对结果,让“上下文提示设计”这类偏经验性的问题有了可比较的量化基础。
补充一点,离线排序器与真实广告系统中的排序逻辑可能存在差异,研究结论反映的是所评估的离线环境下的表现。但即便如此,研究所揭示的排序器偏好分化和预算边际递减,已经为广告主和系统设计者提供了值得参考的方向:提示优化不是一次性写作,而是需要与排序机制、成本约束共同考虑的持续决策。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。