词比音素更高效?语言信息率研究揭示编码最优单元

960小时语料实验表明,有限建模预算下词及稍长单元的信息率最低、编码效率最高。
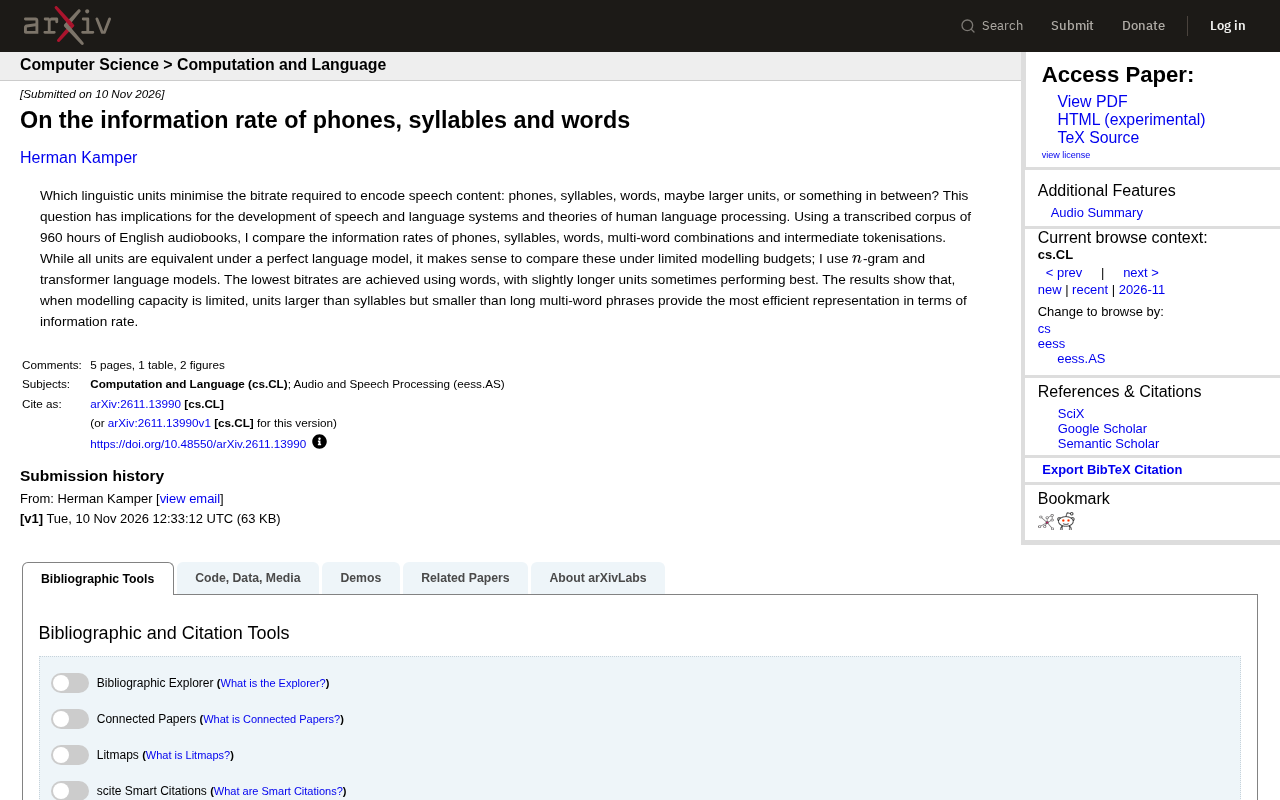
研究围绕“何种语言单元编码语音内容所需信息率最低”这一基础问题,利用960小时英语有声书转录语料,系统比较了音素、音节、词、多词组合及中间粒度单元在有限建模预算下的编码效率。作者以n-gram和Transformer两类语言模型模拟浅层与深层建模能力,通过交叉熵或压缩率等指标计算信息率。结果显示,词级单元信息率最低,稍长于词的多词组合有时更优,而音素与音节因序列长、长程依赖难捕捉导致信息率偏高,长多词短语则因数据稀疏而效率下降。研究强调理想无限模型下各单元等价,最优粒度依赖建模能力,结论对语音编码、文本压缩和语言模型设计具有参考价值。
在语音编码和语言处理中,一个根本性问题长期悬而未决:用什么样的语言单元来表征语音内容,所需的信息率最低? 音素、音节、词,还是更大的组合?这个问题不仅关乎语言系统的设计,也影响我们对人类语言处理机制的理解。
最近一项基于960小时英语有声书语料的研究,通过对比不同单元在有限建模预算下的信息率,给出了一个清晰的答案:词及稍长的单元在编码效率上表现最佳,而音节与多词短语则相对逊色。
研究背景:为什么关注信息率?
信息率衡量的是编码单位内容所需的比特数。在理想语言模型下,所有单元的信息率等价——因为完美模型可以无损压缩任何粒度的序列。但现实中的语言模型容量有限,不同单元在有限预算下的效率差异便凸显出来。
这项研究利用960小时英语有声书的转录语料,系统比较了音素、音节、词、多词组合以及中间粒度单元的信息率。作者采用n-gram和Transformer两类语言模型来模拟有限建模能力,从而评估各单元的实际编码效率。
信息率(Information Rate) 在信息论中通常指单位符号(或单位时间)所承载的平均信息量,常用香农熵来度量。在语言序列建模中,它等价于模型对每个单元的平均惊异度(surprisal),以比特为单位。若把一段语音内容视为待传输的消息,则信息率越低,意味着用更少比特就能无损(在模型假设下)重建该内容,编码效率越高。
需要区分的是,理想无限容量模型下的信息率是单元无关的。这是因为任何粒度序列都可以被完美压缩到其经验熵,而不同粒度只是对同一底层消息的不同切分,总信息量守恒。真正产生差异的是有限建模预算:当模型参数、训练数据或上下文窗口受限时,不同单元序列的可学习性与稀疏性不同,导致实际交叉熵出现分化。因此,文中所说的“信息率最低”应理解为在给定模型容量与语料规模下的经验编码成本,而非绝对的信息论下界。
核心发现:词是最佳平衡点
实验结果显示,在有限建模预算下,词级单元的信息率最低,即编码同样内容所需的比特数最少。稍长于词的单元(如常见多词组合)有时表现更优,但整体上词及邻近粒度占据了效率高点。
相比之下,音素和音节虽然单元数量少、组合灵活,但由于序列更长、模型难以捕捉长程依赖,信息率反而更高。而长多词短语则因数据稀疏、模型估计困难,效率下降。
这一结论与语言学理论中“词是语言处理核心单元”的观点相呼应,也为语音编码系统的设计提供了实证依据:在资源受限时,以词为基本单元进行建模可能更为高效。
方法细节:有限预算下的公平比较
研究的关键在于“有限建模预算”的设定。作者没有追求无限容量的理想模型,而是使用n-gram和Transformer两类实际模型,分别代表浅层统计学习和深层神经学习。通过控制模型容量,他们模拟了真实应用场景中的资源约束。
语料规模达到960小时,覆盖丰富的英语有声书内容,保证了统计的可靠性。单元类型包括音素、音节、词、多词组合以及介于词和短语之间的中间tokenisation。信息率通过交叉熵或压缩率等指标计算,确保不同单元间可比。
n-gram 语言模型基于马尔可夫假设,用前 n−1 个单元的条件频率估计下一个单元的概率,本质是浅层统计计数,对长程依赖的捕捉能力很弱,且面临严重的数据稀疏问题(需平滑或回退)。Transformer 语言模型则通过自注意力机制建模任意距离的依赖,参数量与上下文窗口可调,代表深层神经学习。两类模型分别对应“低容量、强局部统计”与“高容量、可学长程结构”两种极端,放在一起比较可以检验结论是否对建模方式稳健。
在跨单元比较时,还要注意序列长度与词表大小的权衡:音素词表小但序列长,词词表大但序列短。信息率按“每原始内容单位”归一化(如每字符或每秒语音的比特数),才能公平对比不同切分。中间粒度 tokenisation(如子词或介于词与短语之间的组合)正是为缓解词表稀疏与序列过长之间的矛盾而引入的折中方案。
对语言系统与认知的启示
这项研究对语音识别、文本压缩和语言模型设计具有直接参考价值。例如,在构建轻量级语音编码器时,选择词级单元可能比音素级更节省比特。同时,它也暗示人类语言处理可能倾向于以词为支点,因为词在有限认知资源下提供了最优的信息率平衡。
不过,作者也指出,在完美模型下所有单元等价,这意味着单元选择并非绝对,而是依赖于建模能力。随着模型容量提升,最优单元可能向更细或更粗的粒度漂移。未来工作可探索更多语言和模态下的信息率比较。
“词是语言处理核心单元” 在心理语言学中有长期证据支持:词汇识别研究显示,词是通达语义的主要接口,而音素和音节更多承担亚词汇的声学-语音编码功能。信息率视角为这一观点提供了新的量化解释——在有限认知资源(可类比为有限模型容量)下,以词为支点可以在序列长度与组合稀疏性之间取得较优平衡。
不过,这一解释需要谨慎对待**“完美模型下等价”** 的含义:它说明最优粒度并非语言本身的固有属性,而是建模约束的函数。随着模型容量与数据量提升,最优单元可能向更细粒度(充分利用子词规律)或更粗粒度(利用长程语义)漂移。这与神经语言模型中子词 tokenisation 广泛优于纯词级或纯字符级的经验一致,也提示语音编码系统的单元选择应随可用算力与数据规模动态调整。
结语
这项研究以扎实的语料和清晰的实验设计,回答了语言信息率的一个基础问题:在有限建模能力下,词及稍长单元是编码语音内容的最有效表示。这一发现不仅深化了我们对语言单元效率的理解,也为相关技术应用提供了量化依据。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
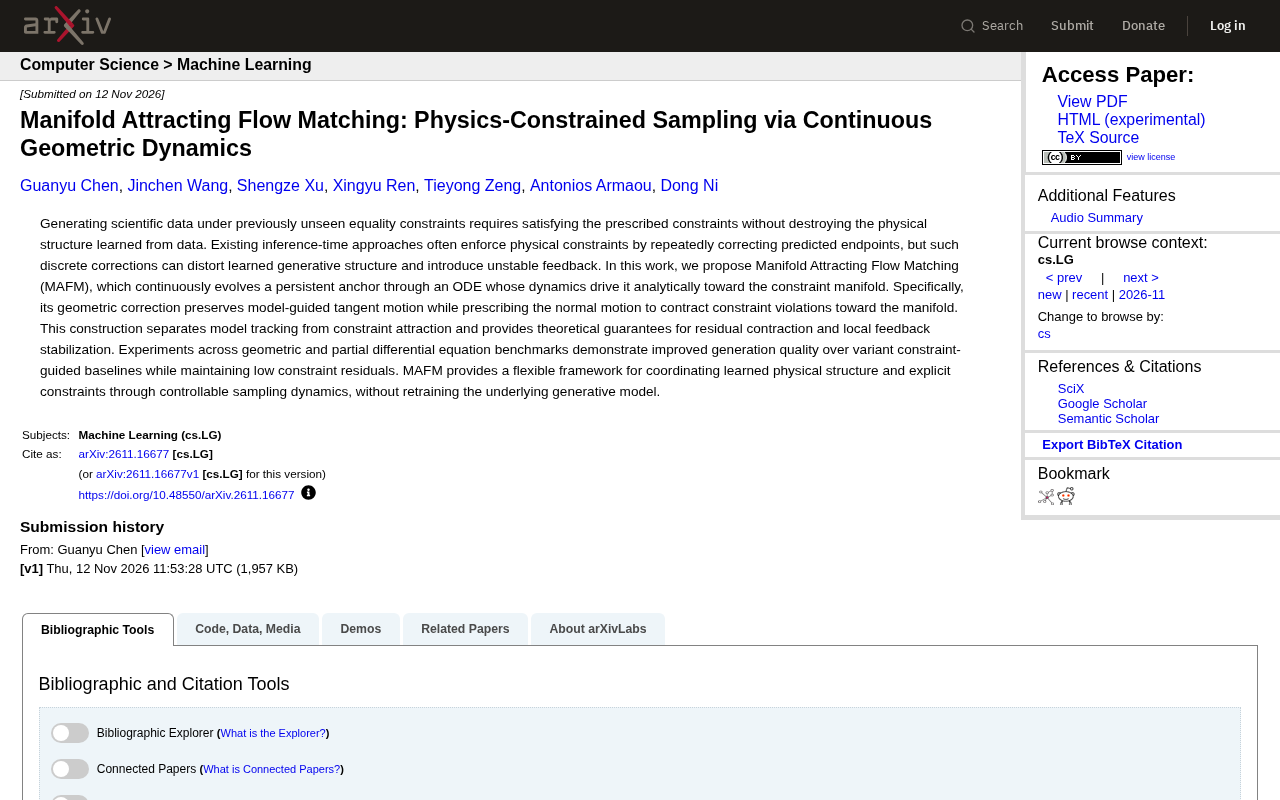
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。