Clarity:实时语音增强,让AI只听见说话人

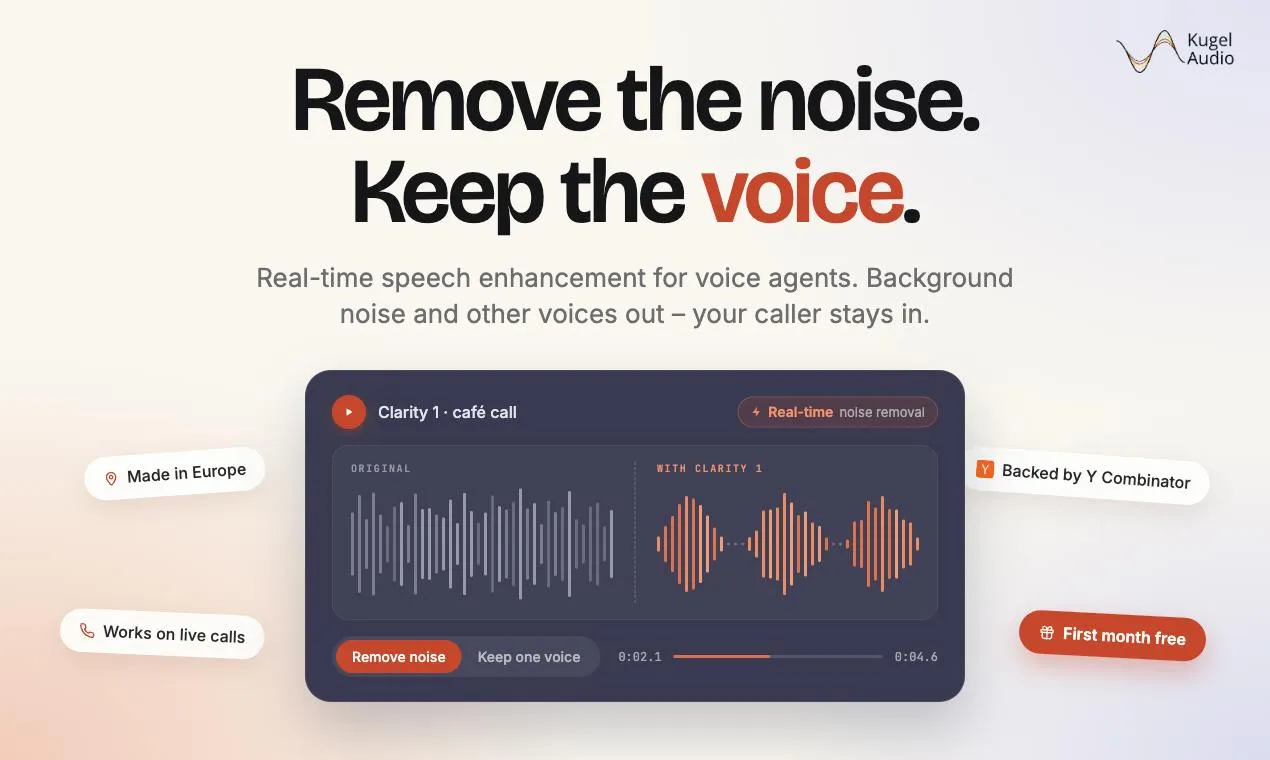
Clarity-1模型专为语音AI代理提供实时降噪与目标说话人提取,致力于净化输入音频以提升整个对话系统的准确率。
Clarity是一款面向语音AI代理开发者的前置音频处理工具,其核心模型Clarity-1能在实时流式处理中完成两项关键任务:去除背景噪音,以及在多人混音环境中精确提取目标说话人的声音。与传统降噪工具不同,目标说话人提取能把其他人的说话声也视为噪音滤除,直接解决了开放式办公、家庭等场景中语音代理"听不清"特定用户的痛点。该产品定位为模块化的基础设施组件,可接入现有语音管线,通过提升输入信号质量间接改善ASR和大模型的输出效果。目前产品刚上线,延迟、极端场景准确率和定价等关键信息尚未公开,有待实际部署验证。
当语音AI遇上嘈杂环境
语音AI代理(voice agent)正在客服、呼叫中心、语音助手等场景快速铺开,但一个长期存在的痛点制约着它们的实际表现:真实世界的声音从来不是干净的。背景噪音、旁边的人说话、环境回声,都会让语音识别和理解模型的准确率大打折扣。一个在实验室里表现优异的语音代理,放到真实通话里可能就变得"耳背"。
近期登陆 Product Hunt 的 Clarity 正是瞄准了这个问题。它的标语直白有力——"Mute the room, keep the speaker, in real time"(静音整个房间,只保留说话人,实时完成)。该产品由 Alexander Netz 打造,上线后获得 67 个投票,排在当日第 20 位,归类于人工智能、科技与音频领域。
Clarity-1 到底做了什么
Clarity 的核心是一个名为 Clarity-1 的模型,主打两项能力:实时语音增强(real-time speech enhancement)与目标说话人提取(target speaker extraction)。
前者负责剥离背景噪音,后者则更进一步——在一通存在多人声音的通话里,识别并只保留目标说话人的声音,把其他人的说话声一并过滤掉。对语音代理而言,这意味着模型接收到的是一条干净、聚焦于单一来源的音频流,从而显著降低误识别的概率。
按照官方描述,Clarity-1 "streams as audio arrives",即音频到达的同时就进行处理,而非等待整段录音结束再批处理。这种流式架构是语音代理场景的硬性要求:任何明显的延迟都会破坏对话的自然节奏。官网还提供了处理前后的音频对比(before/after),让用户直观感受降噪与人声提取的效果。
目标说话人提取为何关键
传统降噪方案大多只能处理稳态噪音(如风扇声、白噪音),面对"另一个人在说话"这种结构化的人声干扰往往束手无策——因为人声和目标说话人的频谱特征高度相似。目标说话人提取技术通过锁定特定声纹或声学特征,把非目标人声也当作噪音处理,这是比普通降噪更难、也更有价值的能力,尤其适合开放式办公、家庭等多人环境下的通话场景。
目标说话人提取(Target Speaker Extraction,TSE)在学术上通常依赖两种技术路径:一是说话人条件化分离,即在推理阶段先提供目标说话人的短暂参考音频(几秒即可),模型据此生成声纹嵌入(speaker embedding),再用该嵌入引导分离网络从混合信号中"抓取"对应的声音流;二是基于位置或麦克风阵列的空间分离,通过多路输入在空间维度区分说话人,但这依赖特定硬件。对于单麦克风的软件方案,前者更为常见,代表性开源工作包括 SpeakerBeam、TD-SpeakerBeam 等。Clarity-1 具体采用哪种路径目前官方未披露,但其宣称的"只保留目标说话人"暗示它需要在运行时获取某种说话人身份信息——无论是预先注册的声纹还是通话开始几秒的自动锁定,这套机制的稳健性直接决定产品在真实场景中的可靠程度。
面向语音代理的定位
Clarity 明确把自己定位为语音代理的前置处理层,而非面向普通消费者的通话降噪 App。这是一个值得玩味的产品选择。
随着 LLM 驱动的语音对话系统爆发,语音代理的"听"这一环节成了整条链路中容易被忽视却又决定成败的一环。再强的大模型,如果输入的转写文本错漏百出,输出质量也无从谈起。Clarity 把精力集中在音频预处理这个相对垂直但刚需的环节,通过提升输入信号质量来间接提升整个语音代理系统的表现。
对开发者来说,这类工具的吸引力在于它可以作为一个模块化组件接入现有的语音管线,无需自己从头训练降噪模型。流式处理、低延迟、针对人声干扰优化,这些都是面向生产环境的实用特性。
语音AI代理的典型信号处理链路(pipeline)通常由四个环节串联:音频采集→前处理(降噪/回声消除/说话人提取)→自动语音识别(ASR,如 Whisper、Deepgram)→大语言模型推理→文本转语音(TTS)输出。Clarity 瞄准的正是第二环节。这一环节长期依赖 WebRTC 内置的 AEC/ANS 模块或 RNNoise 等传统算法,面对复杂人声干扰时效果有限。将深度学习模型引入前处理层的好处在于:ASR 模型的词错误率(WER)对输入信噪比极为敏感,信噪比每提升 5 dB,WER 可能下降 20-40%,而前处理的改善会在整条链路上产生乘数效应。这也解释了为什么专注于这一单点的基础设施产品有独立存在的商业价值。
冷静看待:仍有待验证的部分
作为一个刚上线的产品,Clarity 目前公开的信息相对有限。几个关键问题尚未明确:实时处理引入的延迟具体是多少毫秒?在多人同时说话、声纹相近的极端情况下,目标说话人提取的准确率如何?定价与接入方式(API、SDK 还是本地部署)又是怎样?
67 个投票和 5 条评论的热度属于中等水平,说明它触及了一个真实需求,但距离被市场充分验证还有距离。对于考虑采用的团队,最稳妥的做法是先用自己真实场景的音频去官网试听 before/after 对比,再决定是否深入评估。
小结
Clarity 代表了语音AI工具链上一个正在成熟的细分方向:不做大而全的对话系统,而是把单一能力——干净地"听见"目标说话人——做到极致。在语音代理加速落地的当下,这种专注于输入信号质量的基础设施型产品,有可能成为许多团队容易忽视却离不开的一块拼图。它能否在准确率、延迟和成本之间找到最优平衡,还需要更多实际部署来检验。
相关推荐

通用AI模型直接操控机械臂,成功率远超专用策略
研究者提出智能体操作策略AMPs,让通用AI模型直接控制机械臂。AMP1框架在RoboLab-120零样本成功率达85.6%,远超VLA的49.2%和WAM的42.9%,真实世界108次试验成功104次,失败率降低20倍和15倍。

MLSys 2027审稿人尚未收到论文分配?社区讨论引关注
Reddit社区讨论MLSys 2027审稿人是否已收到论文分配。互惠审稿人反映尚未被分配论文,社区关注分配时间线及对评审工作的影响。

RTX 5060 Ti 16GB被抢购:AI热潮下的显卡新宠
Reddit社区热议RTX 5060 Ti 16GB显卡遭AI用户抢购,分析其显存优势、性价比及对市场的影响,探讨AI硬件需求新趋势。