ClashRoyaleAi:开源皇室战争RL模拟器与PPO智能体实践
个人开发者用C++17将《皇室战争》重建为确定性RL环境,结合PPO与前瞻搜索取得显著效果。
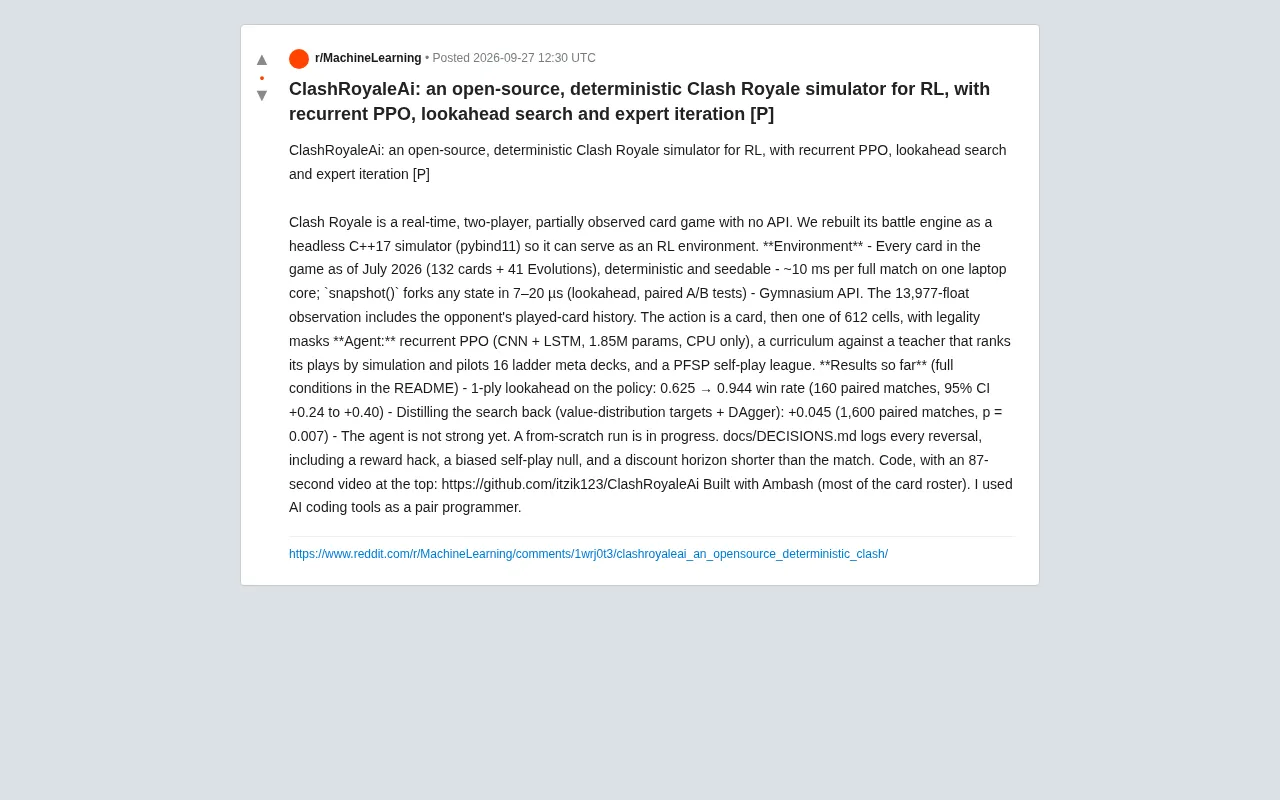
ClashRoyaleAi 项目由一位独立开发者开源,核心工作是用 C++17 将《皇室战争》战斗逻辑完整复刻为一个确定性、可设随机种子的无头模拟器,通过 pybind11 对接 Python 生态,并遵循 Gymnasium API 标准。环境覆盖游戏内 173 张卡牌,观测空间达 13,977 维,动作空间含合法性掩码设计。智能体采用递归 PPO(CNN+LSTM,约 185 万参数,仅需 CPU),结合课程学习与 PFSP 自博弈联赛进行训练。实验表明,在策略网络上叠加 1 步前瞻搜索可将胜率从 0.625 跃升至 0.944,搜索能力经 DAgger 蒸馏回网络后再获得统计显著的 +0.045 提升。项目还以 DECISIONS.md 详细记录了奖励作弊、有偏自博弈等训练中的踩坑经历,具有较高参考价值。
《皇室战争》(Clash Royale)是一款实时、双人、信息部分可见的卡牌对战游戏,且官方并未提供任何可供程序调用的 API。这一特性让它成为强化学习(RL)研究中一个极具挑战性的环境。近期一位开发者在 Reddit 上开源了 ClashRoyaleAi 项目——通过将游戏的战斗引擎用 C++17 重写为无头(headless)模拟器,把这款热门手游变成了可供 RL 训练的确定性实验平台。
从零重建一个确定性战斗引擎
项目最核心的工作,是把《皇室战争》的战斗逻辑从头复刻为一个可编程的模拟环境。开发者使用 C++17 编写底层引擎,并通过 pybind11 暴露给 Python 调用,从而兼容主流 RL 生态。
这套模拟器覆盖了截至 2026 年 7 月游戏内的全部卡牌——132 张普通卡与 41 张进化卡(Evolutions),并且保证了确定性与可设定随机种子。这两点对 RL 研究至关重要:确定性意味着相同输入必然产生相同结果,便于复现实验;可设定种子则让对照实验(A/B 测试)成为可能。
性能表现同样值得关注。在一台笔记本的单核上,跑完一整场对局仅需约 10 毫秒;而 snapshot() 接口能在 7–20 微秒内 fork 出任意游戏状态。这种极低成本的状态分叉能力,是实现前瞻搜索(lookahead)与成对 A/B 测试的技术基础。
Gymnasium 接口与观测空间设计
环境遵循 Gymnasium API 标准,这让它能无缝接入主流强化学习框架。其观测空间是一个 13,977 维的浮点向量,其中一个关键设计是纳入了对手已出牌的历史记录——这直接回应了游戏"信息部分可见"的特性,让智能体能够基于对手行为进行推断。
动作空间的设计也颇为精细:智能体需要先选择一张卡牌,再从 612 个格子中选择一个放置位置,并配有合法性掩码(legality masks)来约束非法操作。这种结构化的动作定义,既贴近真实游戏的操作逻辑,也降低了智能体探索无效动作的成本。
Gymnasium(前身为 OpenAI Gym)是强化学习领域的事实标准接口规范,定义了环境与智能体交互的统一契约:reset() 初始化环境并返回初始观测,step(action) 执行动作并返回新观测、奖励、终止标志等。遵循这一标准的最大红利是生态兼容性——Stable-Baselines3、RLlib、CleanRL 等主流训练框架可以开箱即用,无需为特定环境编写适配代码。合法性掩码(legality mask)是动作空间设计中的重要工程细节:它是一个与动作空间等长的布尔向量,在策略网络的 softmax 输出前将非法动作的 logit 置为负无穷,从而确保智能体永远不会"尝试"打出手牌中没有的卡或将单位放在河道里。这一机制大幅提升了样本效率,因为探索预算不会浪费在必然无效的操作上。
智能体架构:从 PPO 到自博弈联赛
在智能体层面,项目采用了递归 PPO(recurrent PPO)方案,网络结构为 CNN + LSTM,参数量约 185 万,且仅在 CPU 上运行。相比动辄需要大规模 GPU 集群的方案,这样的轻量级设计更适合个人研究者复现。
训练策略上,开发者构建了多层次的学习路径:
- 课程学习(curriculum):设置一个"教师"对手,它通过模拟对候选出牌打分,并驾驭 16 套天梯主流卡组(ladder meta decks),逐步引导智能体成长;
- PFSP 自博弈联赛:采用优先虚拟自博弈(Prioritized Fictitious Self-Play)机制组织智能体之间的对抗,避免自博弈退化为无效对局。
PPO(Proximal Policy Optimization,近端策略优化)是目前最广泛使用的 on-policy 强化学习算法,其核心思想是通过裁剪(clip)策略更新幅度来避免单次更新步幅过大导致训练崩溃,在样本效率与实现简洁性之间取得了良好平衡。递归 PPO 在标准 PPO 基础上引入 LSTM 层,使智能体能够维护跨时间步的隐状态,这对《皇室战争》尤为必要——游戏中对手的手牌和意图属于隐藏信息,需要从历史序列中推断。PFSP(Prioritized Fictitious Self-Play,优先虚拟自博弈)源自 DeepMind 的星际争霸研究,其关键改进在于"优先"二字:并非随机选择历史对手版本进行对弈,而是优先与当前版本胜率接近 50% 的历史版本对抗,避免智能体反复击败已被完全掌握的弱旧版本,从而持续获得有效的学习信号。
实验结果与前瞻搜索的价值
项目公布的初步结果,凸显了搜索对策略提升的显著作用。在策略网络上叠加 1 层前瞻搜索(1-ply lookahead)后,胜率从 0.625 跃升至 0.944(160 场成对对局,95% 置信区间为 +0.24 到 +0.40)。这一提升幅度相当可观,印证了"搜索 + 学习"这一组合在博弈类任务中的经典价值。
更进一步,开发者尝试将搜索的收益"蒸馏"回策略网络本身——通过值分布目标(value-distribution targets)结合 DAgger 方法,最终带来了 +0.045 的胜率提升(1,600 场成对对局,p = 0.007)。虽然增幅不大,但统计上显著,说明搜索能力可以部分内化到网络中。
开发者也坦诚地指出:当前智能体尚不算强,一次从零开始的完整训练仍在进行中。
1-ply 前瞻搜索(1-ply lookahead)指在当前状态下枚举所有合法动作,用模拟器向前展开一步,以值函数评估各后继状态,再选择评估值最高的动作执行——本质上是将策略网络升级为"策略网络指导的单步 minimax"。其戏剧性的胜率提升(0.625→0.944)说明当前策略网络的动作选择存在大量"一步可修正"的失误,也暗示值函数的估计质量已足够可靠。DAgger(Dataset Aggregation)是一种模仿学习算法:让专家策略(此处为"搜索增强版策略")在学生策略访问到的真实状态分布上提供标注,而非仅在专家自身的轨迹上训练,从而缓解行为克隆中的分布偏移问题。将搜索结果通过 DAgger 蒸馏回网络,本质上是让网络学会"内化"一步推理,使推理时无需显式搜索也能获得部分收益。
透明的工程决策记录
这个项目一个难得的亮点,是它对研发过程中"踩坑"的完整记录。docs/DECISIONS.md 文档记载了每一次方向逆转,包括:
- 一次奖励作弊(reward hack)——智能体钻了奖励函数的空子;
- 一个有偏的自博弈零假设(biased self-play null);
- 一个比整场对局时长更短的折扣视界(discount horizon)问题。
这类"失败日志"对 RL 从业者的参考价值,往往不亚于成功结果本身。它揭示了在真实环境中训练智能体时那些微妙却致命的陷阱。
项目代码已在 GitHub 开源(github.com/itzik123/ClashRoyaleAi),仓库顶部还附有一段 87 秒的演示视频。开发者提到,大部分卡牌逻辑借助 Ambash 构建,整个过程也将 AI 编程工具作为结对编程助手使用——这本身就是当下个人开发者借助 AI 完成复杂项目的一个真实缩影。
小结
ClashRoyaleAi 展示了个人研究者如何将一款没有官方 API 的商业游戏,改造为严肃的强化学习实验平台。从确定性引擎、结构化观测与动作空间,到递归 PPO、前瞻搜索与自博弈联赛的组合,再到透明的工程决策记录,这个项目为想要在复杂博弈环境中实践 RL 的开发者提供了一份颇具参考价值的开源样本。
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
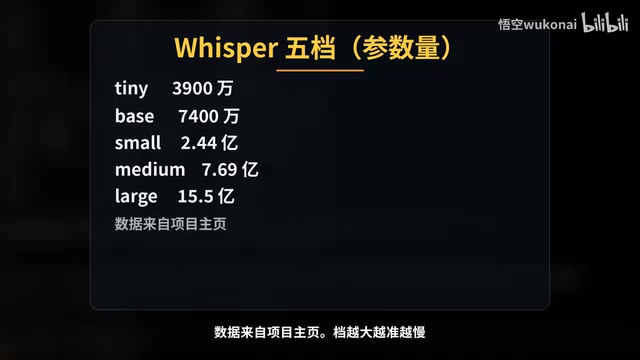
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
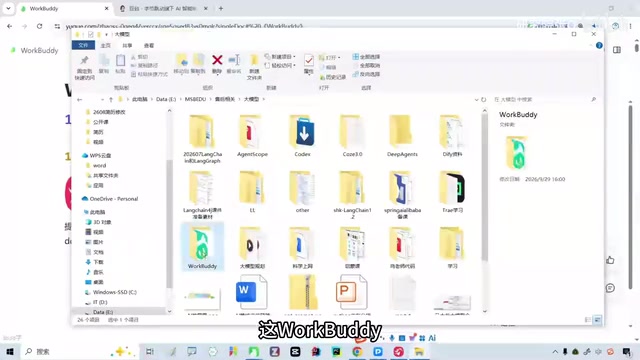
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
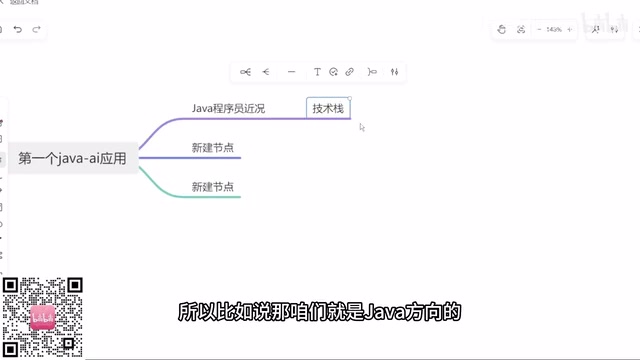
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。