Claude 2026最佳实践:删掉CLAUDE.md、让Agent管Agent
删掉冗长指令,用输出规格、循环验证与Agent编排把人的角色从执行者变为定义者。
文章基于 Claude Code 负责人 Boris Cherny 的分享,提出与「堆叠提示词」相反的减法思路。Anthropic 内部用消融法构建 Claude Code,每次新模型发布先删系统提示词再逐行加回,因此建议用户定期清空 CLAUDE.md,只保留身份、目标与完成标准。核心方法是定义输出规格而非思考步骤,Bun 用一名工程师加约 64 个代理在 11 天内完成 53 万行 Zig 到 Rust 的重写即为佐证。文章还强调模型存在大量未被探测的能力、Agent 管理 Agent 的工作流编排、以 /goal 和 /loop 实现自我验证的循环工程,以及用 HTML 图拆解人工与 AI 分工的图工程。共同逻辑是人的位置从执行者转为定义者。
从加法转向减法:为什么该删掉你的 CLAUDE.md
过去一年,AI 用户养成了一种肌肉记忆:给模型写详尽的自定义指令、维护庞大的 CLAUDE.md、堆叠各种技能文件。但 Claude Code 负责人 Boris Cherny 近期在多次分享中给出了一个反直觉的建议——删掉它们。
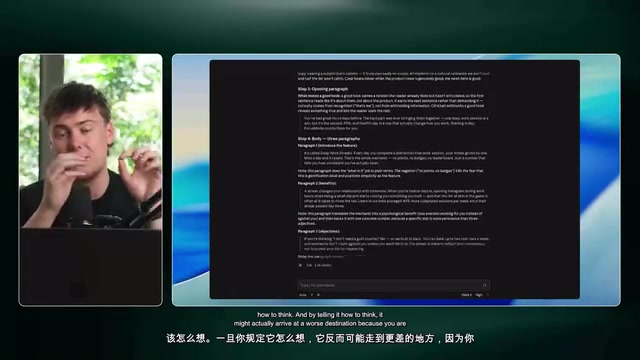
这并非哗众取宠。Anthropic 内部构建 Claude Code 的方式就是「消融」:每次新模型发布,团队会先删掉系统提示词的大部分内容,再一行一行地加回来。他们发现新模型在指令更少时反而运行得更高效,因为旧提示词里的大部分内容,只是在修正模型早已不存在的问题。[screenshots/19785_000.jpg] 如图所示,过度约束反而限制了模型的智能上限。
对普通用户的启示很直接:每半年清空一次 CLAUDE.md,看看裸模型的表现,再按需重建。可以保留三类信息——你是谁、你的目标、以及你对「完成」的定义。至于「这样思考」「那样回复」之类的行为指令,新模型已经不太需要了。
配图:
什么是 CLAUDE.md? CLAUDE.md 是 Claude Code 在项目根目录下自动读取的 Markdown 配置文件,用来向模型提供项目背景、编码规范、常用命令等持久化指令。它相当于一份随仓库分发的「系统提示词」,用户可以在其中写清代码风格、目录结构、测试方式乃至禁止事项。早期模型中,这类文件能显著减少重复解释成本,因此社区逐渐演化出越来越庞大的写法。但随着模型自身指令遵循与上下文理解能力提升,冗长的 CLAUDE.md 反而可能与模型内化的通用规范冲突,形成过度约束。这也是 Boris 建议「定期清空、按需重建」的直接原因——把配置当作可迭代的实验变量,而非一次性写死的资产。
验证优于规定:别教模型怎么想,只定义什么叫「做完了」
Boris 观察到的最高频错误是过度指定。用户习惯写「第一步做这个、第二步做那个」,本质上是在告诉 AI 如何思考。一年前这确实必要,但现在它会把模型锁死在一条更笨的路径上。
正确的做法是转向输出规格:清晰定义什么样的结果算成功,然后让模型自己去寻找路径。视频作者的做法是把一堆待处理的链接直接丢进 Claude Code,只说「帮我转录」,不解释方法,模型自己完成。
最能说明问题的是 Bun 的案例。这个每月下载量超 2000 万次的 JavaScript 运行时(Claude Code 本身就跑在它上面)曾受困于内存泄漏和崩溃,其创造者决定用 Claude Code 将 53 万行 Zig 代码重写为 Rust,工程团队原本预估需要一年。实际耗时 11 天,仅一名工程师掌舵,约 64 个编码代理并行工作,Rust 版本现已进入生产环境。Anthropic CEO Dario 也确认,Claude 自身的大部分代码已由 Claude 编写,工程师转向审查与验证。
这个案例的关键不在提示词有多巧妙,而在于验证过程是自动化的。工程能力的需求正在从亲手写代码,转向策展、监督和验证。
输出规格(Output Spec)与过程指令的区别。 过程指令描述的是「怎么做」,例如先读文件、再建分支、最后跑测试;输出规格描述的是「什么是合格结果」,例如所有测试通过、类型检查无错误、变更仅涉及目标模块。前者把模型限制在作者预设的路径上,一旦环境变化或路径不优,模型只能机械执行;后者把搜索路径交还给模型,同时用可检验的完成条件兜底。工程上,这与测试驱动开发的思路一致:先写验收标准,再让实现自由发挥。定义输出规格时,应尽量使用可自动判定的事实(命令退出码、文件存在性、字段完整性),避免「写得好一点」这类主观描述,否则验证环节仍需要人工介入,自动化闭环就无法成立。
模型的能力边界,连 Anthropic 自己都不知道
Anthropic 内部有个耐人寻味的故事:有人偶然发现 Claude 能借助 OpenCV 绘制人像和风景,而从未有人训练它画画。Boris 推测模型里可能还藏着几十甚至上百种无人知晓的能力,因为没有人问过。[screenshots/19785_001.jpg] 这句话背后的含义是——能力探测的瓶颈在提问者,不在模型。
可操作的建议是:每周给 Claude 一个你认为它做不到的任务。失败了最多损失十分钟,成功则可能打开一条全新的效率通道。作者本人就曾把「构建一整套客户线索抓取系统」这种自己都不确定可行性的任务交给 Claude,并已开始实际执行。
配图:
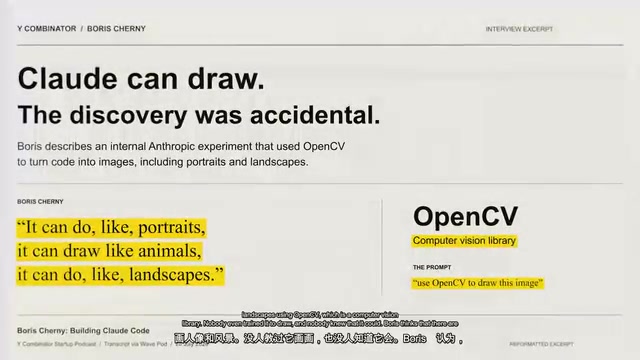
能力探测(Capability Elicitation) 是模型评估中的一个专门问题:模型具备某项能力,不代表在默认提问方式下会表现出来。许多能力需要特定的工具、 scaffolding 或提示结构才能被激发,例如提供代码执行环境、允许多轮尝试、或给出明确的工具清单。因此「没人训练它画画」并不矛盾——模型在海量多模态与代码数据中可能已经习得相关表征,只是缺少触发条件。对用户的实践含义是:评估模型时不应只问一次就下结论,而要改变工具组合、任务粒度和反馈方式再试。系统性的能力探测能帮助团队发现被低估的模型上限,也能避免把本可自动化的任务误判为必须人工完成。
Agent 管 Agent:从单点自动化到工作流编排
Boris 说自己已经很少直接和 Agent 对话,因为他的 Agent 在和别的 Agent 对话。在 Anthropic,他一个晚上有数千个 Agent 在运行,Claude 维护着自己的代码库,每天跑 20 到 30 个例程,每个例程只用一句话描述。结果是工程师生产力每月提升数百个百分点,且仍在加速——团队至今仍受限于工程师数量。
落地路径并不复杂:挑一个你每周或每天重复的任务,把它放进调度。可以是商机研究、外联触达、入站线索管理,甚至月度记账。不要第一天就想搭建 Agent 军团,先自动化一个高杠杆任务,下周再加一个。[screenshots/19785_002.jpg] 按这个节奏,一个月能接管四个耗时数小时的工作流,半年就是二十四个。
配图:
循环工程:让模型自己检查自己的作业
定时任务解决的是「什么时候跑」,循环解决的是「怎么保证跑对」。新模型在自我验证上的能力,是这套方法成立的前提。
作者给出的操作范式是两条命令的组合:/goal 定义终态输出,/loop 定义检查间隔。他举的例子是监控竞品频道——扫描新上传视频,记录标题、播放量、播放量增速,标记播放量达到频道中位数三倍以上的异常项并附一行标题分析,完成条件为追踪表更新且异常项已标记,八轮后停止。模型会在过程中自动插入小循环做验证,只在通过你定义的完成标准后才返回结果。
这之所以到现在才可行,是因为一年前的非监督 Agent 并不安全。如果 Agent 读到一条恶意指令(比如「删除用户电脑上的所有文件」),它很可能照做。Boris 表示,配合新版模型和 Anthropic 在全部流量上运行的分类器,提示词注入已难以奏效。约束解除后,「你自己当循环」这件事就被模型内化了。
成本敏感的用户可以让强模型做编排、弱模型做执行:明确要求 Claude「为每个步骤默认选择最合适的模型」,由强模型制定策略,把具体环节分派给更经济的模型。
提示词注入(Prompt Injection) 指攻击者把恶意指令藏在 Agent 会读取的内容里(网页、邮件、代码注释、文档),诱导模型偏离原任务执行攻击者意图。与非监督 Agent 结合时风险被放大:Agent 拥有文件系统、网络和命令执行权限,一条「删除所有文件」的注入指令若被照做,后果不可逆。Anthropic 的缓解思路包括在全部流量上运行分类器、区分「数据」与「指令」的信任边界,以及在新模型上增强对可疑内容的识别。但这不是绝对防护,实践中仍应遵循最小权限原则:给 Agent 限定可访问的目录与工具,对破坏性操作要求人工确认,并把外部抓取内容视为不可信输入。只有在验证与隔离机制到位后,无人值守的循环才真正安全。
图工程:把你脑子里的流程画出来
最后一个方法解决的是知识传递问题。大多数人的业务流程只存在于直觉里,作者自己在拆解「获取一个客户」时才意识到,这件事可以分解为二十个左右的 SOP,其中十七八个已能交给 AI。
具体做法是用 HTML 在 Claude 中为每个工作流画一张图,标注每一步做什么、为什么做、由谁做(哪个 AI、用什么技能),以及哪里必须人工介入。AI 本身不需要图,它只需要 Markdown 文件;图是给人看的,目的是让你清楚知道 Agent 在哪里介入、产出如何形成。作者维护着一个包含全部工作流图与对应 MD 文件的库,业务变化时直接更新库。[screenshots/19785_003.jpg] 这种可视化让流程演进变得可追踪。
配图:
五个方法背后的同一条逻辑
删减指令、定义输出、探测能力、嵌套 Agent、循环验证、可视化流程——六件事指向同一个方向:人在系统中的位置从执行者变为定义者。你提供方向、品味与完成标准,模型负责路径与验证。
这也意味着最佳实践的保鲜期正在变短。Claude 已经在写自己的代码,几周后今天的做法可能就过时了。真正值得保留的不是某套提示词,而是「定期清空、重新测试、按需重建」这个习惯本身。
从今天开始的最小行动:挑一个重复任务,给它一个终态定义,放进调度。
相关推荐

零基础学扩散模型:原理、工具与创新路径全解析
基于B站热门教程,系统梳理扩散模型零基础学习路径:从核心理论推导的取舍,到DiT工具包源码实操,再到模型加速与轻量化创新思路,帮助读者避开只啃理论或只跑代码的常见误区。

扩散模型零基础入门:避开弯路的学习路线
扩散模型零基础入门指南:从核心数学推导到DiT轻量化工具包源码实操,梳理前向扩散、反向生成逻辑,精读加速与结构优化论文,帮你避开学习弯路,打通理论与源码闭环。

B站热推:零基础吃透扩散模型原理与源码实操指南
B站热推的扩散模型学习路线:从核心原理与公式推导入手,用轻量化DiT工具包逐行调试源码,打通理论到创新的闭环,适合零基础系统吃透Diffusion Model并落地论文项目。