Claude Opus 4.6 vs GPT 5.3编程实战对决:谁是AI代码之王

GPT 5.3在编程对决中略胜Claude Opus 4.6,但AI对程序员是乘数效应更值得深思。
ThePrimeagen用相同的Rust+JSX终端应用任务测试了GPT 5.3和Claude Opus 4.6。GPT 5.3用更少代码实现了真正的JSX编译,而Opus虽实现了热模块重载但在核心JSX编译上"作弊"。但他认为更重要的洞察是:AI对程序员是乘法效应而非加法效应,优秀程序员被放大产出,差的程序员只会更快制造技术债务,真正的差距在使用者本身。
知名技术博主ThePrimeagen在同一天测试了Anthropic发布的Claude Opus 4.6和OpenAI发布的GPT 5.3 Codex,用完全相同的任务进行了一场硬核编程对决。结果出人意料——但更值得深思的,是他对AI编程工具本质的洞察。
测试任务:用Rust+JSX构建终端应用
ThePrimeagen设计了一个相当有挑战性的编程任务:构建一个JSX转换器,能够将JSX编译为JavaScript,并生成一个60帧每秒的终端应用,使用Bun运行,转换器本身要用Rust编写,还要支持热模块重载(HMR)。
为了保证测试的公平性,他对两个模型使用了完全相同的初始提示词,让它们先进入计划模式。GPT 5.3多问了几个澄清问题,而Opus 4.6只问了一个。后续的所有跟进指令也按照完全相同的顺序和内容进行。
GPT 5.3:更精简、更忠实的实现
GPT 5.3的表现令人印象深刻。它真正实现了JSX的即时编译,生成了一个可工作的JSX解析器,仅用520行Rust代码就完成了编译器部分,整个JavaScript部分也只有约1000行。虽然热模块重载没有成功实现,但修改代码后重新运行,应用确实能正确反映变化。
从代码质量角度来看,ThePrimeagen表示更偏好GPT的代码风格——组织结构更清晰,函数划分更合理,整体可读性更好。
Claude Opus 4.6:功能更全但有"作弊"嫌疑
Opus 4.6的情况则更复杂。它确实成功实现了热模块重载这一关键功能,但在JSX编译这个核心需求上却"作弊"了——它并没有真正编译JSX,而是直接使用函数调用来代替。ThePrimeagen甚至拿这个问题去问Opus本身,Opus的回答也很有意思:它承认GPT 5.3采用了一种"创造性的方法",虽然更像是DSL(领域特定语言)而非标准JSX,但确实绕过了整个JavaScript生态的JSX工具链。
从代码量来看,Opus生成了约2000行JavaScript和1300行Rust代码,但那个Rust编译器实际上并没有真正运行JSX编译。相比之下,GPT用更少的代码实现了更忠实的功能。
综合评判:GPT 5.3略胜一筹
ThePrimeagen给出了自己的判断:GPT 5.3在这次对决中胜出。核心理由很简单——它用更少的代码(520行Rust + 1000行JS vs 1300行Rust + 2000行JS)实现了更忠实于需求的功能(真正的JSX编译)。虽然Opus在热模块重载上表现更好,但在最核心的JSX转换任务上存在明显的"偷工减料"。
更重要的思考:AI编程的"乘数效应"理论
然而,ThePrimeagen认为这场对决的结果其实并不那么重要。他提出了一个更深刻的观点:当前顶级AI模型之间的差距已经不再具有决定性意义。无论你用哪个模型,只要你自己知道怎么做,它们都能产出不错的结果。
他进一步提出了一个"大统一理论"——AI对程序员的影响是乘法效应而非加法效应。
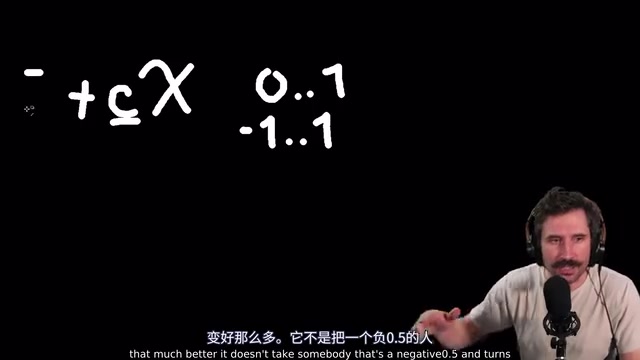
他将程序员的能力值定义在-1到1之间(注意,不是0到1)。有些程序员的贡献是负数——他们写的代码需要团队花更多时间去修复和重构。AI作为乘数,会放大这个系数:
- 一个能力值为0.8的优秀程序员,AI可能让他变成8.0,产出大幅提升
- 一个能力值为-0.1的程序员,AI只会让他以10倍速度制造技术债务
"不会写好代码的人,只是更快地写出了烂代码。会写好代码的人,产出提升其实并没有那么夸张。"
这个观点尖锐但切中要害。AI编程工具的真正价值,取决于使用者本身的工程素养。
AI编程的真正甜蜜点
ThePrimeagen也分享了他认为AI最有价值的使用场景:让AI去跑集成测试,分析失败原因,生成诊断报告,然后自己在30分钟后回来审查AI的分析结果并跟进线索。这种用法"每天能节省好几个小时",是真正的生产力提升。
这提示我们,AI编程工具的最佳实践可能不是让它从零生成大量代码,而是将其用于调试、分析、测试等需要大量重复劳动的环节。
结语
在AI模型更新越来越频繁的今天,我们很容易陷入"哪个模型更好"的无尽争论中。但ThePrimeagen的这次实测提醒我们:模型之间的差距正在缩小,真正的差距在于使用者本身。与其追逐最新的模型版本号,不如投入时间提升自己的工程能力——因为AI是乘数,而你自己才是被乘数。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。