Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code Token消耗的真正元凶是反复重发的历史记录,而非你的输入内容,七个方法可系统性降低额度消耗。
本文拆解了Claude Code用户频繁触达使用限制的底层原因:模型无持久记忆,每轮对话都需重发完整历史,导致Token呈复合增长,实际输入仅占账单约0.01%。文章按节省效果由高到低梳理了七项修复方法:零成本的`/clear`命令可重置整个上下文基础;会话中途切换模型会破坏缓存使成本翻十倍;为工具输出加过滤器可将数万Token压缩至数百;断开闲置MCP工具可消除隐性加载成本;子代理仅在长会话高容量场景才划算;定时任务若频率过低则每次触发都错过缓存。此外,文章纠正了「写短提示」「用压缩省Token」「截图代替文本」等广泛流传但实际无效甚至反效果的建议。
很多 Claude Code 重度用户都遇到过同样的挫败:明明没有让它连续运行 8 小时,也没做什么大工程,却总是提前撞上使用限制,被系统告知「5 小时后再来」。一位 B 站 UP 主分享的排查经验揭示了一个反直觉的事实——真正吃掉你 Token 额度的,几乎不是你输入的提示词,而是那些看不见的重复消耗。
本文基于该 UP 主的实测拆解,梳理出 Token 消耗的底层机制,并按「实际节省额度」从高到低排列出七个修复方法:从零成本的操作,到那些你为了省钱反而让账单翻倍的陷阱。
为什么 Token 会「复合增长」
理解 Token 消耗,关键在于一个事实:这些模型没有记忆,完全没有。每次你按下回车,整个对话都会被重新打包,从头发送一遍。
第一条消息只花费你输入的内容;第二条消息花费你输入的内容加上模型的回答,再加上第一条消息;到第二十条消息时,你刚写的那点内容只是顶部的一个小框,下面的所有历史都是你已经付过费、现在又要再付一次的部分。这就是 Token 复合增长的根源。
据 UP 主的日志显示,他实际输入的内容只占账单的约 0.01%,96% 的花费都来自他所称的「中毒历史」(poisoned history)——那些被反复重发的旧对话。一个在第 40 轮会话里读取的代理,光是重发历史就可能把 3000 Token 的开销放大几十倍。
由于每个人的配置不同,UP 主提供了一段可直接粘贴进 Claude Code 的审计提示词,它会读取你的实际配置、分解上下文构成、检查工具延迟、测量记忆文件、查看缓存命中率,并标记那些在你睡觉时触发的定时任务。跑一遍就能知道到底是什么在吞噬你的额度。
这种机制在技术上被称为「上下文窗口」(Context Window)。大语言模型每次推理时,接收的是一个固定长度的文本序列——即上下文窗口——而非像人类一样拥有持久记忆。Claude 3.5 系列的上下文窗口上限约为 20 万 Token(约 15 万单词),Opus 则更大。当对话长度逼近这个上限时,系统会自动裁剪最旧的内容,但在此之前,每一轮交互的计费基础都是「系统提示 + 全部历史对话 + 当前输入」的总和。Token 是模型处理文本的基本单位,大致对应英文中 3/4 个单词或中文的 1-2 个汉字。Anthropic 的定价区分「输入 Token」和「输出 Token」,输入通常更便宜,但在长会话中,历史记录的反复重发使输入量急剧膨胀,远超任何单次回复的输出量,这正是「复合增长」效应的数学根源。
修复一:任务之间用 /clear(零成本,杠杆最高)
削减成本最高杠杆的操作是免费的,只有五个字母:/clear。
当你完成一个任务开始下一个时,不要图方便就在同一个会话里继续。旧对话不会安静地待着,它会在你发送的每条消息里被重新发送,直到额度耗尽。UP 主演示中,一个会话的消息量高达 8 万 Token,输入 /clear 回车后瞬间归零。
Anthropic 的文档也明确指出,当你想要重新开始而不是延续时,/clear 不花任何成本。这也是它胜过其他所有方法的原因——其他修复只减少上下文的某一个组成部分,而清除会重置所有组成部分所依赖的整个基础。
一个实用技巧:在清除前先用 /rename 给会话命名,之后可以用 /resume 恢复,紧急时不至于丢失工作。你不是在扔掉成果,只是阻止下一个任务继续携带它。
修复二:会话开始就选定模型,之后别动它
这一条与省钱直觉正好相反。很多人会在会话中途从 Opus 降到 Sonnet,觉得这样能省钱——而这恰恰是你能做的最昂贵的操作。
原理在于缓存。你的对话被缓存后,缓存读取成本只有正常输出的十分之一,这正是长会话不至于让你破产的原因。但模型是缓存键(cache key)的一部分,一旦切换模型,历史就不再匹配缓存,整个对话会以全价重新处理。在 Opus 上,20 万 Token 的上下文会让原本十分之一价格的回合变成全价,贵十倍,而且这一切完全看不见。
会破坏缓存的操作包括:切换模型、改变努力(effort)级别、开启快速模式、连接或断开 MCP 服务器、启用带 MCP 的插件、以及压缩(compact)。此外升级 Claude Code 后恢复长会话,被 Anthropic 文档直接称为「你会发送的最昂贵的请求」。
相对安全、不会重建缓存的操作有:编辑仓库文件、编辑记忆文件、改变输出风格、调整权限、调整技能和命令、回退(rewind)以及生成子代理。规则很简单:会话开始时就选好模型和努力级别,然后别动。想用便宜模型,就从一开始用。
Anthropic 为 Claude API 引入了「提示缓存」(Prompt Caching)机制,允许服务端将反复出现的上下文前缀存储在高速缓存中。当后续请求的前缀与缓存命中时,读取成本仅为标准输入价格的 10%(即九折优惠)。缓存的键(cache key)由模型版本、系统提示、工具定义和对话历史共同构成——任何一个维度变化都会导致缓存失效(cache miss),触发全量重新处理。缓存条目的有效期约为 5 分钟(默认)至 1 小时(可延长),超时后同样视为未命中。这解释了为何「中途换模型」和「低频定时任务」这两类看似无害的操作,实际上是悄无声息的成本放大器——前者主动销毁缓存,后者被动等待缓存过期。
修复三:给工具输出加过滤器
接下来三个修复针对的是你从没输入过、却在消耗上下文的东西。
设想你让代理安装一个库,它运行命令后返回 800 行日志——版本号、警告、进度信息,你一行都不会看,只想知道它成功了。但代理不能略读,这 800 行全部进入了对话,此后每条消息都要为它们付费,直到你清除。
解决办法是在代理和命令之间加一个小的过滤文件,在代理看到之前就削减输出。Anthropic 官方提供了一个可用版本,能把上下文从数万 Token 减少到数百。这个设置只需做一次,之后每个会话都有效。
修复四:断开不用的 MCP 工具
下一个修复关于「在你输入任何内容前就已经存在于上下文里」的东西。
你连接 Gmail、Notion、Slack,每个只需一条命令,感觉是免费的,但并非如此。每个工具都附带一本「说明书」,代理在使用前必须先阅读。据 UP 主数据,GitHub 本身就要花 2.6 万 Token,Slack 是 2.1 万 Token,这些都会在你说第一个字之前加载进每个会话。
好消息是 Claude 已发布更新,默认让代理不再阅读每一本完整说明书,而是加载「目录页」,只在需要时展开实际用到的部分,成本下降约 85%。这部分默认开启,无需操作。但你仍在为目录页付费,且每连接一个新工具目录页就增长。
修复方法约需 30 秒:打开工具面板,关掉最近一个月没用过的任何东西。在会话中关闭工具不花钱——只要那行显示「延迟」(latency),连接和断开只是追加操作,不会像切换模型那样重建缓存。
修复五:子代理是「移动」Token,而非节省
关于子代理有个半真半假的说法:都说它能省 Token,其实它只是转移 Token。
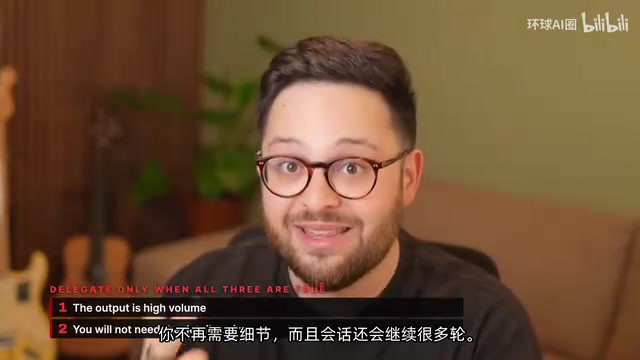
以 Anthropic 自己文档中的数字为例:一个研究型子代理读取了约 6000 Token 的文件,返回主上下文的只是一个 420 Token 的摘要,在主窗口里看起来是巨大胜利。但整体算账,那个子代理还加载了自己的系统提示、记忆文件副本和工具,总共烧掉约 9800 Token,为你节省了 5700。单独看,你其实是亏的。Anthropic 也直言,代理消耗的 Token 约为聊天的 4 倍,多代理系统约为 15 倍。
子代理真正值得用,需要同时满足三个条件:输出高容量、你不再需要细节、且会话还会继续很多轮。第三点是关键——你省下的那 5700 Token 会在剩余每一轮里被重新发送才能回本。如果委派后立即结束会话,你只是白白多付钱。
一个免费升级:把子代理的模型设为 Haiku,能在隔离工作上减少约 5 倍消耗,且不影响主会话的缓存。同理,重命名文件、写提交消息、清理列表这类小任务,用「能完成工作的最笨模型」是好的启发式,但要通过技能和子代理来切换,而不是在主会话里换模型。
Claude Code 中的子代理基于 Anthropic 的多智能体框架实现:主代理(Orchestrator)通过工具调用派生出独立的子代理(Subagent),每个子代理拥有自己独立的上下文窗口,与主会话完全隔离。子代理完成任务后,仅将结果摘要返回主上下文,而非原始数据。这种架构的本意是突破单一上下文窗口的长度限制,处理超长文档或并行任务,而非降低总 Token 消耗。Haiku 是 Anthropic 的轻量级模型,定价约为 Opus 的 1/30 至 1/50,适合执行明确、输出简短的子任务(如文件重命名、格式转换)。将子代理指向 Haiku 而非 Opus,可在不影响主会话缓存的前提下大幅压缩子任务成本,但前提是该子任务不需要复杂推理能力。
修复六:检查凌晨三点的定时任务
前面每个修复都假设你坐在键盘前,这一个是关于你不在时发生的事——也是开头承诺的那个「陷阱」。
定时任务按间隔触发,无论你在不在,且它发送的是整个上下文而非一部分。如果任务连接到一个臃肿的会话,每次触发都要为整个上下文付费,永远如此。
更痛的是缓存会过期。如果任务运行频率低于每小时一次,每次触发都会错过缓存,以全价重新处理整个上下文,而不是十分之一的缓存价,成本翻十倍。因此任务频率是一个真实的成本设置:如果能每 45 分钟跑一次而不是每小时或每两小时,反而更便宜。
这里也要纠正一个流行误解:有人说后台开着 Claude Code 会烧限额。Anthropic 文档显示后台使用每次会话不到 4 美分,那不是问题所在。真正让账单在你不碰键盘时翻倍的,是那些连接到臃肿会话、持续消耗直到退出的定时任务。
那些「不起作用」的省钱建议
UP 主特别澄清了几条被广泛传播但其实错误的建议:
写更短的提示:无效。实际输入内容只占账单极小比例,提示长度是四舍五入级别的误差。模糊的提示确实费钱,但那是通过触发文件读取和返工,而不是长度本身。
用压缩(compact)省 Token:反了。为了生成摘要,模型必须再发送一遍整个对话,然后故意清除缓存。压缩买的是「连续性」而非「节省」。如果只想撤销几个糟糕回合,用 /rewind 回退到缓存已知点,无需重新读取。
截图代替文本:图片并不比其中文字便宜。在 Opus 上一张普通截图约 2700 Token,4K 接近 5000。改为粘贴纯文本更便宜,而且代理能实际编辑文本,编辑不了图片。
直接喂 PDF:PDF 每页仅文字就要 1500~3000 Token,代理还会给该页拍照片,等于每页付两次费。先让代理转成纯文本,同样文档大约只花四分之一成本。
「压缩」(Compact)是 Claude Code 提供的一项内置功能,其底层操作是让模型对当前完整对话生成一段滚动摘要,再用该摘要替换原始历史,从而在不清空会话的前提下腾出上下文空间。代价是:生成摘要本身需要完整发送一次旧历史(一次全价输入),且摘要内容是模型的主观提炼,可能丢失细节,还会主动使缓存失效。相比之下,/rewind 命令允许用户回退到指定的历史节点,删除该节点之后的所有内容,且不会触发缓存重建——因为被保留的历史与缓存中的版本完全一致。因此在「后悔几个回合」的场景下,/rewind 在成本和信息完整性上均优于 Compact;Compact 更适合「对话已极度冗长、必须继续但无法清除」的特定情形。
四个你该常看的自查命令
要让这些优化持久有效,UP 主推荐四样工具,其中三个已在你的终端里:
/context:逐行显示当前窗口里有什么,占用了多少空间,用得最多。/usage:显示你烧掉了多少计划额度,以及具体是哪个技能、工具、代理烧的。/cost:显示当前会话花了多少,其中多少是「中毒历史」,多少是新工作。- 屏幕角落的消耗率表:工作时那个跳动的数字,比任何规则更能改变你的行为习惯。
此外,你运行过的每个会话都记录在一个文件夹里,每个回复都记录了成本。让子代理去读这些日志,就能算出属于你自己的消耗百分比,而不是照搬别人的数字。
结语:这是你自己的桌面
核心结论其实很朴素:你撞上限额,几乎不是因为要求太多,而是因为你付费的绝大部分都是已经发送过的历史,而没人告诉你开关在哪。
任务之间清除,因为它免费且重置基础;模型和努力级别选一次就别动;在工具输出落地前过滤它;断开不用的工具;会话还长时才委派子代理;去看看你的定时任务凌晨三点在干什么。UP 主坦言,各家实验室不会主动帮你修这个问题——不是因为难,而是因为他们并不按你用了多少 Token 来给自己评分。这是你自己的桌面,得自己保持干净。建议每周运行一次审计提示词,或每当感觉烧得多时就跑一遍,因为配置会随着你添加服务器、安装插件、修改设置而慢慢漂移。
相关推荐
AI Agent 一周赚1万美金:3个关键升级揭秘
海外博主分享用 AI Agent 一周赚 1 万美元的方法:不是加更多技能,而是通过验证机制、审批闸门和子智能体三大升级提高信任线,让 Agent 真正实现自动化。附 30 秒技能成本自检法。
OpenClaw入门:多渠道AI代理网关与自动化工作流详解
OpenClaw是一个开源的多渠道AI代理网关与编排平台,本文详解其网关、代理、渠道三大核心组件,以及工具集成与记忆机制,帮助开发者构建AI自动化工作流。
Grist移除社区版SSO功能:开源软件的"SSO税"争议再起
Grist在v1.7.18版本更新中移除了社区版的SSO单点登录功能,将其锁定至付费层级,引发"SSO税"争议。本文分析该事件、开源软件商业化困境及对自托管用户的启示。