Claude Code 推出 Code Mode:用一段代码批量调用工具

Claude Code 推出实验性 Code Mode,让模型写一段 JavaScript 批量编排工具调用。
Claude Code 在 v2.1.323 版本中新增实验性功能 Code Mode:模型不再逐次请求单个工具,而是生成一小段 JavaScript,由 Claude Code 在会话内运行,把多个工具调用打包执行,只把必要结果回传给模型。官方给出三类适用场景——多文件重复改动、搜索结果先过滤再读、多条不相关命令并发。安全上,每次调用仍受 deny/ask 规则和钩子约束,Auto Mode 下分类器审查的是整段代码。该功能默认关闭、仅限终端交互式会话,且不支持网关、Bedrock、Foundry 等接入方式;网传“省 37% Token”实为 Programmatic Tool Calling 的数据,不能直接套用。
Claude Code 推出 Code Mode:用一段代码批量调用工具
AI 编程助手干活的方式,长期以来像极了没写购物清单就去超市的人:跑一趟只拿一样东西,回家看看冰箱,再决定下一趟买什么。Claude Code 这次给出的解法,就是让模型先写一张"购物清单"——一小段 JavaScript——把多个工具调用打包执行。这个功能叫 Code Mode。
按 B 站视频作者的梳理,Claude Code 发布 v2.1.323 版本,更新日志中新增 Code Mode,定位为实验性、需要主动开启的功能:模型会写 JavaScript 来调用它的工具。两个关键词值得记住——实验性意味着默认关闭,后续版本可能调整甚至移除;主动开启意味着你不打开,一切照旧。
传统工具调用为什么低效
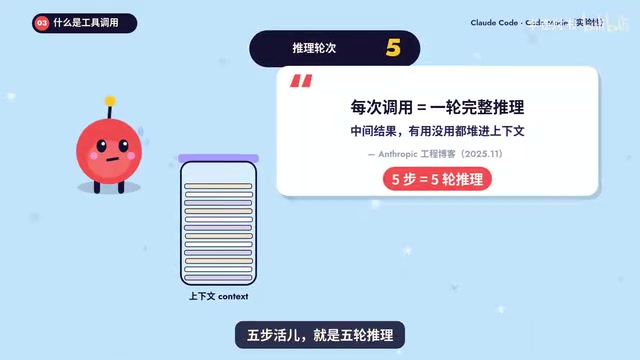
AI 碰不到你的电脑。要跑命令、读文件、改代码,它必须请求工具,比如 Bash、Read、Edit。传统流程是调一次工具、读一遍结果、再想下一步。
Anthropic 的工程博客对此说得很直白:每次调用都要模型完整推理一轮,中间结果无论有用没用,都会堆进上下文。五步的活儿,就是五轮推理。这种"跑十趟"的模式在简单任务上无伤大雅,一旦涉及多文件修改或需要先搜索再过滤的场景,上下文开销和往返次数就成了实打实的负担。
上下文窗口与 Token 开销是理解这一低效的关键。大模型的上下文窗口容量有限,每次工具调用的返回结果(文件内容、命令输出、搜索结果)都会作为 Token 累积进去。Token 既决定成本,也决定模型能“记住”多少信息。逐次调用时,中间结果无论最终是否有用都会占据窗口,容易把真正重要的信息挤到边缘甚至截断。Code Mode 的核心收益之一,就是让这些中间结果留在运行时里被代码消费,只把最终需要的那一小部分回传给模型,从而压低了 Token 消耗和上下文污染。
Code Mode 换了个思路
你照样用一句话描述任务,但 Claude 不再一次只要一个工具,而是写一小段 JavaScript,交给 Claude Code 在会话里运行。几条命令可以同时跑,上一个结果直接喂给下一个调用,最后只把需要的那部分输出交回给 Claude。
有位开发者在 X 上的评价颇为传神:让大模型变聪明的办法,原来就是批处理。
官方文档给出的例子是让 Claude 把重试上限调高:第一行用 rg 搜出含 RetryPolicy 函数的文件,第二行取第一个结果,第三行把 MaxAttempts 从 3 改成 5,最后一行把改动的文件和 npm test 的输出一起交回来。四行代码,一次跑完。
对话里你看到的仍是工具调用,比如编辑的差异。
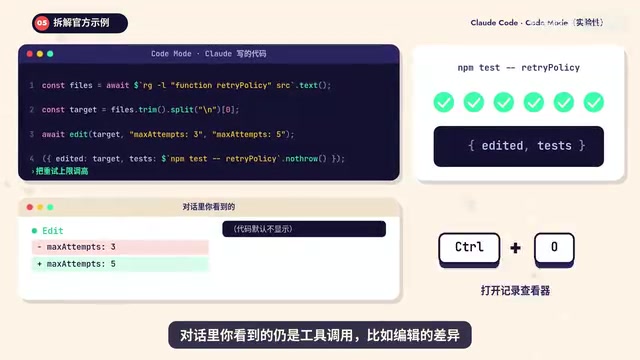
想看代码本身,按 Ctrl+O 即可。
Node VM 与 V8 等运行时是 Code Mode 类功能的执行底座。VM(虚拟机)在这里指一种隔离的 JavaScript 执行环境:Claude 生成的代码在其中运行,而不是直接跑在宿主机上。隔离带来两层意义——一是安全,代码对文件系统、网络的访问仍需经过工具接口和权限规则;二是可控,运行时可以限制执行时间、捕获异常并把结果结构化返回。不同产品选型不同(Node VM、V8、QuickJS 等),差异主要体现在启动开销、隔离强度和可用的 JavaScript 特性上,这也解释了为什么同一思路会呈现出多种工程实现。
适用场景与收益预期
官方举了三类适合 Code Mode 的场景:同一个改动要在很多文件里重复;搜索结果需要先过滤再读;几条互不相关的命令可以同时跑。这三类的共同点是"往返次数多、单次结果小",恰好是传统逐次调用最吃亏的地方。
至于能省多少,Code Mode 目前还没有官方基准数字。网上流传的"省 37% Token"来自 Anthropic 2025 年 11 月在 API 里推出的 Programmatic Tool Calling:内部测试中复杂研究任务的平均用量从 43,588 降到 27,297 个 Token。思路相同,但测的不是同一个功能,这个数字不能直接套到 Code Mode 头上。
安全边界:整段代码如何被审查
一段代码调好几个工具,安全性是绕不开的问题。按视频梳理,有几层机制:
- 每一次工具调用照样要过你的 deny、ask 权限规则和 pre-tool-use 钩子。
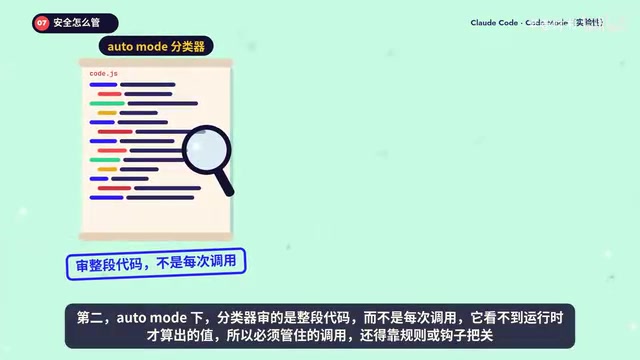
- Auto Mode 下,分类器审的是整段代码,而不是每次调用。
- 项目设置文件里的开关会被忽略——你克隆的仓库没法替你打开 Code Mode。
第二条尤其值得留意:审查粒度从"单次调用"变成"整段代码",意味着那些必须管住的调用,最终还是得靠规则或钩子把关,不能完全指望自动分类器。
pre-tool-use 钩子是 Claude Code 提供的一种拦截机制:在工具真正执行前触发用户或组织配置的脚本,可以检查参数、记录日志,甚至直接拒绝本次调用。它和 deny/ask 权限规则互补——规则按工具名和参数模式做静态匹配,钩子则能执行自定义逻辑,适合处理“必须管住”的敏感操作。Code Mode 下审查粒度变为整段代码后,钩子的价值更突出:分类器可能放过某段整体看似无害的代码,但钩子仍能在每次实际工具调用前逐一校验,相当于在批量执行中保留了逐次把关的最后一道闸门。
已知限制与上手门槛
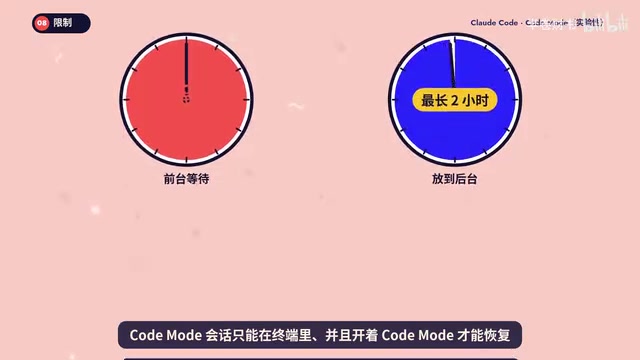
限制方面:如果 Claude 在前台等代码跑完,代码最长 10 分钟就会停下;能放到后台跑的,最长 2 个小时。Code Mode 会话只能在终端里,并且开着 Code Mode 才能恢复;会话里用不了 Remote Control、Claude in Chrome 和 Computer Use,也不能把会话挪到桌面 App 或变成后台会话。
想试的话,先确认版本在 v2.1.323 以上,再把环境变量 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE 设为 1,启动 Claude,第一次会请你确认。
门槛也不少:需要 Claude 订阅或 Console 账号;走网关,或 Amazon Bedrock、Microsoft Foundry 这些云平台都不行;HIPAA 配置或零数据保留的组织用不了;模型要 Sonnet、Opus 5.5 或 Fable 5.2 一类版本,而且只支持终端里的交互式 Claude。
不只是 Claude Code 一家的思路
让模型写代码来调工具,并非 Claude Code 独此一家。开发者 Riz Sullivan 在 X 上做过对比:Claude Code 用 Node VM 在同一进程内运行,Codex 用 V8,OpenCode 用自研解释器,Py 用 QuickJS。同一个点子,四种实现。
这背后其实是同一个判断:与其让模型反复推理、逐次请求,不如让它生成一段可执行逻辑,把编排工作交给运行时。Code Mode 的价值不在于新概念,而在于把它塞进了一个生产级编程助手的默认工作流里——尽管现在还藏在实验开关后面。下次看到 AI 一口气改完十个文件,不必惊讶,它可能只是学会了写购物清单。
Programmatic Tool Calling 是 Anthropic 在 API 层面推出的相关能力,允许模型在单次请求中编写代码来编排多次工具调用。它与 Code Mode 共享“用代码代替逐次推理”的思路,但作用层级不同:前者面向 API 开发者,后者内置于 Claude Code 的终端会话。这也正是文中提醒“37% Token 节省”不能直接套用的原因——测量对象、任务类型和运行环境都不一致,跨功能引用基准数字容易产生误导。
相关推荐
巴赫穆特陷阱:战争中的沉没成本谬误
从巴赫穆特战役拆解战争中的沉没成本谬误:政治象征如何压过战术理性,堡垒标签为何让守军难以撤退,以及经验部队被牵制带来的长期代价。

双盲评审为何失效:学界内部视角揭露的公平性危机
Reddit社区讨论指出双盲评审体系在实践中失效:评审人可见作者信息、学生评审人恶意评审、学术网络影响公平。本文分析这些挑战并探讨改进方向。

LG B6E OLED电视半价促销:55英寸跌至历史低价
LG B6E OLED电视在百思买限时促销中半价,55英寸降至历史低价699.99美元。本文分析B6E的OLED画质优势、促销时效与购买注意事项。