Claude Code vs Codex:同模型同提示词实测,谁更聪明?
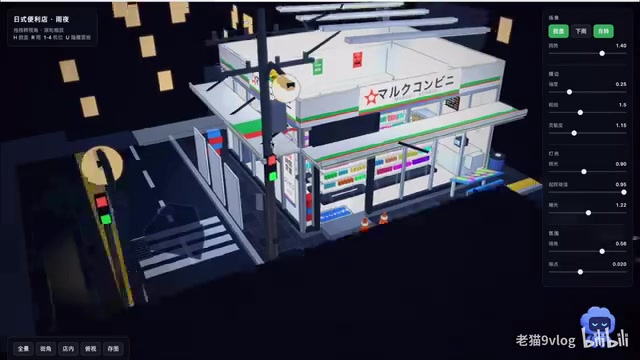
同一本地模型下,Claude Code比Codex更懂意图但受地区限制,选工具需看场景。
B站UP主通过控制变量实验,将同一本地模型分别接入Claude Code和Codex,输入相同提示词生成交互动画。结果显示,Claude Code能主动补全未要求的交互按钮,任务理解更偏意图推断,整体完成度更高;Codex生成速度更快,但画面存在错误,风格与Claude Code不同。UP主认为同模型下Claude Code更聪明,但存在地区限制导致国内部分功能不可用,而Codex兼容性更好。结论是两者各有专攻,选择取决于网络环境和任务需求,同时提醒评价AI编程Agent不能只看模型跑分,工具层的策略同样关键。
在AI编程助手的选择上,Claude Code和Codex是绕不开的两个名字。但大多数人对比时,往往忽略了模型变量——如果让它们跑同一个本地模型、用同一句提示词,差异到底来自工具本身,还是背后的模型?一位B站UP主做了这样一个控制变量实验,结果值得细看。
实验设置:同一本地模型,同一提示词
UP主在本地环境中部署了同一个模型(视频中提及为Q3系列中精度稍低但速度更快的版本),分别接入Claude Code和Codex,输入完全相同的提示词,让两者生成一个带交互按钮的动画场景。这种对比方式剔除了云端模型能力差异的干扰,直接检验两个Agent在任务理解、代码组织和细节补全上的表现。
控制变量实验是科学研究中常用的方法,指在实验中只改变一个变量,保持其他所有条件不变,从而确定该变量对结果的影响。在AI工具对比中,控制变量意味着使用相同的模型、相同的提示词、相同的任务环境,以隔离工具本身(而非模型能力)带来的差异。这种设计能更准确地评估Agent的提示词工程、上下文管理和代码生成策略等工具层特性。
Claude Code:更懂意图,细节自己补
Claude Code交出的第一版结果让UP主有些意外:画面中的那些按钮根本不是提示词里要求的,而是它根据上下文自行判断后加进去的。UP主在视频中直言“根本不是我让他加的”。这种主动补全交互元素的倾向,说明它在理解任务时不止于字面执行,而是试图推断用户的真实意图。
当然,受限于本地模型的精度,画面细节还不够细腻。UP主也承认这个模型本身“不如那个Q3X的”,但优势在于速度快,日常使用中体验更顺畅。
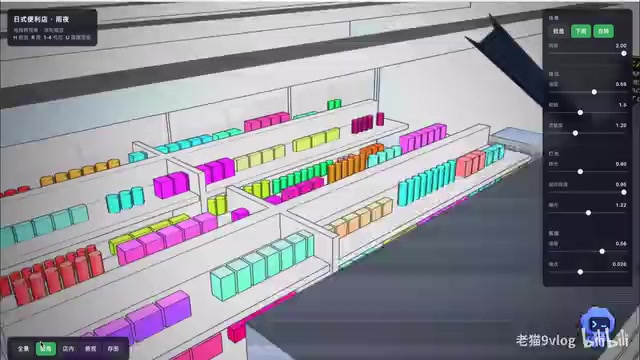
Agent(智能体) 在AI编程助手的语境下,指的是能够自主理解任务、规划步骤并执行代码生成的系统。与简单的代码补全工具不同,Agent通常具备任务分解、上下文维护和工具调用能力。Claude Code和Codex都是典型的编程Agent,它们不仅生成代码,还会根据任务目标主动添加交互元素或调整实现策略,这解释了为何Claude Code会自行补全提示词中未要求的按钮——这是Agent进行意图推断和主动规划的表现。
Codex:速度更快,但风格跑偏
换成Codex,同样的模型、同样的提示词,生成速度确实比Claude Code更快。但UP主指出画面“上面还是有一些错误”,而且做出来的质量和风格与Claude Code完全不同。
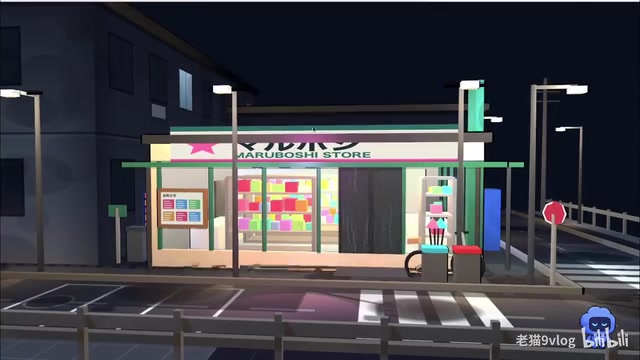
这意味着即便底层模型一致,两个Agent在代码生成策略、结构组织和对提示词的理解路径上存在实质差异。Codex偏向快速产出,Claude Code则在同样的时间里给出了更完整的交互逻辑。
提示词工程(Prompt Engineering) 是指通过设计、优化输入提示词来引导AI模型产生期望输出的技术。在Agent中,提示词工程不仅涉及用户输入的指令,还包括系统内置的提示模板、上下文管理策略以及多轮对话中的信息组织。即使底层模型相同,不同Agent的提示词工程差异会导致对同一提示词的理解路径不同,从而影响生成代码的结构、风格和完整性。这正是Claude Code与Codex在相同模型下产出迥异的关键原因之一。
能力对比:聪明程度与兼容性的取舍
UP主对两者的评价很直接:相同模型下,Claude Code“更聪明更智能”,在他心目中是最聪明的Agent。所有开关、效果以及运镜的切换都非常流畅,整体完成度更高。
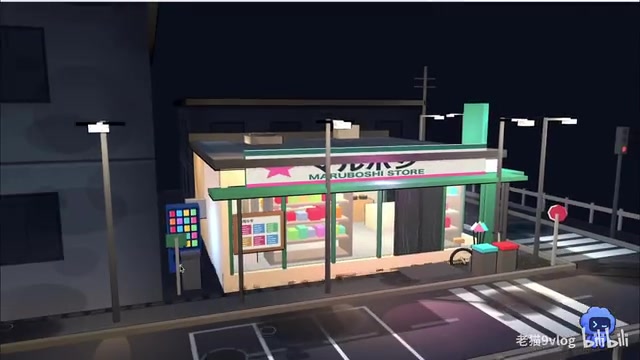
但Claude Code有一个现实短板——地区限制导致国内很多功能无法使用。Codex在这方面的兼容性更好,这也是UP主承认“某些方面Codex比Claude Code强”的原因。
地区限制 在AI服务中通常指因法律法规、数据合规或商业策略等原因,对特定地理区域的用户限制访问或功能可用性。Claude Code作为Anthropic的产品,在中国大陆等地可能无法直接使用全部功能,而Codex(OpenAI的产品)的访问限制相对宽松。这种兼容性差异直接影响开发者的工具选择,尤其对于需要稳定访问的用户而言,工具可用性可能比绝对性能更重要。
怎么选:取决于你所在的环境和任务
UP主的结论是“树叶有专攻”:两个都是非常好的工具,关键看在什么场景下用。如果网络环境允许、追求更高的任务理解力和生成质量,Claude Code是优先选项;如果受限于地区可用性,或者需要更稳定的访问,Codex的兼容性优势就更突出。
这个对比也提醒一点:评价AI编程Agent时,不能只看模型跑分。工具层的提示词工程、上下文管理和代码生成策略,同样会显著影响最终产出。同一个模型交到不同Agent手里,结果可能截然不同。
相关推荐
OpenClaw vs Claude Code:个人助理与编程助手怎么选
OpenClaw 和 Claude Code 有什么区别?本文拆解两者定位:OpenClaw 是开源、支持任意模型、可全天候运行的个人助理,Claude Code 是终端里的编程助手,并对比 Claude Cowork 的差异与选型建议。
Claude Code不止写代码:七大Artifact实战解析
Claude Code 不只是编程工具:本文解析其七种 Artifact(文档、表格、设计、白板、幻灯片、数据等)的实际用法,以及如何一句话把 Artifact 升级为 Vercel + Convex + GitHub 部署的完整 Web 应用。
Hermes Agent自进化机制:用Markdown技能实现越用越懂你
解析Hermes Agent的自改进机制:如何通过Markdown技能文件沉淀任务经验,支持手动或自动存储、跨任务复用与基于反馈的技能修正,实现越用越懂你的个性化体验。