Claude Code成本差11.9倍:Effort子代理省钱指南

Claude Code 的 Effort 档位可致同一任务成本差近12倍,默认设置与子代理分级是省钱关键。
Claude Code 的 Effort(思考预算)设置隐藏着巨大的成本差异:以 High 为基准,Low 档成本仅 0.47X,而最深档可达约 11.9X,同一任务开销相差近 12 倍。不同模型默认档位不同(5.5 系列默认 Medium、Opus 4.7 默认 X High),不主动设置就会持续按默认烧钱。新机制允许为每个子代理单独指定 Effort,实现搜索用 Low、重构用 High 的精细分配。文章还揭示三个常见坑:默认非 Low、老模型无 X High 会静默按 High 跑、Max 仅当前会话生效。实操上可通过查看档位、子代理定义写 Effort、环境变量统一调低或设上限自动降级来控制成本。
同一个模型、同样的任务,成本可能相差近12倍——差别只在一个被大多数人忽略的设置:Effort(思考预算)。Claude Code 官方成本表曝光后,这个隐藏参数成了控制 AI 编程开销的关键。
据 B 站 UP 主「明镜与点点」的分析,Effort 在 Claude Code 中分为多个档位,官方为每档标注了相对成本指数(以 High 为基准):Low 为 0.47X,High 为 1X,Max 为 5.59X,最深一档成本指数达到 11.92。这意味着如果默认设置选错,同样一次代码生成可能烧掉近 12 倍的钱。
Effort 档位成本表:低档省钱,高档烧钱
官方成本表显示,Effort 档位并非线性增长。最温和的档位之间只差 2.3 倍,而 High 到 Max 的跨度则陡增到 5.59 倍,最深档位直接逼近 12 倍基准。
| 档位 | 成本指数(以 High 为基准) |
|---|---|
| Low | 0.47X |
| High | 1X(基准) |
| Max | 5.59X |
| 最深档 | 约 11.9X |
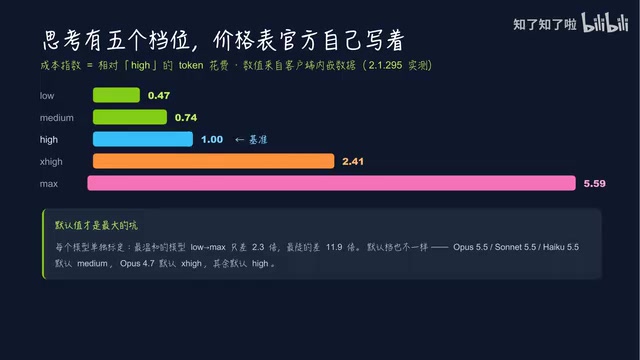
不同模型还有各自的标定。例如 Opus 4.7 的默认档位是 X High,而 5.5 系列默认是 Medium,其余模型默认 High。换句话说,你不主动设置,它就会按默认档位持续消耗预算。
子代理派活:一个任务一个预算
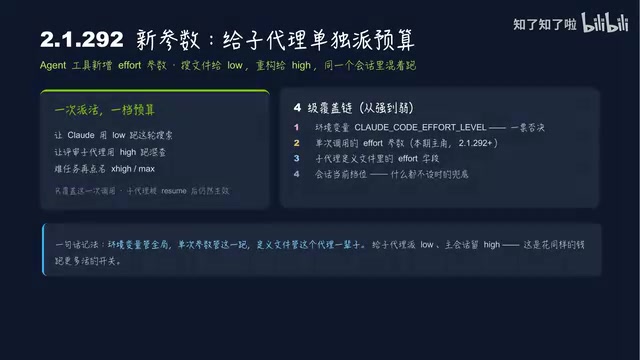
Claude Code 的新机制允许给每个子代理(subagent)单独指定 Effort 参数。以前整个会话只有一个全局档位,现在可以按任务类型精细分配:搜索类子代理给 Low,重构类给 High,人物类可以点名 X High。
这种分级思路解决了此前「一刀切」的浪费问题——并非所有任务都需要深度思考。搜索、素材整理等轻量工作用 Low 档就足够,而重构、复杂推理才需要 High 或更高。
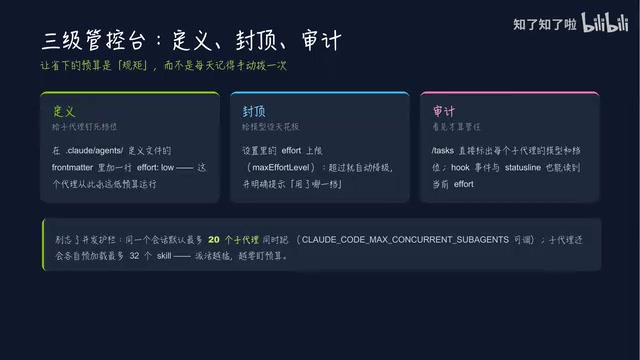
据该 UP 主总结,Effort 的覆盖链有四层:环境变量可以一票否决单次调用参数;Resume 后设置仍生效;定义文件字段可固化档位;Agent 定义文件写一行 Effort 就能让该代理永远低预算。三层落地方式分别是定义层(Agent 定义文件写死)、封顶层(设置里设 Effort 上限,超了自动降级)、审计层(Tasks 标出每个子代理的模型和档位)。
子代理(subagent)机制是 Claude Code 中一种将复杂任务拆解并委托给独立执行单元的架构。主会话(main session)负责统筹规划与结果整合,而子代理则针对具体子任务(如代码搜索、文件整理、重构建议)在隔离的上下文中运行。每个子代理拥有独立的提示词、工具权限和参数配置,因此可以单独指定 Effort 档位,实现“按任务类型分配预算”。这种设计避免了全局单一档位导致的资源浪费——轻量任务不会被迫使用高成本推理,而关键任务仍可获得充足算力。子代理的运行结果会返回主会话,由主会话决定是否采纳或进一步追问,从而在保证整体质量的同时优化开销。
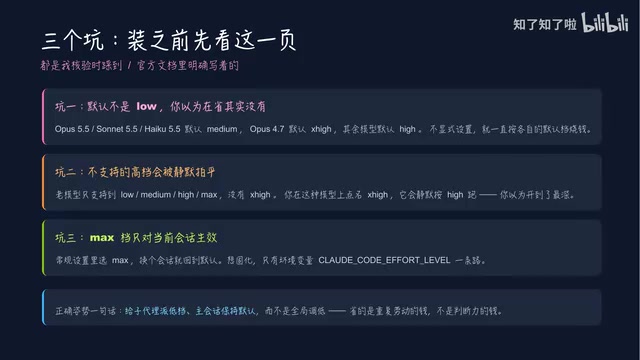
三个常见坑:默认设置正在悄悄烧钱
第一个坑是默认档位并非 Low。5.5 系列默认 Medium,Opus 4.7 默认 X High,不设置就一直在按默认烧钱。
第二个坑涉及静默派发。开屏老模型没有 X High 档,点名它会默默按 High 跑,你可能以为给了低预算,实际仍在中高档消耗。
第三个坑是 Max 只对当前会话生效,不会自动延续到下次。这意味着每次新会话都需要重新确认档位。
静默派发(silent dispatch) 指当用户指定一个不支持某档位(如 X High)的旧模型时,系统不会报错或提示,而是自动降级到该模型支持的最高档位(通常是 High)继续执行。用户可能误以为自己设置了低预算或高预算,实际消耗却与预期不符。这种机制在兼容性上友好,但在成本控制上具有隐蔽性:尤其当用户误以为点名老模型能省钱时,实际仍按中高档位计费。要避免此坑,需在派发前确认目标模型支持的档位范围,或通过环境变量强制覆盖,确保实际消耗与预期一致。
正确姿势与三条实操命令
核心策略是:子代理派低档,主会话保持默认。这样既保证主流程的推理质量,又在可替代的轻量任务上省钱。
现在就能动手的三条命令:
- 敲 Effort 查看当前档位,按 S 只改本次,回车存默认。
- 在子代理定义文件里写一行 Effort,搜索定 Low、评审留 High。
- 用环境变量把子代理统一调低,或在设置层设上限自动降级。
对于每天大量调用 Claude Code 的团队来说,Effort 分级不是可选项,而是成本控制的必修课。先看清你的子代理跑在哪一档,再决定哪些任务值得花 12 倍的钱。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。