Claude Code省Token三习惯:从清空到模型匹配

控制上下文规模并按需匹配模型,是降低 Claude Code Token 消耗的关键。
文章指出,Claude Code 的 Token 消耗过快往往源于交互习惯而非模型本身,因为每次请求都会携带完整对话历史,上下文越长固定开销越大。作者总结官方文档中的三个省 Token 习惯:任务切换时用 /clear 清空会话(配合 /rename 与 /resume 保留记录);按任务难度选择模型,Sonnet 应付多数编码任务、Opus 留给复杂推理、简单子代理任务用 Haiku;长对话用 /compact 有目的地压缩,并通过 /usage 定位消耗来源。三者共通逻辑是控制上下文规模、按需分配模型能力。
为什么你的Claude Code Token烧得这么快?
如果你在用Claude Code写代码,可能已经注意到:明明没聊几句,用量却掉得飞快。问题往往不在模型本身,而在交互习惯。据YouTube频道SHA Source的总结,官方文档里其实藏着三个能显著降低Token消耗的习惯,关键在于控制上下文和按需选择模型。
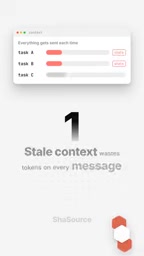
Claude Code每次请求都会携带完整对话历史,这意味着上下文越长,每条消息的固定开销就越大。理解这一点,是省下Token的起点。
习惯一:任务切换时主动清空上下文
最容易被忽略的浪费,是残留的旧上下文。当你从一个任务切到另一个不相关的任务时,如果不清空对话,Claude Code每次请求仍会把整段历史打包发给模型,旧内容在后续每条消息里持续产生费用。
官方推荐的流程是:用 /clear 清空当前会话;如果希望日后还能找回,先用 /rename 给会话命名,需要时通过 /resume 恢复。这样既避免了跨任务的上下文污染,也不会丢失重要工作记录。
这个习惯的收益是累积的。会话越长、切换越频繁,清空带来的节省越明显。
习惯二:让模型与任务难度匹配
不是所有任务都值得用最贵的模型。据SHA Source的说明,Sonnet足以胜任大多数编码任务,成本低于Opus;Opus应留给复杂架构设计、多步推理这类真正吃脑力的场景。通过 /model 命令可以随时切换。
对于简单的子代理任务,Haiku 3是更经济的选择——这类任务通常指令明确、不需要深度推理,用小模型处理性价比更高。
这套策略的核心是:把最贵的资源用在最难的问题上,而不是让Opus去写一个简单的辅助函数。养成按任务难度选模型的习惯,长期下来Token消耗会有可感知的下降。
Claude 3 系列中的 Haiku 是轻量级模型,推理速度快、单位 Token 成本显著低于 Sonnet 和 Opus,适合指令明确、输出结构化的任务,例如格式转换、简单的文件读写、模板化代码生成或子代理的例行调度。它的局限在于复杂逻辑推理和长链思考能力较弱,遇到需要多步权衡的场景容易给出浅层答案。因此把 Haiku 用于子代理的关键在于任务边界足够清晰:主代理负责拆解与规划,Haiku 只执行确定性的子步骤,这样既控制了成本,又不牺牲整体质量。
习惯三:有目的地压缩上下文
当对话确实变得很长时,/compact 可以把历史摘要化,释放上下文空间。但压缩并非无脑执行——你可以附加指令,比如要求摘要时聚焦代码示例和API用法,让压缩后的上下文保留真正有用的信息。
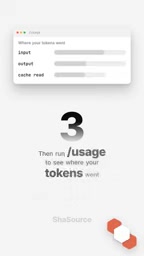
压缩之后,用 /usage 查看Token都花在了哪里。这能帮你识别浪费的来源:是某次长会话没有清空,还是某个任务用了过大的模型。
小上下文意味着每条消息的固定开销更小。把压缩和用量查看结合起来,你就能形成一个可观测、可调整的省Token闭环。
子代理(subagent)是 Claude Code 中把任务委派给独立上下文实例的机制。主会话负责总体规划和与开发者交互,子代理则在隔离的上下文中执行具体子任务,只把结果返回主会话。由于子代理不继承主对话的全部历史,它的上下文更短,单次请求的固定开销也更小,这正是可以用更小模型驱动它的原因。合理划分主代理与子代理的职责,能让昂贵的模型只处理规划与决策,把机械性执行交给低成本实例,从而进一步压低整体 Token 消耗。
三个习惯的共通逻辑
这三个习惯指向同一个原则:控制上下文规模,按需分配模型能力。清空解决的是跨任务的历史残留,模型匹配解决的是能力过剩,压缩解决的是单会话内的冗余增长。三者叠加,覆盖了Token消耗的主要来源。
SHA Source建议从下一次会话就开始用 /clear。这个动作几乎没有成本,却能让你的每次请求都更轻。对于高频使用Claude Code的开发者来说,这些习惯值得固化成日常流程的一部分。
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。