Claude Code省Token指南:告别周限额焦虑
从诊断消耗到压缩上下文,五招降低 Claude Code 的 token 用量。
文章梳理了 YouTube 频道 AI Builder 提出的若干 Claude Code 省 token 技巧,核心思路是在对话历史、推理强度与上下文规模三个杠杆上做减法。先用 /usage 按百分比定位消耗分布,做到有的放矢;理解每条消息都会重发全量对话历史这一机制,在任务切换时用 /clear 隔离无关上下文;对简单任务调低 /effort,避免单次思考烧掉数万 token;非必要不启用 token 消耗约为普通模式 7 倍的 agent teams;在大仓库场景用 Graphify 生成代码地图替代逐文件读取,使用者报告可降低最多 70 倍用量。文章也提醒,7 倍与 70 倍均为经验报告值,且这些方法只能优化限额内的分配,无法突破套餐上限。
Claude Code 的周限额让不少开发者头疼,尤其当项目进入冲刺阶段,token 消耗速度往往超出预期。YouTube 频道 AI Builder 近期发布的一条短视频,从使用习惯到工具辅助,给出了几条降低 token 消耗的实操建议。这些方法并不复杂,但每一条都指向 Claude Code 消耗 token 的真实机制。
先定位消耗源头:/usage 命令
面对限额告急,最忌讳盲目调整。视频建议的第一步是运行 /usage 命令,它会按百分比展示你当前的 token 消耗分布,让你清楚看到限额主要被哪些部分吃掉。这个动作本身不节省 token,但它让后续的优化有据可依——知道钱花在哪,才谈得上省钱。很多开发者凭感觉认为大量消耗来自代码生成,而实际数据往往指向对话历史或思考过程。
每轮重发全量对话:/clear 的成本逻辑
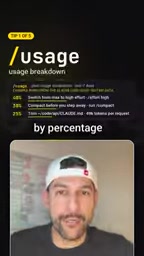
一个容易被忽略的机制是:Claude Code 在每次消息交互时,都会把整个对话历史重新发送给模型。这意味着对话越长,单条消息的隐形成本越高,哪怕你只是追问一句“继续”。视频指出,正因为如此,在任务切换时执行 /clear 清空上下文几乎不产生成本——清空的是本地历史,而不是已经消耗的额度。把不相关的任务隔离开,避免无关上下文被反复携带,是控制消耗最直接的手段之一。
这一机制源于大语言模型 API 的无状态特性:模型本身不保留任何会话记忆,所谓“上下文”完全是客户端在每次请求时重新拼装并发送的。因此对话历史、系统提示、已读文件内容都会作为输入 token 重复计费,且随轮次线性增长。业界常用的应对手段包括上下文压缩(把早期对话摘要化)、按需检索(只取相关片段而非全量注入)以及会话隔离。理解这一点,就能明白为何长会话的边际成本会迅速抬升,也能解释为什么“清空上下文”在多数工具中都是免费操作——它只影响本地保存的消息列表,不触碰已经产生的计费记录。
调低推理强度,跳过非必要的 agent teams
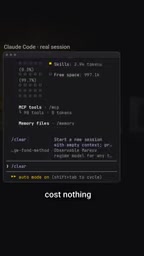
对于简单任务,可以降低 /effort 设置。视频提到,仅“思考”环节本身,单次请求就可能烧掉数万 token。把推理强度调到与任务复杂度匹配的水平,能避免为一句格式化改写付出不必要的推理开销。
另一条建议更为激进:除非绝对必要,否则跳过 agent teams。视频给出的理由是 agent teams 的 token 消耗大约是普通模式的 7 倍。多智能体协作在复杂任务上有价值,但把它当作默认配置,会让限额在不知不觉中见底。对大多数日常开发任务而言,单线程交互已经够用。
推理强度(reasoning effort)是近年来推理型模型引入的可调参数,通常分为低、中、高三档。高强度模式下,模型在给出答案前会生成更长的内部思维链,逐步拆解问题、自我检查,从而提升复杂推理任务的正确率;但这段思考内容同样按输出 token 计费,且往往占单次请求的大头。低强度模式则压缩或跳过显式推理,适合格式转换、简单改写、样板代码生成等不需要多步推导的任务。实践中可按任务分层:架构设计、疑难调试用高强度,日常补全和机械性修改用低强度,避免用“大炮打蚊子”。
大仓库场景:用代码地图替代全量阅读
在大型代码库上工作时,Claude Code 需要读入大量文件才能建立上下文,这是 token 消耗的重灾区。视频提到一种工具 Graphify,它先把代码库映射成结构化的地图,让 Claude 读取地图而非逐个文件。据使用者反馈,这种做法能让 token 用量最多降低 70 倍。这一数字来自使用者的报告而非官方基准,实际效果会因仓库结构和任务类型而异,但“先给地图再给细节”的思路本身符合上下文管理的常识:减少冗余输入,才能把额度留给真正需要推理的部分。
所谓“代码地图”,本质是一种结构化索引:通过静态分析提取仓库中的文件、函数、类、导入关系与调用链,再以精简的符号表或依赖图形式呈现给模型。相比把源文件原文塞进上下文,符号级索引的 token 密度高得多——一个函数可能只需一行签名而非数十行实现。这类做法与检索增强生成(RAG)思路相通,区别在于索引对象是代码结构而非自然语言文档。常见的实现方式包括基于抽象语法树(AST)解析、语言服务器协议(LSP)查询,以及构建调用图后按需展开。其代价是需要预先建立并维护索引,仓库频繁变动时索引可能滞后,因此适合结构相对稳定的大型项目。
综合建议与局限
把这些方法串起来看,核心逻辑是一致的:Claude Code 的 token 消耗由对话历史、推理强度和上下文规模共同决定,优化就是在这三个杠杆上做减法。/usage 用于诊断,/clear 用于隔离,/effort 用于匹配任务复杂度,跳过 agent teams 用于避免超额开销,Graphify 用于压缩大仓库的输入规模。
需要说明的是,视频内容以经验分享为主,其中 7 倍和 70 倍这两个数字均是创作者或使用者的报告值,缺乏独立验证。另外,这些优化本质上是在限额内做更高效的分配,并不能突破套餐本身的上限。如果周限额频繁触顶,除了调整使用习惯,可能也需要重新评估套餐档位是否匹配实际用量。
相关推荐
智能体与工作流:LangGraph 工作流编排的核心概念解析
基于B站老肖的LangGraph教程,解析工作流与智能体的本质区别:编排权归属、复杂业务选型、StateGraph三大组件及构建流程,帮助开发者合理选择架构方案。
LangGraph工作流与智能体:企业级AI编排新解
LangGraph工作流与智能体的核心区别是什么?本文解析状态图三要素(状态、节点、边),探讨工作流如何编排复杂AI业务,以及LangChain 1.0企业级应用中的协同策略。
4个习惯正在偷走你的Claude Code额度(附诊断提示词)
Claude Code额度消耗过快?本文拆解4个常见烧额度习惯:模糊需求、冗长日志、随意开子代理、长会话不切换。附一个能扫描最近七天日志、自动找出你个人耗电前三名的提示词,并给出针对性修正规则。