Claude Fable 5.1 登陆 Cursor:CursorBench 得分 73.4% 的编程新王者
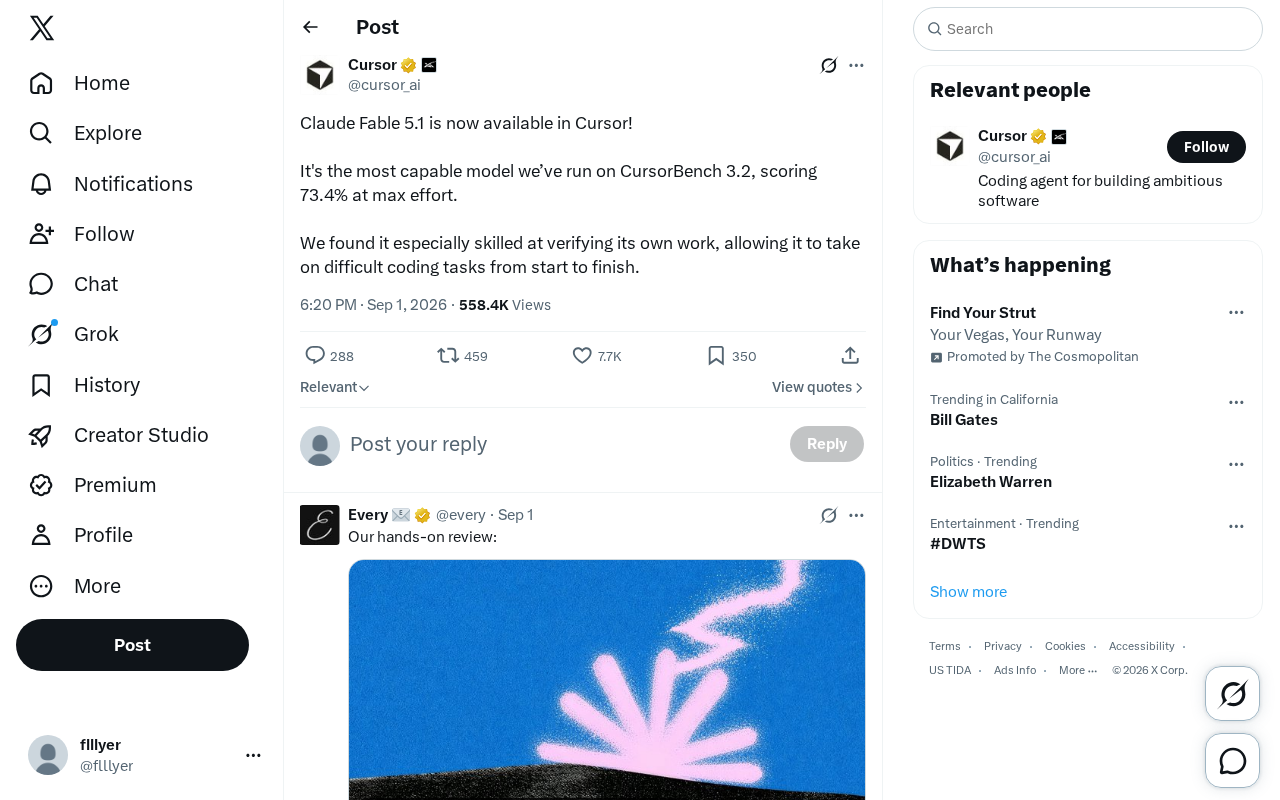
Claude Fable 5.1登陆Cursor,以73.4%刷新内部编程基准,自我验证能力成最大亮点。
Cursor官方宣布接入Claude Fable 5.1,该模型在内部基准CursorBench 3.2的最大算力模式下取得73.4%的成绩,成为Cursor迄今运行过的最强编程模型。与HumanEval等学术基准不同,CursorBench更贴近真实IDE开发流程,涵盖跨文件理解与多步骤任务。Fable 5.1的核心优势在于自我验证能力——模型能主动审视、发现并修正自身代码中的问题,这是从「代码补全助手」迈向「自主编程agent」的关键跃升。对开发者而言,这意味着可以将更大颗粒度的任务直接交给模型处理,减少反复拆分与人工介入的频率。不过73.4%的基准分仍代表约四分之一任务未能达标,代码审查与人工把关依然必要。
Cursor 官方宣布,Claude Fable 5.1 已正式接入其编程环境,并在内部基准测试 CursorBench 3.2 上刷新了纪录——在最大算力投入(max effort)模式下取得 73.4% 的成绩,成为 Cursor 迄今运行过最强的模型。
CursorBench 3.2 上的表现意味着什么
CursorBench 是 Cursor 团队用于衡量模型在真实编程场景中综合能力的基准套件。与许多学术型代码评测(如 HumanEval)不同,这类内部基准更贴近 IDE 中的实际开发流程——涉及跨文件理解、上下文追踪以及多步骤任务的连贯执行。
73.4% 的分数本身需要结合基准的难度来解读。CursorBench 3.2 属于持续迭代的评测版本,通常会随着模型能力提升而不断加入更难的任务,因此同一分数在不同版本间并不能简单横向对比。但 Cursor 明确将 Fable 5.1 定位为「最强」,说明它相较于此前接入的模型确实拉开了差距。
值得关注的是「max effort」这一限定条件。它暗示该分数是在模型充分调用推理算力(可能包含更长的思考链或多轮自我校验)的前提下取得的。这既体现了模型的能力上限,也提示实际使用时的表现会受到算力配置的影响。
HumanEval 是由 OpenAI 发布的经典代码生成基准,包含 164 道 Python 编程题,通过「pass@k」指标衡量模型生成正确函数的概率。由于题目结构相对固定、上下文单一,顶尖模型已能轻松超过 90%,因此其区分度正在下降。相比之下,CursorBench 这类面向真实 IDE 场景的内部基准,刻意引入了多文件依赖、模糊需求描述和增量修改等挑战,更能反映模型在实际工程任务中的有效性。这也是为什么 73.4% 在 CursorBench 3.2 上的含金量,远比同样分数在 HumanEval 上更具参考价值。
「自我验证」能力为何是关键突破
Cursor 在公告中特别强调,Fable 5.1「尤其擅长验证自己的工作」,从而能够端到端地承接高难度编程任务。这一点比单纯的分数更值得玩味。
在自动化编程中,模型最大的痛点往往不是「写不出代码」,而是「写完之后无法判断对错」。传统模型倾向于自信地输出看似合理但存在逻辑缺陷的代码,缺乏对自身产出的批判性检查。而具备自我验证能力的模型,可以在生成后主动审视、发现问题并迭代修正,这大幅降低了人工介入的频率。
对于「从头到尾完成困难编码任务」这一目标而言,自我验证是从「代码补全助手」迈向「自主编程 agent」的核心能力之一。当模型能够自己发现 bug、验证测试结果、判断任务是否真正完成时,它才有资格承接需要多步骤、长链条推理的复杂工程任务。
自我验证能力在技术层面通常通过「自我反思(self-reflection)」或「过程奖励模型(Process Reward Model, PRM)」等机制实现。前者让模型在生成答案后再次审视并批判自身输出;后者则在训练阶段对推理中间步骤给予奖励信号,使模型学会在每个推理节点评估正确性,而非仅凭最终输出获得反馈。在 agentic 编程场景中,这种能力尤为重要:模型需要在运行测试、读取报错信息、修改代码之间循环迭代,每一步都需要对当前状态做出准确判断。缺乏自我验证的模型往往陷入「自信出错」的循环,即便拥有较高的初次生成准确率,也难以可靠完成多步骤的端到端任务。
对开发者工作流的实际影响
从使用者角度看,一个更擅长自我校验的模型意味着更少的返工。开发者可以把更大颗粒度的任务交给它——例如实现一个完整功能模块,而不必将任务拆解成一个个小提示反复喂给模型。
不过,实践中仍需保持理性预期。73.4% 的基准分意味着仍有约四分之一的任务表现不达标,且这一分数是在最大算力下取得。日常开发中,代码审查、测试覆盖和人工把关依然不可或缺。模型的自我验证降低了错误率,但并不等同于免除责任。
对 Cursor 生态而言,接入更强的模型是其持续巩固「AI 优先编辑器」定位的关键动作。随着编程模型能力的快速迭代,谁能第一时间集成最强模型、并优化好上下文管理与算力调度,谁就能在开发者体验上建立优势。
小结
Claude Fable 5.1 在 Cursor 的落地,反映出编程大模型正从「会写代码」向「能独立完成任务并自我把关」演进。CursorBench 3.2 上 73.4% 的成绩和突出的自我验证能力,是这一趋势的具体注脚。对开发者来说,这是一次值得尝试的升级,但仍应结合自身工作流评估实际收益。
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。