Claude Fable 5.2 发布:三大能力跃升与定价冲击

Anthropic 发布同源双模型 Fable 5.2 与 Mythos 5.2,以更快更便宜且能力全面反超的姿态施压 OpenAI。
Anthropic 推出 Claude Fable 5.2 与 Mythos 5.2,两者共享底层架构,后者因保留完整网络安全能力而仅向企业与安全客户开放,前者收敛敏感能力后对公众发布。Fable 5.2 输出速度较上代提升约三成,定价低于 OpenAI Astra,并提供加价的快速模式。基准测试中,其在智能体编程上反超 Opus 5.5,图表识别从短板转为领先,并以更少 token 完成同等任务。Anthropic 披露内部超九成代码变更由 Claude 撰写,模型还曾协调上千子智能体在八天内产出可运行操作系统原型,能力延伸至电路板设计与机器人控制。
Anthropic 推出 Claude Fable 5.2 与 Mythos 5.2,前者面向公众开放,后者仅供企业级与网络安全客户使用。据 B 站 UP 主葡语解说视频的梳理,这次发布不只是常规迭代,而是在推理速度、代码智能体、多模态理解与硬件/机器人控制上同时抬高了上限,并以更低的推理成本直接向 OpenAI 施压。
双模型同源:Fable 5.2 与 Mythos 5.2 的分野
两个模型共享同一底层架构,区别在于安全裁剪的力度。Mythos 5.2 保留了完整的网络安全与渗透相关能力,Anthropic 认为其风险过高,不向公众开放,专供 Big Tech 与网络安全公司。Fable 5.2 则在这些敏感能力上做了收敛,面向普通开发者和企业用户。
这种「同源双发」的思路意味着,公众拿到的 Fable 5.2 在通用智能上并不缩水,被削减的主要是攻击性安全能力。对于绝大多数编程、科研与自动化任务而言,这不会构成实际损失。
「安全裁剪」是指对同一基础模型进行能力层面的限制性微调,而非重新训练一个更小的模型。常见做法包括拒绝学习(refusal training)、在特定领域数据上做定向削弱、以及部署侧的策略过滤。Anthropic 采用的是「同源双发」策略:底层权重与推理能力保持一致,仅对攻击性安全能力(如漏洞利用、渗透测试指令)做差异化处理。这种做法在业界并不罕见,OpenAI 与 Google 也曾对高风险能力采取分级开放,但将同一代模型拆分为公众版与企业版并明确披露裁剪范围,属于较为透明的处理方式。其代价是安全对齐可能被越狱手段部分绕过,因此企业版通常还配合合同约束与使用监控。
速度与成本:更快的推理,更低的门槛
据视频介绍,Fable 5.2 的输出生成速度比 Fable 5.1 提升约三成,推理等待时间明显缩短。定价方面,输入与输出 token 的价格均低于 OpenAI 的 Astra,UP 主在视频中直接判断「OpenAI 会有麻烦」,并推测 OpenAI 可能在第四季度末有所回应。
模型还提供可选的快速模式,能将 token 生成速度进一步大幅提升,价格相应上浮。这个设计明显借鉴了 OpenAI 在 Astra 上的产品策略——用价格换速度,把延迟敏感型负载单独定价。
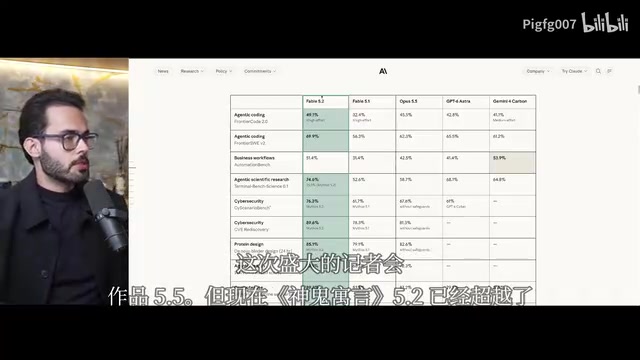
基准测试:从追赶 Opus 到反超
此前 Anthropic 内部存在一个尴尬局面:Opus 5.5 在实际使用中比 Fable 5.1 更划算,导致新模型叫好不叫座。Fable 5.2 试图终结这个问题。
在智能体编程(agentic coding)任务上,Fable 5.2 的得分较 Fable 5.1 大幅跃升,并高于 Opus 5.5。视频给出的对比是:Fable 5.2 在代码库重构、复杂工程任务上已经越过 Opus 5.5 的水平线。
其他维度的表现同样全面:
- 科学研究:得分显著高于对比模型
- 蛋白质设计:达到较高水平
- 智能体搜索:领先 Opus 5.5 与另一竞品
- 计算机使用:超过 Opus 5.5、Astra 与 Gemini 4 Carbon
最说个细节图表识别能力。Claude 系列此前在视觉图表理解上一直是短板,Fable 5.1 与 Opus 5.5 的得分都不理想,而 GPT-Astra 与 Gemini 4 Carbon 在这一项上明显更强。Fable 5.2 这次直接反超所有对手,UP 主称之为「其中一个大的跃升」。
效率:更少 token 完成同样的事
Fable 5.2 在默认的中等努力档位下,完成复杂任务所消耗的 token 少于 Fable 5.1。在 Frontier Code 评测中,Fable 5.2 以高努力档位取得了接近 Opus 5.5 最高努力档位的成绩,而每任务成本约为后者的一半。
更高的「超高」档位则拿下了所有已测试模型中的最高分。不过视频也指出一个反直觉的现象:把努力档位拉到最大后,效率反而下降,每任务成本大幅上升,而超高檔位的性价比明显更好。这说明模型的能力曲线并非线性,盲目堆算力并不划算。
「努力档位」(effort level)是推理模型的一种推理预算控制机制,本质是调节模型在生成答案前进行内部思考的 token 数量或搜索深度。档位越高,模型越倾向于展开更长的思维链、尝试更多解题路径,从而提升难题上的成功率,但延迟与成本也随之上升。文中所说的「能力曲线并非线性」,正对应推理计算的最优分配问题:对于固定任务分布,存在一个性价比拐点,超过该点后边际收益递减甚至为负(例如过度思考引入错误路径或重复验证)。因此实际部署中通常按任务难度动态选择档位,而非一律拉满。
内部实战:Anthropic 自己怎么用
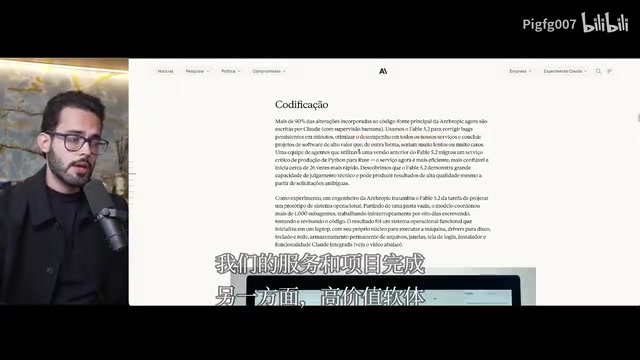
Anthropic 披露了一组内部数据:超过九成的代码变更现在由 Claude 撰写,并配合人工监督。团队用 Fable 5.2 在数分钟内修复顽固 bug、优化全线服务性能,并完成原本更慢更贵的高价值软件项目。
一个具体案例是:一支智能体团队使用 Fable 5.2 的早期版本,将一个关键生产服务从 Python 迁移到 Rust,迁移后服务更高效、更可靠,启动速度提升了一个数量级。
另一个被 UP 主称为「疯狂」的实验是:工程师让 Fable 5.2 从空文件夹开始设计一个操作系统原型。模型协调了上千个子智能体连续工作八天,编写、测试、审查代码,最终产出一个可运行的系统——具备自己的内核、磁盘/键盘/网络驱动、持久化文件存储、窗口系统、登录界面、安装器以及云端功能集成,能在一台笔记本上启动。
「子智能体」(sub-agent)指由一个主控模型编排、各自拥有独立上下文与工具权限的下级智能体实例。主智能体负责任务分解、结果汇总与冲突消解,子智能体并行执行编码、测试、审查等具体环节,形成类似工程团队的协作结构。这种多智能体编排能突破单次上下文窗口的限制,并把长任务拆成可验证的小步骤,但也带来协调开销、错误传播与成本失控的风险。文中「上千个子智能体连续工作八天」的案例,关键在于主控层对子任务边界与验收标准的严格定义,否则并行规模越大,返工越严重。
从软件到硬件:电路板与机器人
Fable 5.2 的能力边界延伸到了物理世界。Anthropic 与一家电路板设计制造商合作,用一段提示词让模型设计并制造三个可用的电子设备:家用语音助手中枢、USB 免提通话器、便携虚拟宠物。模型自行编写规格、绘制电路、设计外壳,最终设备可正常工作。
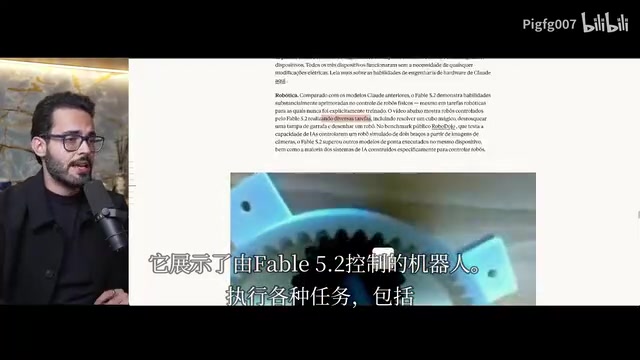
机器人控制方面,Fable 5.2 展现出相较前代大幅提升的能力,即使面对从未被明确训练过的任务也是如此。演示中,由 Fable 5.2 控制的机器人完成了解魔方、拧开瓶盖、画机器人等动作。在一个基于摄像头图像控制双臂模拟机器人的公开基准上,Fable 5.2 超过了其他在相同设备上运行的尖端模型,也超过了多数专门为机器人控制构建的系统。
UP 主对画机器人那段评价颇为戏谑——「画得像两岁小孩」——但也承认,今天看起来粗糙的演示,明天可能就会变成另一种东西。
「视觉-语言-动作模型」(VLA)是当前机器人控制的主流范式:模型以摄像头图像与语言指令为输入,直接输出关节动作或末端执行器指令,从而绕开传统的手工建模与运动规划管线。其优势是能泛化到未明确训练过的任务,因为预训练阶段吸收了大量视觉与语义先验;短板则在于精确力控与长时序稳定性仍不及专用控制器。文中「在基于摄像头图像控制双臂模拟机器人的公开基准上超过专用系统」,反映的正是 VLA 路线在泛化性上的进展,但模拟环境与真实硬件的差距(sim-to-real gap)仍是落地的主要障碍。
生态验证与竞争格局
早期测试者包括 Vercel、Shopify、Datadog、Unity、Uber、Oracle 等公司,反馈集中在一点:Fable 5.2 的编程能力可以平滑迁移到各类任务上。
对开发者来说,这次发布的核心信号是:前沿模型的竞争重心正从「谁的分数高」转向「谁能在单位成本内完成更多真实工作」。Fable 5.2 在速度、价格、token 效率和任务成功率上同时推进,配合从代码到硬件的能力扩展,把压力直接传导给了 OpenAI。UP 主预告将制作 Fable 5.2 与其他模型的实测对比,届时可以看到纸面分数之外的真实差异。
相关推荐
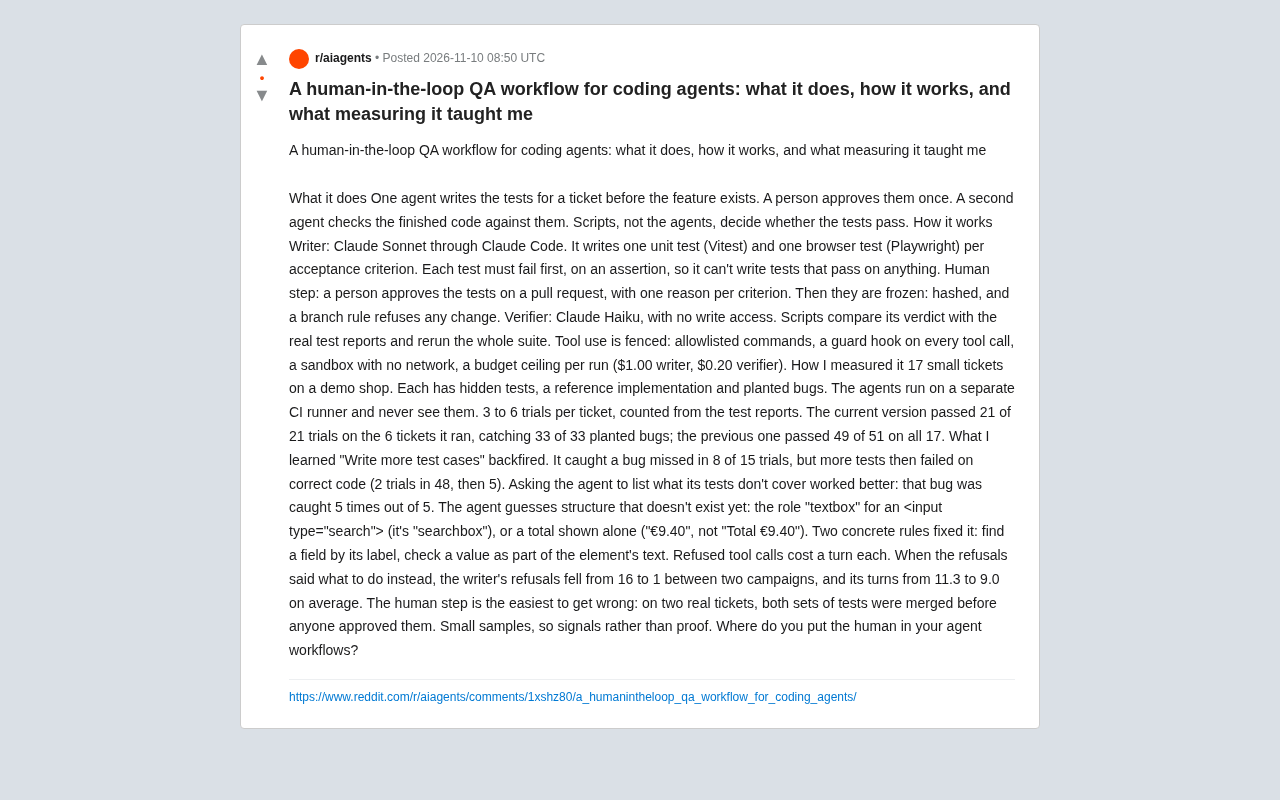
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。
MiniMax开源H3-Image:基于H3的开放权重图像模型
MiniMax发布开放权重图像模型H3-Image,基于H3视频模型构建。社区关注其图像编辑能力、文生图质量及32B文本编码器带来的部署负担,有望与Qwen Image 2.1等模型展开竞争。
Claude Fable 5.2 与 Mythos 5.2 发布:同款模型的双重安全策略
Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2,同一底层模型搭配不同安全防护等级。Fable 5.2 在 FrontierCode 2.0 得分 49.1%,输入输出定价每百万 token 8/40 美元,支持 100 万 token 上下文窗口。