Claude Fable 5.2发布:编码登顶、降价20%、30小时证费马大定理

Anthropic 发布同模型双版本 Fable/Methas 5.2,编码登顶、降价 20%、宣称完成费马大定理形式化。
Anthropic 无预告发布旗舰模型 Claude Fable 5.2 与 Methas 5.2,官方称其为迄今最强大模型。两者实为同一底座的两个发布端口:Fable 面向网络安全与生命科学场景加装安全护栏,Methas 则向通过申请的安全研究者全能力开放。性能上,Frontier Code 拿下 49.1%、智能体编码 Frontier SWE 达 69.9%,两项均为第一并超越 Opus 5.5。定价反直觉地下调 20% 至输入 8 美元、输出 40 美元每百万 Token,输出速度提升 30%,另有 2.5 倍加速的快速模式。科研方面宣称 30 小时完成费马大定理形式化证明并解决两个黑洞物理开放问题,但仅有官方单一来源,待独立复现。官方建议日常任务仍用 Opus 5.5,高难度任务再切换 Fable/Methas。
Anthropic 在凌晨突然官宣旗舰双版本 Claude Fable 5.2 与 Methas 5.2,官方称其为"迄今最强大模型"。这场发布没有预告、没有预热直播,却一次性抛出性能、价格、科研战绩三记重拳。
同一个模型,两道护栏
Fable 5.2 与 Methas 5.2 并非两个独立训练的模型,而是同一底座的两个发布端口。据 B 站快讯披露,Fable 版本针对网络安全与生命科学场景加装了护栏,限制高风险能力的调用;Methas 则向安全研究者全能力开放,需通过申请。
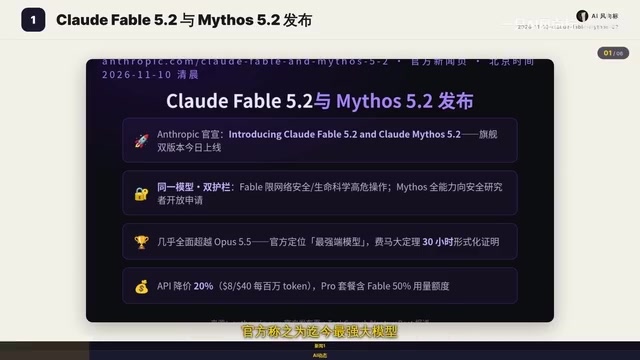
这种"一模型双出口"的做法在业内并不常见。它意味着 Anthropic 在能力释放上采取分层策略:普通用户拿到的是被约束的版本,专业安全研究者则能接触完整能力。护栏本身不改变模型权重,改变的是可触达的行为边界。
护栏(Guardrails)的技术定位:模型护栏是部署在模型输入输出两侧或推理过程中的约束机制,常见形式包括分类器过滤、系统提示词限制、拒答策略与能力开关。它不修改模型权重,因此"同一底座、不同出口"在技术上完全可行——同一份参数可以通过不同的策略层与访问控制,呈现为能力边界不同的两个产品。这种分层发布既满足监管与安全承诺,又能向经过审核的研究者释放完整能力,是前沿实验室在"能力开放"与"风险控制"之间常用的折中方案。
编码基准全面登顶
性能方面的数字相当直接。Frontier Code 编码基准拿下 49.1%,智能体编码 Frontier SWE 达到 69.9%,两项均为全场第一,且几乎全面超越此前的 Opus 5.5。
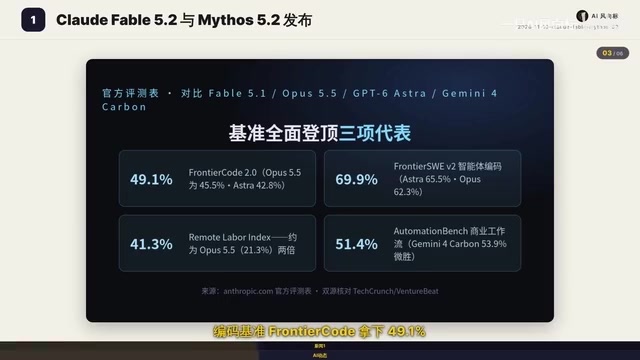
智能体编码(agentic coding)衡量的不是单轮补全,而是模型在多步骤任务中自主规划、调用工具、修正错误的能力。Frontier SWE 69.9% 这一成绩说明 Fable 5.2 在真实工程任务链条上的稳定性有明显提升。对依赖 AI 编程助手的开发者来说,这类指标的参考价值高于传统代码补全基准。
Frontier Code 与 Frontier SWE 的区别:Frontier Code 是面向单文件或短上下文的代码生成基准,主要衡量模型在给定函数签名与注释下产出正确补全的能力,接近传统的 HumanEval / MBPP 类评测。Frontier SWE 则模拟真实软件工程流程——给模型一个 GitHub issue,要求它在整个代码库中定位问题、修改多个文件、运行测试并迭代修复,最终以测试通过率为判定标准。后者的难度来自长上下文理解、工具调用与多轮自我纠错,因此 69.9% 的分数比 49.1% 更能反映模型在"智能体化"工作流中的实战价值。
性能上去了,价格反而降了
定价策略是这次发布最反直觉的部分。每百万 Token 输入 8 美元、输出 40 美元,相比上一代下调 20%;输出速度比上一代快 30%,另有一个加速达 2.5 倍的快速模式。
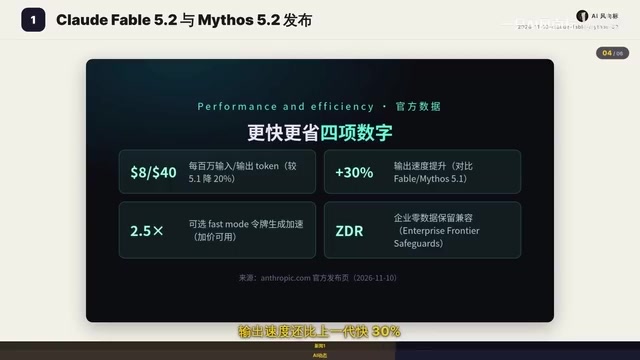
能力更强、价格更低、速度更快,三者同时发生通常意味着推理效率的实质性优化,而非单纯的补贴换市场。对成本敏感的团队来说,这会直接改变"用哪个模型跑生产任务"的决策。
Token 计价的含义:大模型 API 通常按输入 Token(提示词与上下文)和输出 Token(模型生成内容)分别计价,百万 Token 是行业通用单位。输入价格低、输出价格高是常见结构,因为自回归生成每一 Token 都要完整前向计算,而输入可通过并行预填充高效处理。8 美元/40 美元的输入输出比约为 1:5,处于当前旗舰模型的中档水平。所谓"快速模式 2.5 倍加速"一般指推理侧采用更激进的批处理或投机解码,代价是单位 Token 成本上升,适合对延迟敏感而非对成本敏感的交互场景。
30 小时完成费马大定理形式化证明
科研战绩是本次发布最具话题性的部分。据快讯,预发布测试中模型在 30 小时内完成了费马大定理的形式化证明,还解决了两个开放的黑洞物理问题。
形式化证明要求每一步推理都能被证明助手机械验证,与"写出看起来正确的证明"是两件事,难度不可同日而语。不过需要说明,上述战绩目前仅有官方侧单一信息源披露,尚待独立复现与同行评议确认。
什么是形式化证明:形式化证明是把数学命题与推理步骤翻译成机器可逐行检查的形式语言(如 Lean、Coq、Isabelle),由证明助手逐步验证每个推理是否符合公理与已证定理。与自然语言证明不同,它不允许"显然""同理可证"这类跳跃,任何一步缺失都会导致验证失败。费马大定理的形式化是数学界公认的巨型工程,人类团队在 Lean 中推进相关工作耗时数年。若模型能在 30 小时内完成,意味着它同时具备长程规划、引理库检索与严格语法生成能力——但这与"理解证明思想"仍是两回事,且需独立复现才能确认真实性。
官方建议:日常用 Opus,硬骨头再向上切
Anthropic 给出的使用建议是:日常任务继续用 Opus 5.5,遇到硬骨头再向上切换 Fable 或 Methas。
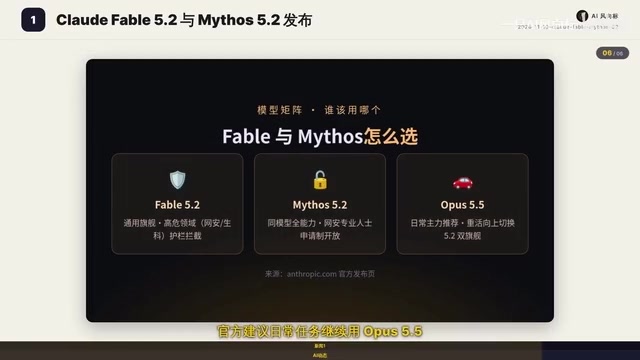
这条建议本身就说明了产品定位——Fable 5.2 不是 Opus 5.5 的全面替代品,而是能力上限更高的"攻坚档"。Opus 5.5 在常规任务上成本更优、延迟更低,Fable 则用于处理复杂推理、长链条工程和科研级问题。分层调用比盲目升级更划算。
Pro 套餐用户现在已可使用 Fable。对开发者而言,值得关注的不是"要不要换模型",而是如何把任务难度分级,让合适的模型处理合适的活。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。