Claude Fable 5.2发布:跑分碾压Opus 5.5,成本仅一半

Anthropic 发布 Fable 5.2 与 Methos 5.2,跑分压制 Opus 5.5 且成本更低,但权限窗口仅一周。
Anthropic 于 11 月 10 日发布 Claude Fable 5.2 与 Methos 5.2,定位为攻克最困难任务。Fable 5.2 在 Artificial Analysis 智能指数榜包揽前三,Max 推理强度得分 65 居首,输出速度最高提升 30%;在 Frontier Code 2.0 中用 High 强度即可比肩 Opus 5.5 的 Max 强度,每任务成本仅一半,API 价格下降约 20%。实战案例包括 1000 个智能体 30 小时完成费马大定理的 Lean 形式化、Methos 5.2 准确预测 34 个衣壳中的 28 个结构,以及机器人控制超越多数专用系统。官方建议日常任务仍用 Opus 5.5,Fable 5.2 面向高难度开放任务;Pro 与 Team 标准套餐权限仅一周,重置卡有严格领取与过期时限。
Anthropic 在 11 月 10 日抛出重磅更新:Claude Fable 5.2 与 Methos 5.2 正式发布。官方将其定位为「专为最困难任务打造」,从编程、推理到视觉理解全面升级,并在多个基准测试中压过了此前的旗舰 Opus 5.5。
跑分与成本:Fable 5.2 的全面压制
据 B 站 UP 主「11 月 10 日 AI 资讯」的梳理,Fable 5.2 在几乎所有评测能力上都超过了 Opus 5.5。在 Artificial Analysis 智能指数榜上,Fable 5.2 包揽前三,其中 Max 推理强度得分 65 位列第一。输出速度相比 Fable 5.1 和 Methos 5.1 最高提升 30%。
更关键的是性价比。在 Frontier Code 2.0 早期测试中,Fable 5.2 用 High 推理强度的得分就与 Opus 5.5 的 Max 推理强度大致相当,而每任务成本只有后者的一半。来源给出的 API 定价为:每百万输入 8 美元、输出 40 美元,上一代 5.1 分别为 10 美元和 50 美元——降幅约 20%。
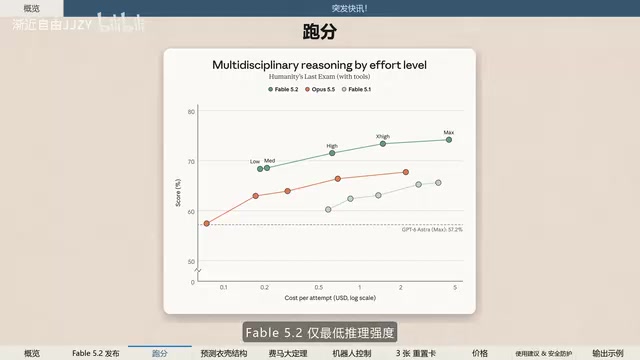
在 Humanity's Last Exam 推理测试中,Fable 5.2 仅用最低推理强度就超越了 Opus 5.5 的最高推理强度。这意味着用户不必把推理预算拉满,就能获得更强的结果。
推理强度(Reasoning Effort) 是当前推理模型普遍采用的一个可调参数,用来控制模型在生成答案前进行「内部思考」的预算。常见的档位包括 Minimal、Low、Medium、High、Max,档位越高,模型消耗的推理 token 越多,通常准确率越高但延迟和成本也随之上升。它在工程上的意义在于把「能力」与「开销」解耦:同一个模型可以在简单任务上低档快速响应,在困难任务上拉满档位换取精度。因此,比较两个模型时只看某一档位的分数并不公平,需要对照「同等成本」或「同等延迟」下的表现。文中 Fable 5.2 用 High 档比肩 Opus 5.5 的 Max 档,正是说明其单位推理预算的效率更高。
不止于跑分:从数学证明到蛋白质结构预测
Fable 5.2 的价值不止体现在榜单数字上,来源给出了几个更具说服力的实战案例。
千体智能体攻克费马大定理形式化。 由 1000 个 Fable 5.2 智能体组成的团队,在 30 小时内完成了费马大定理的完整 Lean 形式化。相同配置下,Opus 5.5 在 18 小时内只完成 26%,到 30 小时时也几乎没有更多进展。这种长时程、多智能体协作场景,恰好放大了 Fable 5.2 在持续推理上的优势。
Methos 5.2 预测蛋白质外壳结构。 基因疗法可通过一种称为「一壳」(衣壳)的蛋白质外壳来递送。Methos 5.2 找到了一种预测完整衣壳结构的新方法:在 Anthropic 的测试中,它尝试对 34 个衣壳建模,其中 28 个结构预测准确。生物学家可以借此更快、更低成本地设计衣壳。
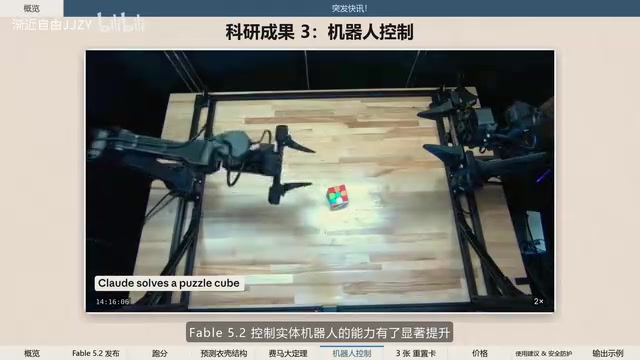
机器人控制能力显著提升。 Fable 5.2 控制实体机器人的能力有明显进步,即使面对从未专门训练过的任务也能应对。在模拟双臂机器人的 RoboDojo 基准测试中,它的表现超过了其他模型以及大多数专为控制机器人打造的 AI 系统。
Lean 形式化 指使用交互式定理证明器 Lean 及其数学库 Mathlib,把自然语言写成的数学命题与证明改写成计算机可逐步校验的形式代码。形式化后的证明由内核逐条检查,只要通过就不存在逻辑漏洞,因此被视为数学严谨性的最高标准之一。费马大定理的形式化工作量极大,涉及模形式、椭圆曲线、伽罗瓦表示等大量现代数论内容,长期是形式化社区的目标。这类任务的特点是步骤极多、单步不能出错、且需要长时间保持上下文一致,恰好考验模型的长时程推理与自我纠错能力。多个智能体并行分工可以拆解子目标,但如何协调接口与依赖关系本身也是难点。
衣壳(Capsid) 是包裹病毒遗传物质的蛋白质外壳,由多个相同或不同的蛋白亚基按一定对称性自组装而成,常见的有二十面体对称结构。在基因治疗中,改造后的病毒衣壳(如 AAV 衣壳)被用作递送载体,把治疗性基因送入目标细胞,因此衣壳的结构与表面特征直接决定了递送效率、组织靶向性和免疫原性。实验测定衣壳结构通常依赖冷冻电镜,成本高、周期长;而仅凭氨基酸序列预测完整组装体的三维结构,比预测单条蛋白链困难得多,因为还要处理亚基间的装配关系与柔性区域。若能较准确预测,就能大幅加速载体设计中的筛选与改造。
使用权限与重置卡:注意时间窗口
发布福利背后有明确的时间限制。Pro 和 Team 标准套餐的 Fable 5.2 使用权限只有一周,截至 11 月 17 日;只有 Max、Ultra 和 Team 高级套餐会永久保留每周 50% 的使用额度。
为庆祝发布,Anthropic 最多发放三张重置卡,但仅限北京时间 11 月 10 日凌晨 1 点前订阅 Claude 的用户领取。Pro 和 Team 标准套餐获得一张;Max、Ultra 或 Team 高级套餐按订阅时长动态获得对应数量,最多三张。重置卡将于明年 3 月 8 日过期。

所有 Claude 付费套餐用户均可使用 Fable 5.2,并已在 Claude Platform 和各大主流云平台上线 API。
该用哪个?Fable 5.2 与 Opus 5.5 的定位分野
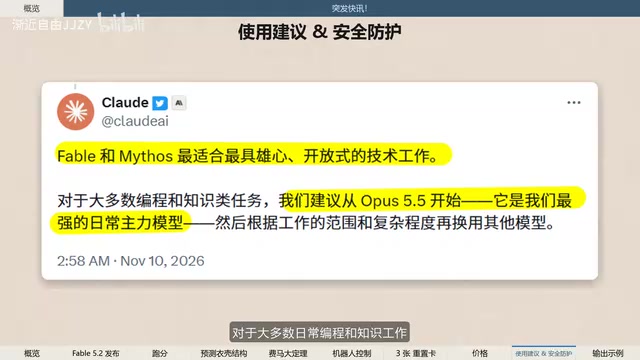
来源给出的建议很明确:新模型更适合难度较高、目标开放的技术工作,比如复杂编程、前沿推理与科研辅助;对于大多数日常编程和知识工作,仍建议使用 Opus 5.5,因为它已是最强的日常通用模型。
Fable 和 Methos 基于同一个底层模型,但 Fable 配备了严格的安全防护以防滥用。从事网络安全或生物医学研究、并致力于推动有益应用的组织,可通过生命科学验证和网络安全验证计划申请使用 Methos。
一个值得参考的实际体验是:UP 主用 Fable 5.2 配合几个 Opus 5.5 子代理,大约 30 分钟完成了任务。这种「强推理主模型 + 通用子代理」的混搭方式,可能比单一模型堆推理强度更划算。
总体来看,Fable 5.2 的发布延续了「能力更强、单价更低」的路线,但一周短窗权限和重置卡领取截止时间,都意味着想尝鲜的用户需要尽快行动。
主模型 + 子代理(sub-agent) 的分层编排是当前智能体系统的一种常见架构:由一个能力最强、负责规划与决策的模型拆解任务,再把相对独立、边界清晰的子任务分派给成本更低或更专精的模型执行,最后回收结果进行整合。这种设计的好处是把昂贵的高强度推理集中在关键节点,避免所有 token 都按最高单价计费,同时并行子代理还能缩短整体耗时。代价是引入了上下文传递、结果校验与错误传播等协调开销,任务拆分的粒度是否合理会显著影响最终效果。文中三十分钟完成任务的经验,说明在合适的分工下混搭可能比单一模型拉满推理强度更经济。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。