CLAUDE.md三条黄金法则:别让AI越读越笨

CLAUDE.md 应精简为行为约束,用删除测试、精确命令和渐进式披露三条法则控制上下文成本。
文章针对开发者把项目 README 直接塞进 CLAUDE.md 的常见做法提出批评,指出这会挤占上下文窗口、稀释模型注意力,反而让 AI 助手表现变差。作者引用 DevDeck 视频提出的三条黄金法则:删除测试要求删掉“删了也不会让 AI 犯错”的指令;精确命令要求只写测试与构建命令而非解释应用功能;渐进式披露要求用一行指针代替整段 schema,并把根文件控制在 50 行以内。三条法则构成清理存量、控制密度、管理增量的闭环,共同目标是让规则文件保持精简、可执行、可维护。
很多开发者习惯把项目 README 原封不动塞进 CLAUDE.md,以为给 AI 的上下文越多越好。YouTube 频道 DevDeck 在一条短视频里直接点破了这个误区:把几百行的说明文档倒进规则文件,只会烧掉上下文窗口,反而让 AI 助手变笨。
视频给出的三条黄金法则,来自资深工程师的实践。核心逻辑很简单——CLAUDE.md 不是项目文档,而是给 AI 的行为约束。
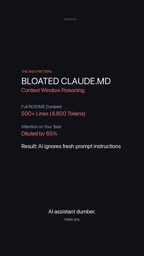
法则一:删除测试
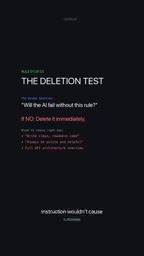
第一条法则是「删除测试」:如果删掉某条指令后,在一个全新的提示(fresh prompt)下 AI 不会因此犯错误,那就立刻删掉它。
这个判断标准非常锋利。它把「这条规则有没有用」从主观感受变成了可验证的实验。很多规则文件之所以膨胀,是因为开发者把「以防万一」写进了文件——担心 AI 不知道某个约定、某个背景、某个历史决策。但删除测试逼你回答一个问题:没有这条,AI 真的会出错吗?如果答案是否定的,它就是在占用宝贵的上下文预算。
有意思的是,这条法则暗含一个前提:上下文窗口是有限资源。每多一条无关指令,模型分配给真正重要信息的注意力就被稀释一分。这也是视频开头那句「让 AI 助手变笨」的实际含义——不是模型能力下降,而是有效信息被噪声淹没。
法则二:只写精确命令
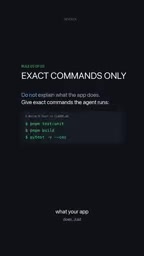
第二条法则要求「只写精确命令」:不要解释你的应用是做什么的,直接列出确切的测试和构建命令,比如 pnpm test 或 pytest。
这条规则直指 CLAUDE.md 的定位问题。项目是做什么的,AI 读代码就能推断;但仓库用哪个包管理器、测试怎么跑、构建脚本叫什么,这些信息从代码里不一定能可靠推出,写清楚才有价值。换句话说,规则文件应该承载「AI 无法从代码中自行发现、又必须知道」的信息。
把大段的应用说明换成几行命令,既减少了 token 消耗,也降低了 AI 误解项目的风险——过时的功能描述比没有描述更危险。
上下文窗口(Context Window) 是理解全文的关键前提。它指大语言模型单次推理时能接收的最大 token 数量,涵盖系统提示、规则文件、对话历史、代码片段与工具返回结果。Claude 等模型的上下文窗口通常以 200K token 为量级,看似宽裕,但实际使用中会被多轮对话和文件读取迅速蚕食,且存在「中间遗忘」现象——位于长上下文中部的内容更容易被模型忽略。因此,规则文件占用越多 token,留给真正任务相关信息的预算就越少,“让 AI 变笨”正是有效信号被噪声稀释的结果。
法则三:渐进式披露
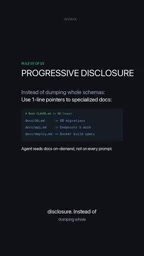
第三条法则是「渐进式披露」:与其把整个数据库 schema 倒进去,不如写一行指向专门文档的指针。
这个思路和软件设计里的懒加载如出一辙。根规则文件只保留索引,具体细节放到独立文档里,AI 需要时再去读取。这样既控制了根文件的体积,又保留了深度信息的可及性。视频给出的建议是,把根规则文件控制在 50 行以内。
50 行这个数字本身不是硬指标,但它提供了一个有用的心理锚点:当你发现规则文件接近或超过这个量级,就该重新做一遍删除测试了。
渐进式披露(Progressive Disclosure) 源自交互设计与技术文档写作,核心是“按需呈现”:先给出最小必要信息与索引,用户或系统在需要时再逐层展开细节。在 AI 编程助手中,这意味着根规则文件只写“数据库 schema 见 docs/schema.md”这类指针,模型在相关任务出现时再读取该文件。与之配合的另一机制是 Agent Skills——把特定领域的操作流程封装成可被模型按需加载的独立文件,使上下文占用与实际需求匹配,而非一次性全量注入。
为什么这三条法则值得认真对待
DevDeck 的这条视频之所以引发共鸣,是因为它把 AI 工程里一个容易被忽视的成本显性化了:上下文不是免费的。每一条指令都在和代码、对话历史、工具输出争夺模型的注意力预算。
三条法则其实构成一个闭环:删除测试负责清理存量,精确命令负责控制信息密度,渐进式披露负责管理增量。三者共同指向同一个目标——让 CLAUDE.md 保持精简、可执行、可维护。
视频结尾抛出的问题也值得每个开发者自查:你的规则文件现在有多少行?如果答案让你犹豫,或许该从删除测试开始,给规则文件做一次减法。
注意力预算(Attention Budget) 并非严格的技术术语,而是对 Transformer 注意力机制实际表现的通俗概括。模型对上下文中的每个 token 都要计算注意力权重,无关内容会分摊本应集中于关键指令的权重,导致对关键约束的遵循度下降。研究表明,当上下文中混入大量与任务无关的指令时,模型对目标指令的召回率会显著降低。这解释了为何精简规则文件往往比堆砌信息更有效——减少干扰项本身就能提升指令遵循的稳定性。
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。