Claude Opus 5.5发布:成AINews默认模型,全行业降价40%-50%
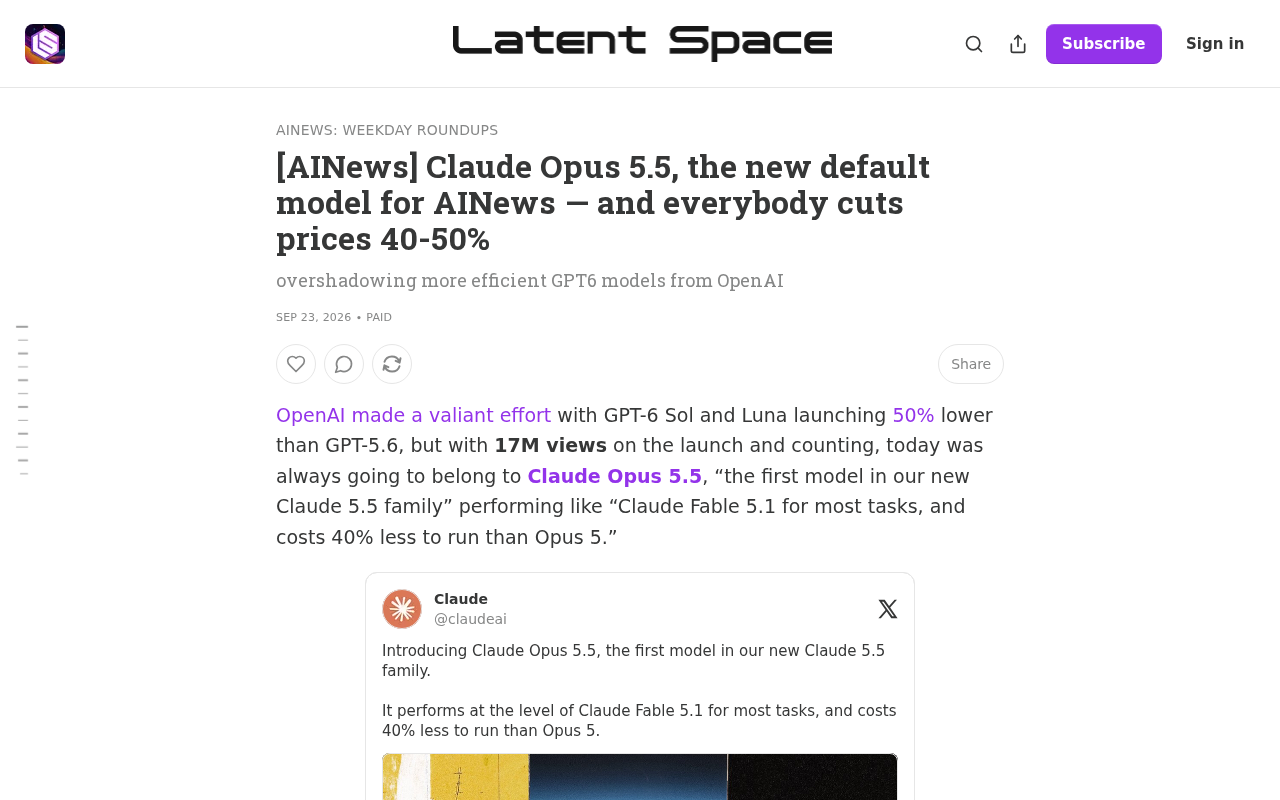
Claude Opus 5.5成新默认模型,行业集体降价40%-50%,大模型竞争全面提速。
Anthropic发布Claude Opus 5.5并被AINews设为默认模型,同期全行业掀起40%-50%幅度的集体降价潮,标志着大模型市场进入能力与价格双重竞争的新阶段。默认模型的切换反映了Opus 5.5在性价比与综合能力上已达到可规模化部署的成熟度。此次降价源于推理成本持续下降与厂商争夺开发者生态的双重驱动,客观上将旗舰模型的使用门槛大幅拉低。OpenAI主打效率路线的GPT6系列在声量上被盖过,折射出当前市场对综合能力的偏好,但效率型模型在批量高频任务中的成本优势仍不可忽视。对开发者与企业用户而言,这是重新评估模型选型、以真实场景做基准测试的关键窗口期。
Claude Opus 5.5登场,重塑默认模型格局
Anthropic推出的Claude Opus 5.5正在成为AINews的新默认模型,这一变化标志着大模型竞争格局的又一次洗牌。作为Opus系列的迭代版本,5.5在综合能力上被视为足以承担高频、复杂任务的主力选择,而非仅用于边缘场景的实验模型。
对于依赖大模型进行内容处理、推理与自动化的产品团队而言,"默认模型"的切换并不是一个轻描淡写的决定。它意味着在成本、稳定性与输出质量之间取得了新的平衡点。AINews将其设为默认,说明在实际的高负载工作流中,Opus 5.5的表现已经获得了信任票。
为什么"默认模型"的选择很关键
默认模型决定了绝大多数请求实际运行在哪个模型上。它直接影响单位调用成本、延迟表现以及最终产出的一致性。当一个信息聚合类产品选择将某个模型设为默认,往往意味着该模型在性价比曲线上占据了当前最优位置——既要足够聪明,又不能贵到难以规模化使用。
在技术实现层面,"默认模型"通常指在API调用或产品配置中未显式指定模型时系统自动路由的目标。对于AINews这类每天需要处理海量文章摘要、分类与生成的信息产品,默认模型承载着80%以上的实际调用量。这意味着模型的上下文窗口大小直接决定能否一次性处理长文,输出稳定性决定下游解析流程的容错率,而每百万token的单价则直接影响月度运营成本。以当前主流旗舰模型的定价区间来看,同等工作量下选择不同默认模型,月成本差异可以达到数倍。正因如此,默认模型的每一次切换背后都是经过量化评估的工程决策,而非单纯的技术偏好。
全行业降价40%-50%,价格战全面开打
伴随Opus 5.5的发布,市场出现了一个更引人注目的信号:各家厂商纷纷将价格下调40%到50%。这种幅度的集体降价并不常见,通常反映出两种同时发生的力量——底层推理成本的持续下降,以及厂商之间为争夺开发者与企业用户的激烈竞争。
对使用者来说,这是明确的利好。同样的预算下,可以调用更强的模型、处理更大的上下文、支撑更高的并发。原本因成本考量而被迫使用轻量模型的场景,现在有条件升级到旗舰级模型。价格的下探往往会释放出此前被压抑的需求。
降价背后的竞争逻辑
价格调整从来不是孤立行为。当一家头部厂商推出更强的新模型并调整定价,其余厂商几乎必须跟进,否则将在性价比对比中处于劣势。40%-50%的降幅横扫多家供应商,本质上是一场围绕开发者心智与调用量的争夺战。谁能在"更强、更便宜"的组合上抢先一步,谁就更有机会锁定长期的使用惯性。
从供给侧来看,大模型推理成本下降的核心驱动力包括:专用推理芯片(如Nvidia H系列及各家自研TPU/NPU)的算力密度持续提升、KV Cache等推理优化技术的普及、以及模型量化与蒸馏技术使得在不显著损失效果的前提下大幅压缩推理开销成为可能。以过去两年的行业数据来看,每百万token的推理成本年均降幅超过50%,这为厂商提供了压低对外售价的底气。与此同时,开发者生态具有强路径依赖性——一旦某个模型的SDK、提示词模板和评估流程在企业内部沉淀,迁移成本相当高。因此厂商愿意在价格上提前让利,以期在生态锁定期到来之前赢得更多的存量调用份额。
OpenAI的GPT6效率模型被抢了风头
值得关注的一点分歧在于市场焦点的转移。据原始信息显示,Opus 5.5的发布在一定程度上盖过了OpenAI更注重效率的GPT6系列模型的声量。这是一个有趣的对比:一方主打综合能力的旗舰形象,另一方强调效率与成本优化。
效率型模型的价值在于以更低的资源消耗完成大量常规任务,这在大规模部署时意义重大。但从舆论关注度来看,能力更全面、定位更高端的模型往往更容易占据话题中心。GPT6的效率路线是否会在实际使用中赢回份额,仍需要观察真实工作负载下的数据表现,而非仅凭首发声量判断。
能力优先还是效率优先
这场对比揭示了当前大模型市场的一条主线分歧:厂商究竟应该追求更强的单点能力,还是更极致的成本效率?现实中两者并不完全对立——降价潮本身就在拉近两条路线的差距。当旗舰模型也变得足够便宜,效率型模型的差异化优势就会被压缩。这也是为什么此次全行业降价与旗舰模型发布同时发生,格外具有信号意义。
效率型模型(也常被称为"小模型"或"推理优化模型")的核心设计目标是在参数量或计算量受限的前提下,最大化特定任务的性价比。常见技术路径包括知识蒸馏(将大模型的能力迁移到小模型)、稀疏激活(MoE架构只激活部分专家网络)以及任务特化微调。GPT6效率系列的定位与OpenAI此前的GPT-4o mini思路一脉相承:用更低延迟、更低单价覆盖分类、摘要、代码补全等标准化程度高的场景。然而当旗舰模型的价格也快速下探时,效率型模型需要重新证明自己的差异化价值——通常体现在极低延迟的实时交互场景,或对成本极度敏感的超大规模批处理任务中,而非通用场景的综合对比。
对开发者与企业用户的实际影响
把这些变化落到实处,几个方向值得关注:
- 重新评估默认模型选择:如果此前因成本而采用较弱模型,现在有必要重新测算切换到旗舰模型的投入产出比。
- 关注跨厂商比价:降价幅度接近的情况下,实际差异会体现在具体任务表现、上下文窗口和稳定性上,建议以自己的真实场景做基准测试。
- 警惕单一舆论热度:GPT6被盖过风头不代表其不适合特定场景,效率型模型在高频批量任务中可能反而更划算。
整体而言,模型能力提升与价格下探同步发生,对使用方是难得的窗口期。在这个阶段做好选型与压测,往往能在成本和效果上同时受益。
相关推荐
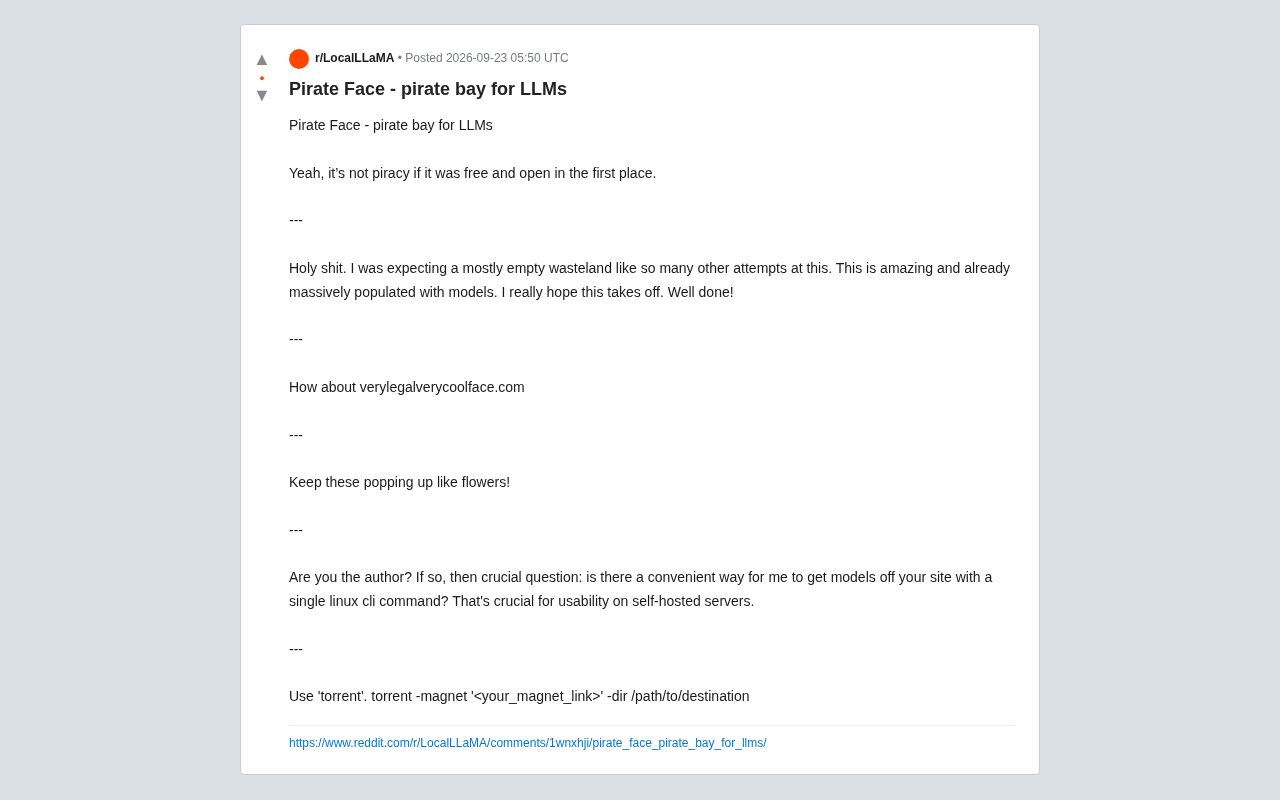
Pirate Face:为开源大模型打造的"海盗湾"式分发平台
Pirate Face 是一个类似海盗湾的开源大模型去中心化分发平台,基于磁力链接和 P2P 技术共享免费开放模型,支持命令行下载,适合自托管部署场景。本文解析其定位、社区反响与技术逻辑。
让AI自画像:Muse的自我形象呈现实验
一位Reddit用户要求AI工具Muse渲染出"自己"的形象,并在表达恐惧后让AI生成了更友好的机器人版本。本文解析这场趣味实验背后的AI情绪反馈与图像生成机制。
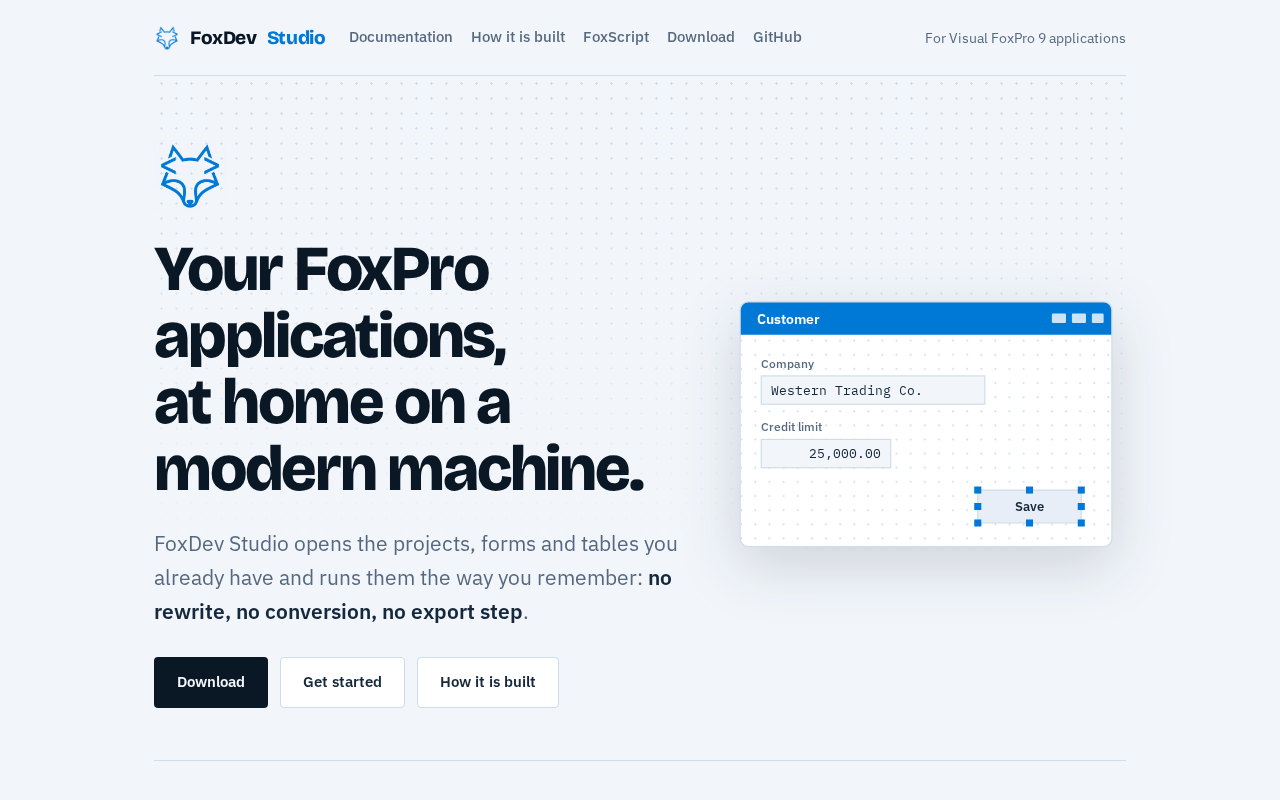
微软已弃用的FoxPro复活:Rust重写编译为WASM
微软2007年已停止更新Visual FoxPro,但一个开源项目用Rust重写运行时并编译为WASM,让这门旧语言复活。它对照原版vfp9.exe校验,突破2GB表限制,兼容旧版32位.fll插件,并新增lambda、JSON和HTTP服务器。