Claude Sonnet 5.5 报错事件:从故障看AI服务稳定性

Claude Sonnet 5.5 出现短暂错误率升高,官方不到一小时完成修复,提醒开发者重视服务韧性。
文章基于官方状态页 RSS 推送,回顾了 Claude Sonnet 5.5 一次请求错误率升高的服务事件:09:14 UTC 启动调查,09:38 UTC 部署修复并进入监控,09:56 UTC 标记解决,全程不到一小时。作者认为这次响应节奏值得肯定——监控先行、定位果断、收尾留出观察窗口,未出现过早宣布恢复的尴尬。但状态页仅说明问题已解决,未披露根因,外部开发者难以针对性调整容错策略。由此文章提出三点开发者启示:把重试与降级作为标配、通过状态页 RSS 建立低成本预警、在可观测体系中区分暂时性错误与持续性故障。最终结论是:AI 服务稳定性是算力、网关、限流、鉴权等多环节的复合命题,工程韧性仍是产品可靠性的底座。
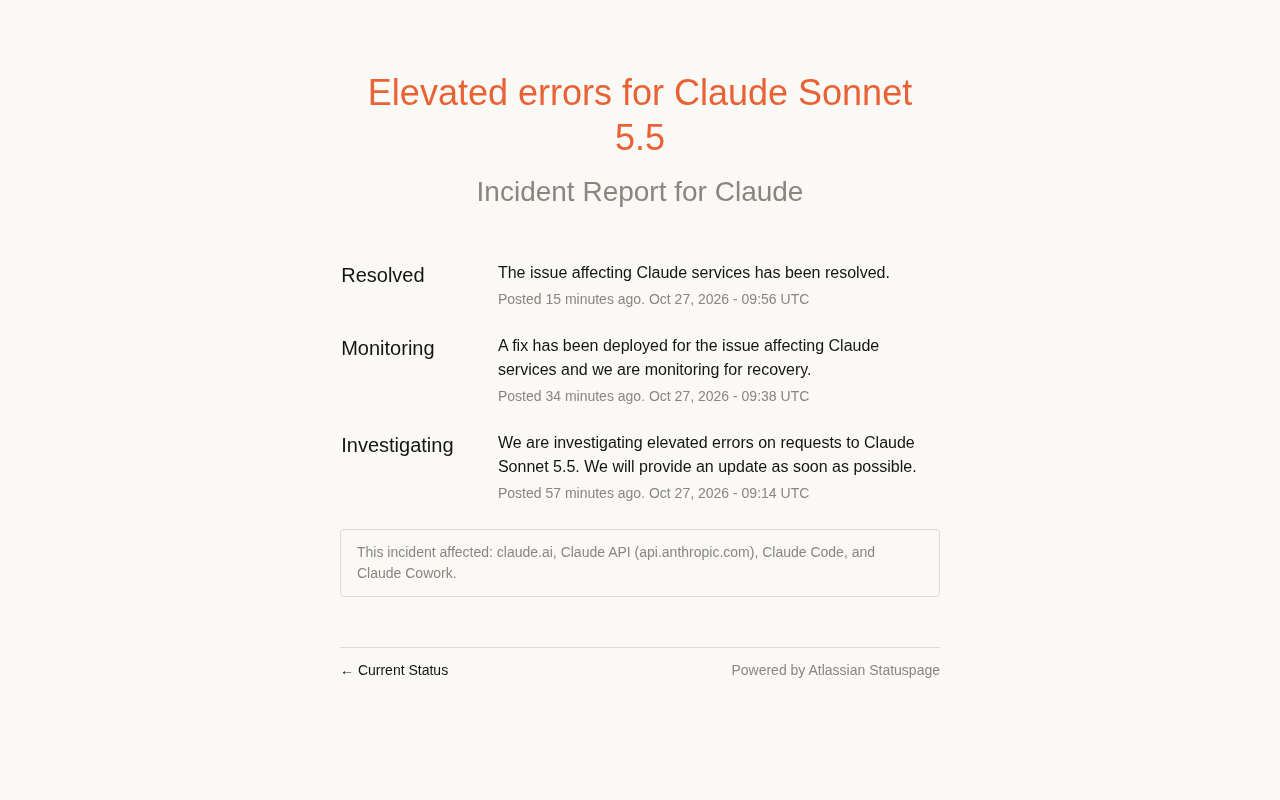
事件回顾:Claude Sonnet 5.5 遭遇短暂服务波动
根据官方状态页的 RSS 推送,Claude Sonnet 5.5 在近日出现了一次请求错误率升高的服务事件。状态页的时间线清晰记录了完整的处理过程:09:14 UTC 团队开始调查“elevated errors on requests to Claude Sonnet 5.5”;09:38 UTC 修复方案已部署,进入监控恢复阶段;09:56 UTC 问题被标记为已解决。
从开始调查到确认解决,整个过程不到一小时。对于依赖大模型 API 的开发者来说,这种级别的短暂波动并不罕见,但它再次提醒我们:再成熟的 AI 服务,也仍然运行在需要持续运维的工程系统之上。
故障时间线拆解:响应速度说明了什么
把这三个时间点放在一起看,能读出一些值得关注的信息。
调查启动快。09:14 就已公开确认问题存在,说明监控告警系统在用户大规模反馈之前就捕捉到了异常指标。对于 API 类产品,错误率的实时监控是基本功,这次响应没有出现“用户先炸、官方后知”的滞后。
修复部署果断。24 分钟后即进入监控阶段,意味着团队定位到了根因并推送了修复,而不是在排查中反复试错。这个节奏在同类服务的事故处理中属于较高效的水平。
收尾克制。09:56 才宣布解决,中间留出了十几分钟的观察窗口来确认恢复稳定,没有在部署完成后立刻“庆祝胜利”。这种谨慎值得肯定——过早宣布恢复、随后问题复现,是运维事故中最尴尬的情形。
值得一提的是,状态页的措辞相当克制:只说明“影响 Claude 服务的问题已解决”,并未披露具体是模型推理层、网关层还是配额系统出了问题。对于外部开发者而言,缺少根因说明意味着难以针对性地调整自己的容错策略。
对开发者的启示:把“服务会挂”当作默认假设
这次事件本身并不严重,但它提供了一个重新审视架构韧性的契机。
重试与降级要成标配
既然请求错误率会短时间内升高,客户端就必须具备指数退避重试机制。更关键的是降级路径:当主力模型不可用时,系统能否自动切换到备用模型或返回缓存结果?把 Sonnet 5.5 写死在代码里、没有任何 fallback 的设计,在真实生产环境中是脆弱的。
指数退避重试是一种在请求失败后按逐渐增大的间隔重复尝试的策略,而不是以固定频率立即重发。常见实现是第 n 次重试等待约 base × 2^n 的时间,并叠加随机抖动(jitter),避免大量客户端在同一时刻同步重试造成“惊群”式的二次冲击。对于大模型 API,还需区分可重试错误(429 限流、500/503 等 5xx、连接超时)与不可重试错误(400 参数错误、401 鉴权失败)。重试次数应设上限并配合总超时预算,否则在持续故障期间会放大延迟与成本。
降级(fallback) 指的是主路径不可用时切换到预设的备选方案,例如改调备用模型、降低参数规模、返回缓存或历史结果、或向用户展示明确的服务繁忙提示。降级设计的关键是提前定义好触发条件与降级层级,并在非故障期做演练验证,因为临时拼凑的 fallback 往往在真正出事时才发现接口不兼容或输出格式不一致。
监控官方状态页
状态页 RSS 是成本极低的预警渠道。把状态页的更新接入团队的告警系统,可以在官方发布“Investigating”时就让值班同学知晓,而不是等到用户投诉才反应过来。这类信息源的接入工作量很小,收益却很直接。
状态页 RSS 是服务商发布事件时间线(Investigating / Identified / Monitoring / Resolved 等状态阶段)的标准化订阅源,通常无需鉴权即可轮询获取。相比人工刷网页,把它接入告警系统(如定时抓取、变更即触发通知)能把“官方确认异常”的信号转化为团队可处理的事件。需要注意两点局限:状态页发布时间通常晚于真实故障发生时间,且措辞可能较模糊、不披露根因,因此它更适合作为辅助信号,而非唯一的可用性判据。更稳妥的做法是把自建的黑盒探测(定时发起真实请求并统计错误率与延迟)与状态页信号交叉验证。
区分“暂时性错误”与“持续性故障”
短时错误率升高与长时间宕机的应对策略不同。前者适合重试加退避,后者需要快速切流并对外沟通。开发者需要在自己的可观测体系中把这两类情况区分开,避免用同一种告警噪音淹没真正的严重问题。
从单次事件看AI服务的运维成熟度
大模型服务的稳定性是个复合命题:它既取决于底层算力与推理集群的健康度,也取决于 API 网关、限流系统、鉴权链路等外围组件的可靠性。一次不到一小时的波动,暴露的往往是某个环节的瞬时过载或配置失误,而不是整体架构的崩塌。
对 Anthropic 而言,公开透明的状态页更新是建立信任的方式;对开发者而言,把服务商的状态页纳入自己的运维视野,同时保持对“任何外部依赖都可能失效”的清醒认知,才是更务实的姿态。AI 能力再强,工程韧性依然是产品可靠性的底座。
相关推荐
WebMCP安全指南:三个注解让AI代理更安全
Chrome团队演示WebMCP工具的三种安全注解:readOnlyHint消除无效确认弹窗,consequentialHint强制高危操作人工确认,untrustedContentHint抵御间接提示注入,一两行代码即可提升AI代理安全性。

湍流为何是流体力学最难问题?AI或成破局关键
湍流为何是流体力学最难问题?本文基于Lex Fridman播客对话,解析湍流的多尺度本质、经典物理热力学的对比,以及AI通过发现坐标变换来简化湍流描述的可能性,探讨涡旋形成与数学物理的交汇。

R.L. Stine谷歌访谈:恐怖大师如何点燃儿童阅读热情
R.L. Stine在谷歌访谈中分享从喜剧转向恐怖的偶然经历、儿童恐怖创作原则、手机对叙事的冲击,以及如何用Goosebumps激发儿童阅读动机。