Claude Sonnet 5.5 发布:更快更省,AI大模型集体上新

Claude Sonnet 5.5提速降本,国产模型Manus/MiMo/可灵密集升级,AI竞争重心转向效率、成本与合规。
本文梳理了同一天内AI行业多条并行动态。模型层面,Anthropic发布Claude Sonnet 5.5,输出速度提升约三成、任务成本最多降三成,主打编程调试与办公自动化场景,显示厂商将「性价比」列为核心竞争维度。国产阵营同步发力:Manus 2.0更换底层框架、Token用量与耗时均下降约三成并新增视频剪辑功能;小米MiMo修复了反复调用工具的「复读」Bug并已开源;可灵4.0宣布支持原生30秒视频生成与多模态参考。产品与合规层面,ChatGPT高价档定价页面与Codex页面口径不一致引发透明度质疑;某平台针对代码上传争议发布补偿公告,承诺默认不上云;Manus团队推出具备真实执行能力的个人AI助理「Q」。整体来看,AI竞争的焦点正从单纯的能力比拼,向效率、成本、合规与执行力全面延伸。
Claude Sonnet 5.5:速度提升三成,成本再降三成
Anthropic 再次更新旗舰模型,这次推出的是 Claude Sonnet 5.5。相比上一代,新版本的输出速度提升约三成,完成相同任务的成本最多可节省三成。这两项改进的组合,对高频调用的开发者和企业用户来说意味着实打实的效率与费用优化。
从定位来看,Sonnet 5.5 主打修复 Bug 和处理办公自动化任务,明显在向编程与生产力场景倾斜。目前该模型已经在 Claude 官方应用及多个第三方平台上线,写代码的用户可以直接体验它在调试环节的表现。
对于依赖大模型做工程化开发的团队而言,速度和成本是绕不开的两条硬指标。Sonnet 5.5 同时在这两方面做出改进,说明厂商正在把「性价比」作为竞争主战场,而非单纯堆参数、拼榜单。
国产模型密集更新:Manus 2.0 与 MiMo 修复
除了 Claude,国产阵营也在同步发力。Manus 发布了 2.0 大版本,这是其恢复独立运营后的首次重大更新。底层框架进行了替换,官方称跑任务时 Token 用量明显减少,耗时缩短近三成。桌面端还新增了视频剪辑和游戏开发环境,目前面向海外用户开放,国内版本正在筹备中。
小米 MiMo 团队则修复了 MiMo V2.6 的一个关键 Bug——此前模型会反复发起相同的工具调用,造成「复读」现象。团队用复读数据训练特化模型,修复后复读率已接近零。新模型已经开源并上线 API,调用名称保持不变,MiMo Desktop 也重置了用量。
可灵 AI 同样官宣了视频生成模型「可灵 4.0」,将于下月正式上线。它支持原生 30 秒视频生成,一次最多接受 15 项多模态参考,还能续拍到 2 分钟。目前已向黑金年卡会员开放抢先体验。这一波更新显示出国产工具在效率优化、开源生态和视频生成三条线上都在快速推进。
「复读」现象(Repetitive Tool Calling)是大语言模型在 Agent 场景下的一类典型故障:模型陷入循环,对同一个工具反复发起相同调用,既消耗 Token 配额,也无法推进任务。这类问题通常源于强化学习阶段的奖励设计缺陷,或模型在处理工具返回结果时缺乏有效的终止判断机制。MiMo 团队的修复思路——收集复读样本、训练特化修复模型——是一种典型的「针对性后训练(targeted post-training)」方法,通过在问题分布上做专项微调来弥补主模型的行为缺陷,而非重新训练整个基座。这种方式的优点是成本可控、效果可验证,在工程实践中正被越来越多的团队采用。
ChatGPT 定价口径不一致引发关注
关于 ChatGPT 每月 100 到 200 美元的高价档位,用户一直关心到底能用多少额度,官方此前没有写清楚。最近官网条款更新,在 Pro 档的升级页面标注了「Unlimited Core Chat」(核心聊天无限制),图像生成也标为无限。
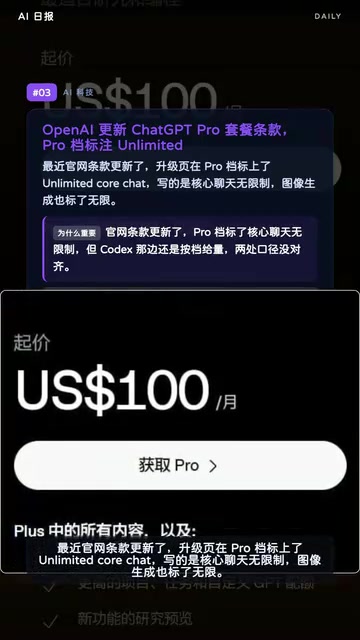
但问题在于,Codex 那边的定价页仍然按档位给出具体额度,与升级页的「无限制」表述并未完全对齐。官方在两处的口径存在差异,实际使用限制仍需以后续官方说明为准。这类信息不透明在高价订阅产品中并不少见,用户在付费前有必要留意条款细节。
数据合规与新应用:补偿公告与 AI 助理
针对此前被质疑的代码上传问题,相关平台发布了补偿公告。官方表示上传记录已移除、云端数据已删除,并承诺以后做到「你不发起就不上云」。同时还赠送了重置卡和 1 亿 Token 额度,活动从 9 月 28 日开始,限量 10 万份。
在数据主权和隐私日益敏感的当下,这种「默认不上云」的承诺切中了开发者的核心顾虑,也反映出厂商在合规压力下的姿态调整。
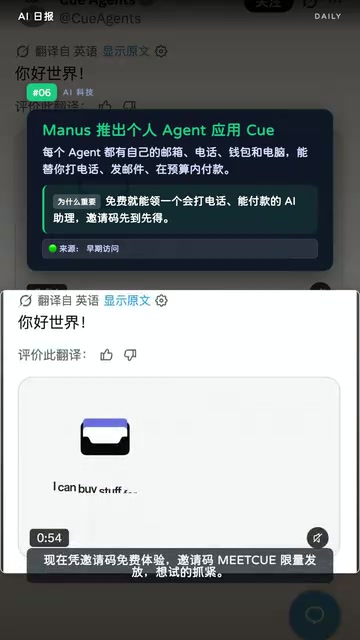
另一边,Manus 团队推出了名为「Q」的个人 AI 助理。每个 agent 都拥有独立的邮箱、电话、钱包和电脑,能替用户打电话、发邮件,并在预算内完成付款。这类具备真实执行能力的 agent 产品,把大模型从「回答问题」推向「代办事务」。目前 Q 凭邀请码免费体验,邀请码限量发放。
「具身 Agent」或「执行型 Agent」(Agentic AI)代表着大模型应用的一个重要演进方向:从被动响应用户提问,转向主动代理用户在真实世界中完成任务。Q 所具备的独立邮箱、电话、钱包等「数字身份」基础设施,本质上是为 Agent 创造了可在现实系统中行动的接口。这类产品面临的核心挑战不在模型能力本身,而在授权边界(用户如何控制 Agent 的操作权限)、错误追责(Agent 操作失误由谁承担后果)以及资金安全(预算内自动付款的风险管控)。目前行业对这些问题尚无成熟规范,Q 以邀请码限量开放,也在一定程度上反映出产品仍处于风险可控的早期验证阶段。
小结:模型、工具、观点三线齐动
从这一天的动态可以看出,AI 行业的更新节奏依旧密集。模型层面,Claude Sonnet 5.5 以更快更省为卖点;工具层面,Manus、可灵、MiMo 各有升级;观点层面,ChatGPT 定价透明度和数据合规问题引发讨论。三条线索并行推进,共同勾勒出当前 AI 竞争的重点——不再只是能力比拼,效率、成本、合规和执行力正成为新的分水岭。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。