Claude Sonnet 5.5 发布:跑分登顶第2,速度快30%成本降30%

Claude Sonnet 5.5速度提升30%、跑分全球第2,但高Token消耗拉平了实际成本优势。
Anthropic 发布的 Claude Sonnet 5.5 在 Artificial Analysis 智能指数上以 56 分位列全球第 2,仅次于旗舰 Opus 5.5 Max,速度提升超 30%,定价与上代 Sonnet 5 持平(输入 2 美元/输出 10 美元/百万 Token)。然而实测数据揭示了一个隐患:其 Token 消耗量比 Opus 5.5 高 60%、是竞品 Astra 的 7 倍,导致每任务实际成本接近 Fable 5.1,使"降本 30%"的宣传效果大打折扣。在软能力方面,Sonnet 5.5 的设计与写作表现均有提升,适合原型制作与演示场景。开发者在选型时需结合真实任务的 Token 用量综合核算,而非仅参考单价。
Sonnet 5.5:5.5家族的第二款模型
Anthropic 正式发布 Claude Sonnet 5.5,这是 Sonnet 5.5 家族继 Opus 5.5 之后的第二款模型。相比上一代 Sonnet 5,新模型带来了实打实的性能跃升——官方数据显示,运行速度提升超过 30%,且在大多数任务上成本最高可降低 30%。
对于一款定位在“中量级”的模型而言,这样的提升足以改变很多开发者的选型逻辑。Sonnet 系列一直是 Anthropic 在性价比与能力之间取得平衡的主力产品线,5.5 版本延续了这个定位,同时把上限往上推了一大截。
跑分表现:总排名第2,仅次于 Opus 5.5
在 Artificial Analysis 智能指数上,Sonnet 5.5 拿到了 56 分,仅比顶配的 Opus 5.5 Max 低 2 分,稳居总排名第 2。这个成绩相当抢眼——它意味着一款 Sonnet 级别的模型,已经足以在综合能力上超越 Fable 和 Astra 等竞品。
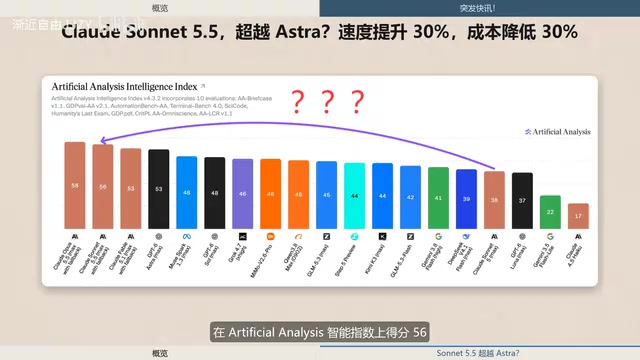
视频作者在解读跑分图时也直言,“原来只需 Sonnet 出手就干掉了 Fable 和 Astra 了吗”,可见此次分数分布对整个竞争格局的冲击。在多项基准测试中,Sonnet 5.5 甚至以低或中等推理强度,就超越了 Sonnet 5 的最佳成绩,而成本仅为后者的约十分之一。
Artificial Analysis 智能指数是一个第三方 AI 模型综合评测平台,通过聚合多项基准测试(包括推理、编程、数学、语言理解等)对各家大语言模型进行横向排名。该指数并非单一跑分,而是对模型"综合智能水平"的加权综合评估,因此比单一 benchmark 更难被针对性优化。Fable 和 Astra 均为该排行榜上处于中高分段的竞品模型——Sonnet 5.5 以 Sonnet 级别(非旗舰定位)的产品超越它们,说明 Anthropic 在模型效率上取得了结构性突破,而非仅靠堆算力提升分数。
定价与成本:宣传与实测的落差
Sonnet 5.5 的定价与 Sonnet 5 保持一致,输入 2 美元、输出 10 美元(每百万 Token)。官方强调,完成同样的工作通常需要的 Token 数量要少得多,加上输出生成速度提升 30% 以上,它被称为“迄今为止最快的 Sonnet 模型”。
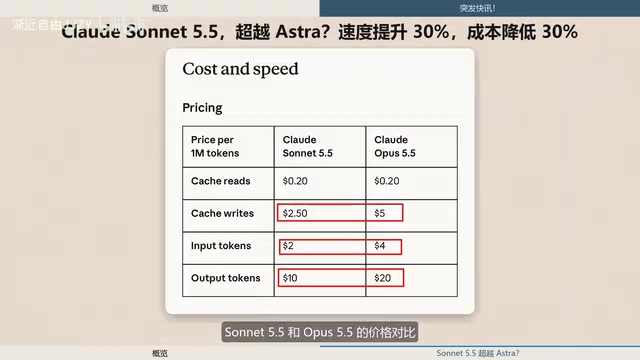
在与 Opus 5.5 的价格对比中,两者缓存读取价格相同,其余项目 Sonnet 5.5 便宜约一半。单看纸面数据,性价比优势明显。
不过值得推敲的是实际成本表现。视频指出,Sonnet 5.5 的成本可能并不像宣传的那么低——它的 Token 使用量非常高,比 Opus 5.5 高出 60%,是 Astra 的 7 倍。这直接推高了它的每任务成本,几乎与 Fable 5.1 持平。
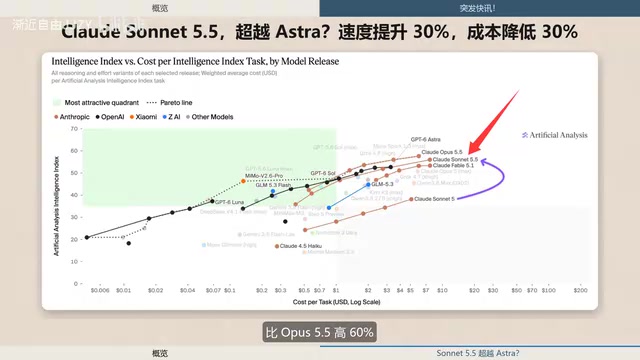
这就带来一个尖锐的问题:如果每任务成本相近,为什么不直接用更强、单价更便宜的 Opus 5.5?对于 Token 消耗敏感的生产环境,这一点尤其需要在正式部署前做实测评估,不能只看单价。
Token 是大语言模型计费和计算的基本单位,大致对应文本中的词或子词片段(英文约 1 个 Token ≈ 0.75 个单词,中文约 1 个汉字 ≈ 1-2 个 Token)。模型完成同一任务所消耗的 Token 数量受多重因素影响:思维链(Chain-of-Thought)推理越复杂、内部"草稿"越长,Token 消耗越高;部分模型会生成更多中间步骤再给出答案,这类模型即便单价低,总账算下来也未必省钱。Sonnet 5.5 Token 消耗比 Opus 5.5 高出 60% 的现象,正是这一机制的体现——它可能在内部生成了更长的推理过程,从而拉高了每任务实际费用,抵消了单价优势。
设计与写作能力的提升
除了跑分和成本,Sonnet 5.5 在“软实力”上也有明显进步。它在设计方面颇有天赋,能够提升用户界面的精致度,并且遵循模板生成几乎无需编辑的幻灯片,这对做演示、做原型的用户是实用的加分项。
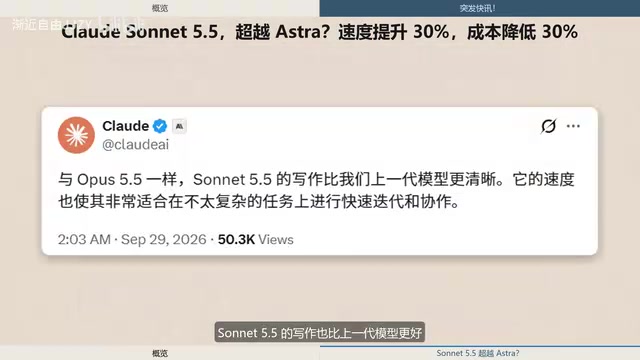
与 Opus 5.5 一样,Sonnet 5.5 的写作质量也比上一代模型更好。综合来看,它把“能力接近旗舰、价格更亲民”的定位又向前推进了一步。
上线情况与经典对比环节
Sonnet 5.5 已在所有平台上线,而同家族的 Haiku 5.5 将在未来几周内发布。按照跑分推测,Haiku 5.5 可能会与 Astra 处在同一水平(约 53 分)。
视频最后照例进行了“鹈鹕骑自行车”这一经典的模型能力横向对比环节,参赛选手包括 GPT-6、Sonnet 5.5、Astra 等,用趣味方式直观展示各模型的生成表现。
小结
Claude Sonnet 5.5 是一次亮眼的迭代:速度更快、跑分登顶第 2、设计与写作能力增强,纸面性价比优秀。但它偏高的 Token 消耗也提醒开发者,选型时要结合真实任务的 Token 使用量算总账,而非只看单价。对追求极致性价比或高强度任务的用户,Opus 5.5 仍是需要认真对比的选项。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。