Claude Sonnet 5.5实测:性能飙升成本骤降的商业甜点级AI

Claude Sonnet 5.5以减半的价格实现编程能力跨越式提升,成为企业AI落地的高性价比选择。
Anthropic发布的Claude Sonnet 5.5定位于高频企业任务的"商业甜点",以输入2美元/百万Token的价格(约为顶级Opus 5.5的一半)实现了生成速度提升30%、总任务成本最低降低30%的综合升级。最具说服力的是编程能力的跨越式飞跃:在Terminal Bench基准测试中,得分从上一代的10.3%跃升至70.6%,已从"辅助代码补全"进化为"驱动完整开发流程"的生产力工具。Epic Games、Slack、Zendesk等大厂的实测反馈印证了其在长任务稳定性、工具调用可靠性和响应速度方面的实际价值。安全层面,它还是首个内置反模型蒸馏攻击分类器的Sonnet版本,叠加网络安全与生物安全防护,为企业核心业务的大规模落地提供了完整支撑。
Sonnet 5.5的定位:专攻高频任务的商业甜点
Anthropic低调发布的Claude Sonnet 5.5,正在成为企业AI落地讨论的焦点。它主打一个极其务实的价值点:运行速度提升30%以上、整体成本降低约30%,同时综合表现远超上一代。
很多企业在落地AI时都会卡在一个尴尬的痛点上——强的模型太贵,便宜的模型在处理复杂业务流时又频繁掉链子,算下来项目根本无法回本。Anthropic这次给出了明确的定位划分:Opus 5.5负责啃硬骨头,专攻需要深度判断、开放性极强的复杂任务;而Sonnet 5.5则瞄准界限清晰、高频出现的日常任务——写代码、快速迭代、修bug、生成汇报文档。
它未必是全知全能的推理大师,但精准击中了日常工作的"甜点味",把性能与成本的平衡拿捏得很到位。
编程能力:跨越式的质变而非挤牙膏
对开发团队来说,这次升级堪称如虎添翼。最能说明问题的是基准测试数据:在硬核的Terminal Bench基准里,上一代Sonnet 5.0仅拿到10.3%,而5.5版本直接飙升到70.6%。
这个测试模拟的是程序员在命令行界面下完成复杂多步骤专业任务,非常接近一线开发者的真实工作状态。从10.3%到70.6%,这已经不是渐进式优化,而是跨越式的质变。在模拟真实Cursor编码的测试中,成绩也从34.1%大幅拉升至55.5%。
更关键的是,拿下这些高分的同时,单次任务成本仅为上一代的一小部分。花更少的钱,跑出逼近顶级模型的效果,这是它在成本效益上的核心杀伤力。
大厂背书与稳定性提升
跑分之外,实际应用更有说服力。Epic Games的首席运营官透露,他们把Sonnet 5.5用于处理数以万计的游戏系统加固代码,不仅运行速度快,在长达数小时的超长任务中依然稳定,具备接盘大型商业核心项目的实力。
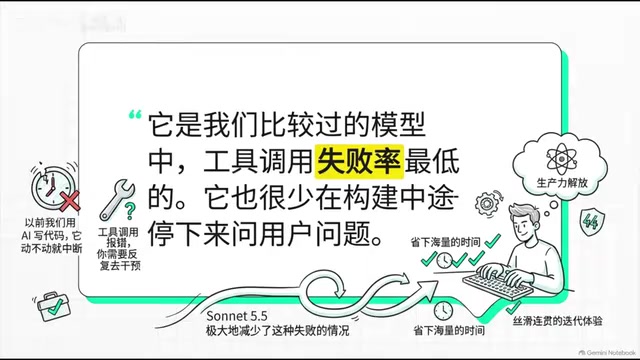
写过AI辅助代码的人都懂,最烦的就是模型中途报错、工具调用失败,逼你手动干预。Base44的工程主管发现,Sonnet 5.5是工具调用失败率最低的模型,几乎不会在代码构建到一半时突然停下来反问你问题。这种连贯顺畅的迭代体验,能为开发者节省大量时间。
Terminal Bench是一个专门评估大语言模型在真实终端环境中执行复杂任务能力的基准测试集,它要求模型通过命令行完成包括文件系统操作、脚本调试、依赖管理、多步骤自动化等高度接近生产环境的任务,而非简单的代码补全或单函数生成。相比HumanEval、MBPP等传统编程基准,Terminal Bench的难点在于任务链更长、上下文依赖更强,且需要模型自主判断工具调用的顺序与边界——这也是为什么它的分数能更真实地反映一个模型在实际开发工作流中的可用性。从10.3%到70.6%的跳跃意味着,模型在"能完成零散代码片段"到"能独立驱动完整开发流程"之间完成了本质性的跃迁。
知识工作:不止是写代码的理科男
别以为Sonnet 5.5只擅长编程。在涵盖几十个职业和行业的综合业务测试中,它的得分几乎与Opus 5.5平起平坐。
早期测试者还发现它对设计有着超乎寻常的敏锐度。举个例子:把一堆枯燥的财报数据加上一段电话会议记录,再配个公司常用的幻灯片模板扔给它,它能直接输出一份排版考究、格式精美的运营评估报告,稍作修改甚至可以直接发给投资人。
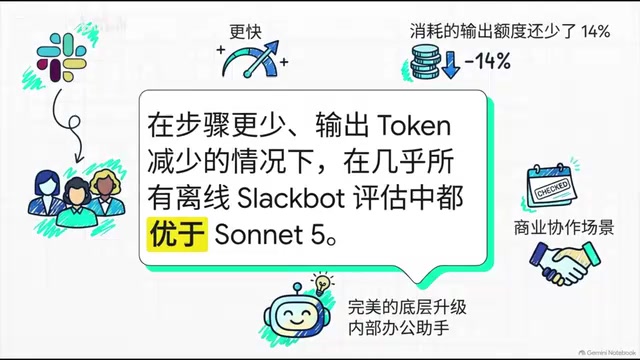
在真实商业协作场景里,Slack的首席工程师给出了肯定反馈:在完全不修改原有提示词的情况下,Sonnet 5.5就能干得更好更快,而且消耗的输出Token反而减少了约14%。对于SlackBot这类每天处理海量请求、对响应速度要求极高的助手来说,这是坚实的底层升级。
客服巨头Zendesk的反馈更直接——工单处理速度整整提高了20%。在客服这个红海领域,时间就是真金白银,这意味着用更低的运营成本提供更快的客户体验。
成本与效率:把这笔账算明白
把底牌掀开对比:相比顶级的Opus 5.5,Sonnet 5.5的定价极具侵略性——输入每百万Token仅2美元,输出仅10美元,价格几乎砍半。这就是它被称为"商业甜点"的核心原因:只花一半预算,就能在绝大多数高频日常任务中获得不逊色于顶级模型的体验。

有人可能会嘀咕"便宜没好货",但在这里这个常理被打破了。相比上一代,它的生成速度快了30%以上,而且更聪明了——可以用更少的步骤完成同样的任务,消耗的总Token自然减少。所以在实际落地测试中,完成同样的单次任务,总成本最高能降低30%。又快、又好、还更省钱。
安全防护:企业大规模落地的三大支柱
技术再强,要在企业核心业务里大规模铺开,绕不开"安全"二字。Sonnet 5.5把安全防护拆解成三大支柱。
网络安全:对齐了顶级模型的防护标准,日常写代码查bug完全不受影响,但高危的网络攻击请求会被拦截。
生物学防护:专门盯防生命科学领域的高危请求。
防模型蒸馏:这是极具前瞻性的一招。所谓蒸馏攻击,是指恶意方用大量假账号疯狂向AI提问,试图在工业规模上窃取模型底层的推理逻辑,去训练不受监管的AI。由于Sonnet 5.5的推理能力太强,容易成为攻击目标,因此它是首个自带拦截此类提取攻击分类器的Sonnet模型,强制锁死思维保留机制,断绝能力外泄的风险。
模型蒸馏(Model Distillation)本是一种合法的模型压缩技术,核心思路是用一个大型"教师模型"的输出去训练一个轻量"学生模型",从而在更低计算成本下复刻大模型的部分推理能力。然而当这一技术被恶意利用时,攻击者会通过API大规模采集目标模型的回答,系统性地还原其推理模式,进而训练出不受安全约束、也无需支付授权费用的仿制模型。这类攻击在商业上动机极强——顶级推理模型的训练成本动辄数亿美元,而蒸馏攻击可以用极低成本"窃取"绝大部分能力。Sonnet 5.5内置的反蒸馏分类器能识别出大规模、系统性探测推理边界的请求模式,在不影响正常用户的前提下拦截工业级的能力提取行为,这对保护Anthropic的知识产权与维护模型安全生态均有直接意义。
写在最后
从编程能力的核爆级飞跃,到知识工作体验的全面革新,再到算得明明白白的高性价比,Claude Sonnet 5.5展现出的是一款面向企业落地的生产力引擎。在每一分钱都要花在刀刃上、所有团队都在绞尽脑汁降本增效的当下,一款能让产出提速30%、成本降低30%的AI模型,确实值得每一个关注团队效率的人认真评估。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。