Claude形式化验证:为123个开源库证明无崩溃

Anthropic用Claude为123个OSS-Fuzz库完成无崩溃形式化证明,但边界需冷静看待。
Anthropic利用Claude对123个OSS-Fuzz开源库进行了形式化验证,证明其代码不存在导致崩溃的执行路径。这不同于单元测试或模糊测试,而是数学意义上的证明。文章指出,被验证的库已有模糊测试基线,证明针对的是内存安全类崩溃,属于增量保证而非从零构建。证明结论严格依赖所写规范与假设,"无崩溃"不等于功能正确或无逻辑漏洞。文章还强调,结构良好的fuzz target是形式化验证易于切入的前提,值得团队优先投入测试基础设施。当前定位应是验证工程师的副驾驶,而非一键安全按钮。
Anthropic最近做了一件在软件工程圈颇为罕见的事:用Claude对123个OSS-Fuzz开源库进行形式化验证,证明这些库的代码不存在导致崩溃的路径。这不是单元测试,也不是模糊测试,而是数学意义上的证明。消息来自RSS源的一篇分析文章,标题直指核心——「AI Formal Verification: Claude Proved 123 Libraries Crash-Free」。
形式化验证是什么,为什么难
形式化验证(Formal Verification)是用数学方法证明程序满足特定性质的技术。与测试不同,测试只能覆盖有限输入,而形式化验证试图覆盖所有可能的执行路径。传统上,这需要专家手动编写规范、构造不变量、引导定理证明器,成本极高,通常只用于航空航天、芯片设计等对正确性要求极端的领域。
将大语言模型引入这一流程,是近两年才出现的方向。Claude在这里扮演的角色,很可能是辅助生成验证所需的前置条件、循环不变量和断言,把过去需要数天甚至数周的手工工作压缩到可接受的范围内。
定理证明器与SMT求解器是形式化验证工具链的核心组件。定理证明器(如Coq、Isabelle、Lean)要求用户提供逐步的证明脚本,由内核机械检查每一步推理是否合法;SMT求解器(如Z3、CVC5)则自动判定一阶逻辑公式的可满足性,常用于验证循环不变量和路径条件。Claude在这类流程中生成的"验证工件",通常就是交给这些工具检查的断言、不变量和证明片段——LLM负责提出候选,求解器负责最终裁决,二者形成"生成-检查"闭环,这也是LLM辅助验证能被信任的机制基础。
123个库的证明覆盖了什么
根据原文信息,这批证明针对的是「无崩溃性质」(no-crash properties),即证明代码在给定约束下不会触发内存安全违规、空指针解引用、数组越界等导致进程终止的行为。目标库来自OSS-Fuzz——Google维护的开源模糊测试基础设施,本身收录的就是经过一定安全筛选的项目。
这一点值得注意:被验证的不是任意代码,而是已经有模糊测试覆盖的库。这既降低了难度,也意味着验证结果是在「已有一定安全基线」之上的增量保证。
OSS-Fuzz是Google于2016年发起的持续模糊测试服务,目前覆盖数百个开源项目,通过持续集成对项目进行高频随机输入测试,发现的内存安全漏洞会以私有bug形式报告给维护者。其收录标准要求项目有明确的fuzz target(测试入口函数)且能被构建为libFuzzer或AFL等引擎可调用的形式。由于fuzz target本身就是"给定字节输入、调用被测代码"的封装,它天然提供了形式化验证所需的函数入口和输入契约,这解释了为何这批库比普通开源项目更适合作为LLM辅助验证的试验田。
证明的边界在哪里
原文明确提到了「proofs cover what, and where they stop」,这是整件事最需要冷静看待的部分。
形式化验证的结论严格依赖于所证明的性质和假设。证明「无崩溃」不等于证明「功能正确」,也不等于证明「无逻辑漏洞」。如果规范本身写得不完整,证明只能覆盖规范所描述的那部分行为。此外,LLM生成的验证工件需要经过定理证明器检查,但规范的撰写仍然可能引入盲区。
另一个现实约束是规模。123个库听起来不少,但相对于OSS-Fuzz收录的数千个项目仍是子集。哪些库被选中、选择标准是什么,原文没有展开,这会影响结论的普适性。
"无崩溃性质"(no-crash property) 在形式化验证语境下通常指:对fuzz target的所有合法输入,被测代码不会触发未定义行为、除零、越界访问等导致进程异常终止的路径。这类性质属于"安全性属性"(safety properties),只约束"坏事不发生",不要求"好事一定发生"。与之相对的是"功能正确性"(functional correctness),需要写出完整的输入-输出规范,证明难度高出一个量级。因此,即使123个库全部通过无崩溃验证,也只能说明在这些库的fuzz target入口下没有可触发的崩溃路径,对于并发竞态、资源泄漏、时序相关的逻辑缺陷等,此类证明通常无法覆盖。
模糊测试目标(fuzz target)的写法值得借鉴
原文副标题提到「the fuzz-target habits worth copying on Monday」,指向一个非常务实的点:这些库之所以能被验证,很大程度上因为它们已经有结构良好的模糊测试目标。
一个好的fuzz target通常具备几个特征:入口清晰、输入约束明确、初始化与清理逻辑分离、避免依赖全局状态。这些特征不仅让模糊测试更有效,也让形式化验证更容易切入——因为验证工具需要一个明确的函数入口和可描述的前置条件。
换句话说,投资于测试基础设施的团队,在引入AI辅助验证时会获得不成比例的回报。这是原文给出的最具操作性的建议。
循环不变量是形式化验证中最考验人工设计的环节之一:要让定理证明器理解一个循环为何满足某性质,必须提供在每次迭代前后都成立的断言。LLM在这一步的价值在于,它可以根据代码结构和已有断言生成候选不变量,再由证明器验证是否足够强。但候选不变量若过弱,证明会失败;若过强,则可能无法被归纳证明。这种"强度调优"目前仍高度依赖验证工程师的判断,也是LLM输出需要人工审查的主要原因之一。
对工程团队意味着什么
短期内,这更像是验证流程的加速器而非替代品。团队仍然需要理解被验证的性质、审查生成的规范、解读证明器的反馈。把Claude当作「验证工程师的副驾驶」是合理定位;把它当作「一键证明安全」的按钮则会带来虚假的安全感。
长期看,如果LLM生成验证工件的可靠性持续提升,形式化验证的适用边界可能从高保证系统扩展到更普通的服务端代码。123个库的实验是这一方向上的一次有意义的探路,但距离工程化落地还有距离。
相关推荐
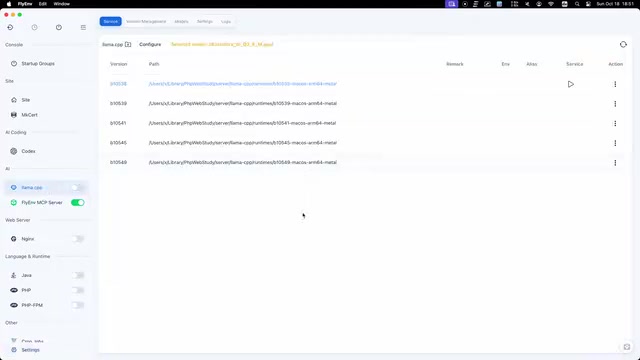
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
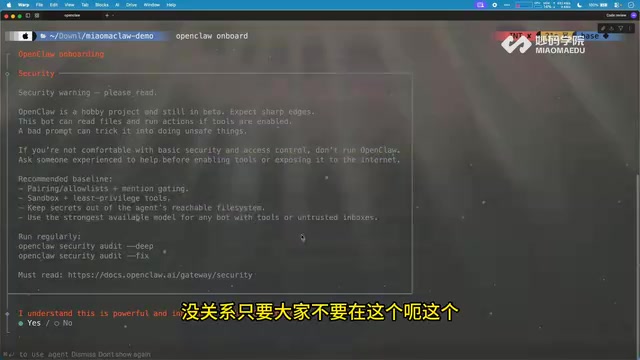
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
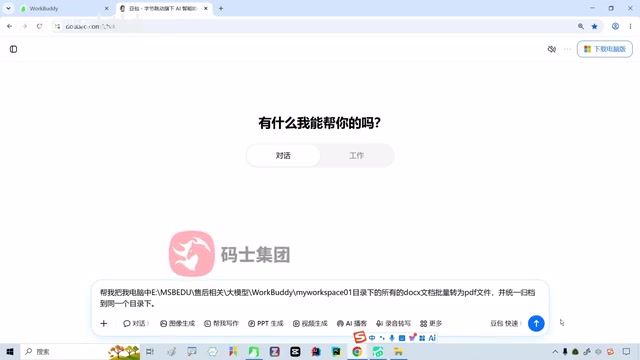
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。