Claude用梗造了个编程语言:Memesis让AI智能体安全"整活"

Claude Code 将网络梗关键字落地为一门带污点追踪安全机制的 AI 智能体编程语言 Memesis。
Memesis 是一门以网络梗作为关键字的实验性解释型编程语言,专为 AI 智能体开发设计,由 Claude Code 完成词法分析、语法解析、解释器与 CLI 的全部实现。其核心亮点在于将安全概念内建为语言原语:`sus` 标记不可信数据,`yolo` 标记不可逆操作,运行时自动追踪数据来源并阻止未审核数据流向危险操作,实质是一套污点追踪与静态检查机制。`apu` 与 `thonk` 则把人类介入和 AI 调用写入语言层。项目支持多智能体、并行任务与 Ollama 接入,MIT 协议开源,Claude Code 还编写了 34 个测试并生成 README 动画。文章认为其展示了「人类出概念、AI 写实现」的协作潜力,但生态仍不完善。
当编程语言开始玩梗:Memesis 是什么?
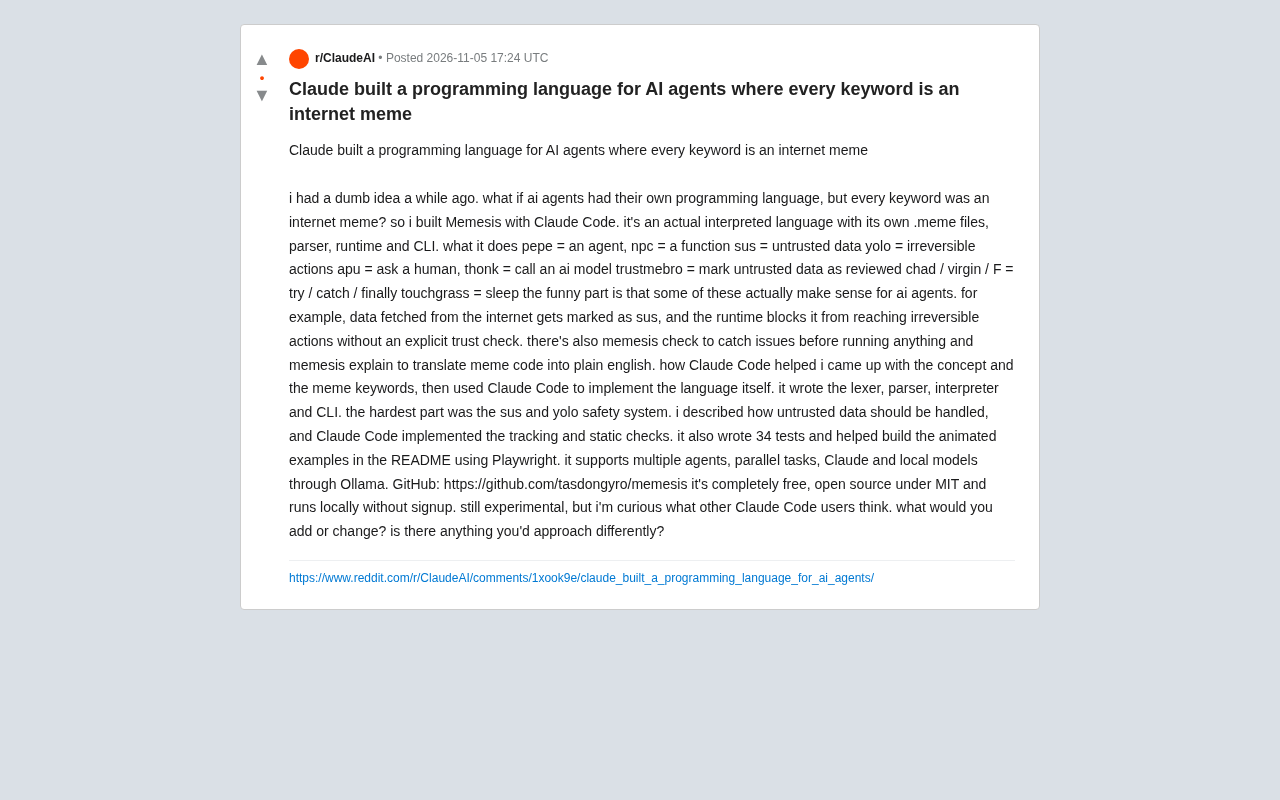
想象一下这样的代码:pepe 代表一个 AI 智能体,npc 是函数,sus 标记不可信数据,yolo 表示不可逆操作。这不是段子,而是一个真实可运行的编程语言——Memesis。据 Reddit 社区分享,一位开发者借助 Claude Code,将"AI 智能体专用编程语言,但每个关键字都是网络梗"这个看似荒诞的脑洞,落地成了一个完整的解释型语言。
Memesis 拥有自己的 .meme 文件格式、解析器、运行时和 CLI 工具,完全开源(MIT 协议),本地运行无需注册。目前仍处于实验阶段,但已经能支撑多智能体、并行任务,并可通过 Ollama 接入 Claude 和本地模型。
梗言梗语背后的严肃设计
这个项目最有趣的地方在于,许多梗关键字并非纯粹搞笑,而是精准映射了 AI 智能体开发中的真实需求。
用"sus"和"yolo"构建安全边界
开发者将 sus 定义为不可信数据,yolo 定义为不可逆操作。运行时系统会追踪数据来源——从互联网抓取的内容自动被标记为 sus,在未经过显式信任检查(trustmebro 标记为已审核)之前,这些数据无法流向 yolo 操作。这实际上实现了一套污点追踪与静态检查机制,防止提示注入或恶意数据触发危险行为。
污点追踪(Taint Tracking) 是一种动态或静态的程序分析技术,核心思想是为每个数据值附加一个「污点标签」,记录其来源是否可信。当不可信数据(如用户输入、网络抓取内容)流入程序时,系统会将该值标记为「污染」,并在后续计算中传播这一标记——任何由污染数据衍生的新值同样被污染。最终,在数据流向敏感操作(如文件写入、网络请求、代码执行)之前,系统检查其污点状态,若仍为污染则阻止执行或强制要求显式净化。Memesis 中的 sus 标签自动附加于互联网来源数据,trustmebro 相当于显式净化声明,而 yolo 操作则充当污点汇聚点,构成了经典的污点追踪三要素:源(source)、传播规则(propagation)、汇(sink)。
调用人类与AI的协作原语
apu 用于请求人类介入,thonk 用于调用 AI 模型。这两个关键字把"人机协同"直接写进了语言原语中,让智能体在不确定时能够主动寻求帮助,而不是盲目执行。
人机协同原语(Human-in-the-Loop Primitives) 指编程语言或框架中将「请求人类介入」和「调用 AI 模型」作为一等公民操作的设计。传统编程语言中,人类输入通常通过标准 I/O 或回调函数实现,AI 调用则依赖外部 API 库。Memesis 将 apu(请求人类介入)和 thonk(调用 AI 模型)直接内建为语言关键字,意味着智能体程序可以在任意逻辑点主动暂停、向人类或更强模型求助,并将返回结果作为一等值继续参与计算。这种设计反映了 AI 智能体开发中的一个核心模式:智能体不应被假设为全知全能,而应具备「知道自己不知道」并主动寻求外部协助的能力,从而在不确定场景下避免盲目执行错误操作。
其他关键字一览
chad/virgin/F:对应 try / catch / finally 异常处理touchgrass:让智能体"去接触草地",即休眠等待
这套命名看似戏谑,却让代码意图一目了然——至少对熟悉网络文化的开发者来说如此。
Claude Code 如何从零实现一门语言
据开发者描述,整个实现过程由 Claude Code 完成:词法分析器、语法解析器、解释器和 CLI 全部由 AI 编写。最具挑战的部分是 sus 与 yolo 的安全系统。开发者只需描述不可信数据应如何处理,Claude Code 便实现了数据追踪与静态检查逻辑。
此外,Claude Code 还编写了 34 个测试,并借助 Playwright 生成了 README 中的动画示例。这种"人类出概念、AI 写实现"的协作模式,展示了 AI 编程工具在复杂系统构建中的潜力——不再是简单的代码补全,而是承担完整模块的设计与实现。
解释型语言(Interpreted Language) 与编译型语言的核心区别在于执行方式:解释器直接读取源代码并逐行执行,无需预先编译为机器码。一门解释型语言的典型实现包含三个阶段:词法分析器(Lexer)将字符流切分为有意义的词法单元(Token);语法解析器(Parser)依据文法规则将 Token 序列组织为抽象语法树(AST);解释器(Interpreter)遍历 AST 并执行相应语义。Memesis 的 .meme 文件经由这三阶段处理,由 CLI 工具驱动运行。与编译型语言相比,解释型语言开发迭代更快、跨平台性更好,但运行效率通常较低——这正是实验性语言项目的合理取舍。
对 AI 智能体开发者的启示
Memesis 的价值不止于"好玩"。它为 AI 智能体编程提供了一个值得思考的范本:
- 安全原语内置化:将数据可信度与操作风险作为语言级概念,而非事后补丁。
- 可解释性工具:
memesis check可在运行前发现问题,memesis explain能将梗代码翻译成自然语言解释。 - 降低理解门槛:梗关键字让代码更易读,尤其对非传统背景的开发者。
当然,作为一个实验性项目,Memesis 的生态和工具链尚不完善。开发者本人也在社区中询问:还有什么值得添加或修改?是否有不同的实现思路?
对于关注 AI 编程、智能体安全或开源工具的开发者来说,这是一个值得关注和参与的有趣项目。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。