CLEAR-WSI:诊断驱动的病理全切片检索框架

CLEAR-WSI 用固定长度嵌入和诊断标签精炼实现可扩展的全切片图像检索。
CLEAR-WSI 是一个面向数字病理全切片图像的可扩展检索框架,旨在绕开元数据不一致和手工索引流水线的瓶颈。它从视觉内容中学习固定长度的切片嵌入,统一表示不同尺寸和放大倍率的 WSI,并利用预测或真实诊断标签精炼检索候选,使结果更贴合临床诊断意图。新病例可持续加入记忆库,使检索档案随时间扩展而无需重建索引。在 CAMELYON16、BRACS-1、BRACS-2 和 X-HER2 四个任务上,Precision@5 分别提升 3.10、2.75、1.95 和 3.75。文章同时指出,诊断标签质量、延迟表现和提升幅度有限仍是走向临床部署前需要进一步验证的问题。
病理档案检索的痛点与突破
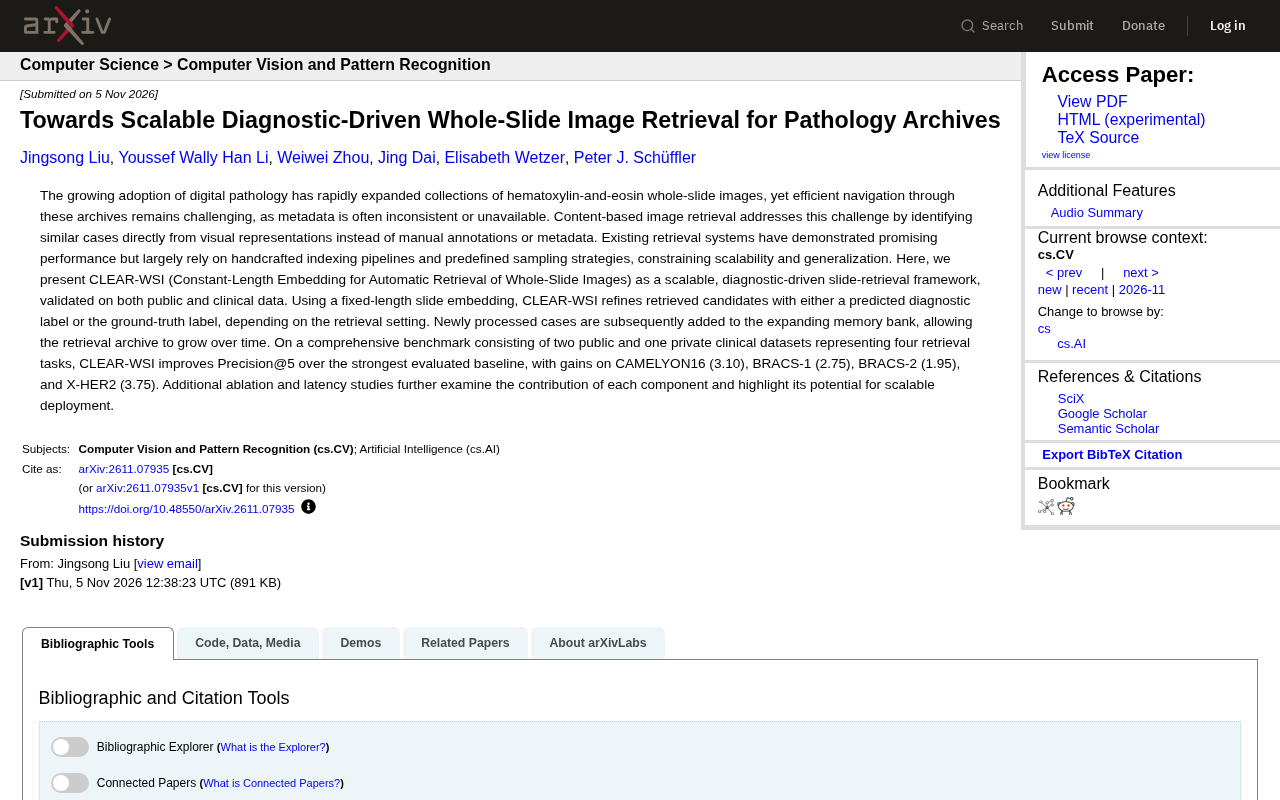
数字病理的普及让全切片图像(WSI)的收藏量迅速膨胀,但要在这些档案中高效导航并不容易。原因在于元数据往往不一致甚至缺失,手动标注又难以规模化。基于内容的图像检索提供了一条出路:它直接从视觉表征中寻找相似病例,不依赖人工注释或元数据。然而,现有系统大多建立在手工设计的索引流水线和预定义的采样策略之上,这限制了它们的可扩展性和泛化能力。
近期一篇来自 RSS 的研究提出了 CLEAR-WSI(Constant-Length Embedding for Automatic Retrieval of Whole-Slide Images),一个可扩展、诊断驱动的切片检索框架,并在公开数据和临床数据上进行了验证。
全切片图像(WSI)是数字病理的基础数据形式,指将玻璃切片通过高分辨率扫描仪数字化后得到的超大像素图像,单张图像通常可达数十亿像素,需要多分辨率金字塔存储。WSI 的尺寸和放大倍率差异很大,直接用于检索或分析时计算负担极重,因此实际系统通常需要先从中采样图像块(patch)再提取特征。这也解释了为何现有检索系统多依赖预定义的采样策略和手工设计的索引流水线——它们需要在海量像素中做取舍。基于内容的图像检索(CBIR)则试图从 WSI 的视觉表征直接学习相似性,但如何将变长的切片表示压缩为固定长度、且不丢失诊断相关信息,仍是技术难点。
CLEAR-WSI 的核心机制
固定长度嵌入与诊断标签精炼
CLEAR-WSI 的关键设计是使用固定长度的切片嵌入来表示整张 WSI。这一嵌入不依赖手工特征,而是从视觉内容中学习得到。在检索阶段,框架会根据检索设置,用预测的诊断标签或真实标签来精炼候选结果。这种诊断驱动的精炼机制,让检索不仅停留在视觉相似层面,还能对齐临床诊断意图。
可扩展的记忆库
新处理的病例会被加入不断扩展的记忆库(memory bank),使检索档案能够随时间增长。这一点对于病理档案的长期积累尤为重要——系统不需要重新训练或重建索引,就能持续吸纳新数据。论文的消融研究和延迟测试进一步考察了各组件的贡献,并强调了其面向规模化部署的潜力。
记忆库(memory bank)是一种在检索与对比学习系统中常见的非参数化数据结构,用于存储已处理样本的嵌入向量及其标签,供后续查询时进行相似度比对。与需要反向传播更新参数的模型不同,记忆库以追加方式扩展,新样本写入后即可被检索,无需重新训练或重建索引。在病理档案场景中,这意味着系统可以持续吸纳新病例,检索范围随数据积累而扩大。但记忆库也带来存储成本与检索延迟的挑战:库越大,最近邻搜索越慢,通常需要借助近似最近邻(ANN)索引来维持响应速度。论文提及的延迟测试正是针对这一工程瓶颈。
基准测试与性能表现
研究在包含两个公开数据集和一个私有临床数据集的综合基准上评估了 CLEAR-WSI,覆盖四个检索任务。与最强的基线相比,CLEAR-WSI 在 Precision@5 指标上均有提升:CAMELYON16 提升 3.10,BRACS-1 提升 2.75,BRACS-2 提升 1.95,X-HER2 提升 3.75。
这些增益虽然数值上不算夸张,但考虑到检索任务本身的难度和临床数据集的异质性,稳定的提升说明了框架的鲁棒性。尤其说个细节,X-HER2 任务上的提升幅度最大,这或许暗示诊断驱动精炼在特定亚型分类场景中更有优势。
Precision@5 是检索任务中常用的评估指标,指返回的前 5 个结果中相关结果所占的比例。在病理图像检索中,“相关”通常由诊断标签或疾病亚型是否一致来定义。该指标关注的是排序靠前的结果质量,与临床使用场景较为贴合——病理医生更关心最相似的几个病例是否真的可比。CAMELYON16 是乳腺癌淋巴结转移检测的公开数据集,BRACS 则聚焦乳腺病变的亚型分类,X-HER2 涉及 HER2 表达状态评估。不同数据集的检索难度和类别分布差异较大,因此各任务上的提升幅度不宜直接横向比较,更应关注同一任务内相对基线的稳定增益。
对数字病理工作流的意义
从应用角度看,CLEAR-WSI 试图解决的是病理档案“存得下但找不着”的困境。传统检索依赖元数据,而现实中病理报告的编码习惯千差万别,缺失和错标并不罕见。基于内容的检索绕开了这一瓶颈,而诊断标签的精炼又弥补了纯视觉检索可能偏离临床相关性的问题。
固定长度嵌入的设计也带来了工程上的便利:不同尺寸、不同放大倍率的切片可以被统一表示,检索系统的复杂度不再随切片数量线性膨胀。记忆库的持续增长机制则让系统具备“越用越丰富”的特性,这对于长期积累的医院病理科档案具有实际价值。
局限与待观察之处
论文在公开和私有数据上做了验证,但私有临床数据集的具体规模和多样性尚未在摘要中充分展开。诊断标签依赖预测或真实标签,若预测标签本身存在误差,检索质量可能受到影响。此外,Precision@5 的提升幅度在个位数级别,距离临床部署所需的可靠性仍有距离。延迟研究虽被提及,但具体数值未在摘要中给出,规模化部署的实际成本仍需进一步评估。
总体而言,CLEAR-WSI 为病理档案的内容检索提供了一个结构清晰、可扩展的框架,其诊断驱动的思路值得关注。后续若能在更大规模的临床数据上验证,并公开更多延迟与鲁棒性细节,这一方向有望走向实用。
相关推荐

B站爆款Pi Agent实战课:零基础搭建智能体全解析
深度解析B站Pi Agent实战课:梳理Pi Agent从早期积累到加速增长的四阶段发展脉络,探讨其与Claude Code、Codex等AI编程工具的差异化定位,零基础学习智能体开发的核心要点。

Vibe Coding零基础入门:AI开发全链路实战指南
B站80集Vibe Coding零基础教程解析:从指挥AI写代码到全链路产品落地,涵盖需求分析、UI设计、前后端开发、数据库、测试部署及AI自动化运营,助你掌握一人公司所需的全栈AI开发能力。

B站保姆级Codex攻略:从安装到实战,一期精通
B站保姆级Codex攻略全解析:从GPT账号注册、桌面端安装、登录验证与网络报错修复,到.env文件解决重新连接5次、PLUS额度机制与Pro升级,附实战使用心法。