Codex Claude插件深度实测:代码审查能力惊艳,但四大致命缺陷不容忽视

OpenAI为Claude打造的Codex编程插件实测表现为长板突出但短板致命的半成品。
OpenAI为竞争对手Claude开发了Codex编程插件,提供代码审查、对抗性安全扫描和代码救援三大核心功能。但经过一周深度实测发现,该插件存在四大致命短板:插件冲突频发导致命令被劫持、输出混乱关键信息被淹没、对抗性安全扫描默认范围过窄容易造成虚假安全感、稳定性波动严重。整体而言是一款半成品。
OpenAI为Claude打造Codex插件:一周深度实测揭示半成品真相
OpenAI为竞争对手Claude打造了一款专属编程插件Codex Plugin,这在AI圈堪称"麦当劳卖肯德基原味鸡"级别的跨界联动。不少媒体将其吹捧为"打破大厂壁垒、开启多智能体编程时代"的里程碑,但经过一周深度实测后,我们发现这款Codex Claude插件的真实面貌远比宣传复杂——它是一款长板突出、短板致命的半成品,而其真正的成功之处,在于精准击中了一批被市场忽略的庞大用户群体。
核心功能一览:只有7条命令的轻量插件
这套Codex Plugin(简称CC插件)的功能架构极其精简,总共只有7条命令,核心功能归纳为三个:
- 标准代码审查:对代码进行常规质量和安全检查
- 对抗性代码审查:模拟攻击者视角进行深度安全扫描
- 代码救援:针对发现的问题自动生成修复方案
看起来简洁有力,但从实际使用体验到底层逻辑,这款AI代码审查插件几乎全线翻车。
四大致命短板:从生态适配到数据安全
输入请求被劫持,插件冲突频发
Claude的插件系统采用基于关键词匹配的意图识别机制,本质上是大语言模型在接收用户输入后,通过语义相似度判断应调用哪个工具。这种架构与OpenAI的Function Calling有所不同——后者允许开发者为每个函数设置明确的调用优先级和互斥规则。Claude的插件生态目前缺乏原生的冲突仲裁层,这意味着当多个插件的触发词语义重叠时,系统无法保证调用的确定性。这一架构缺陷在单插件场景下几乎不可见,但在多插件并存的生产环境中会被急剧放大。
具体到这次冲突:平台要求每个插件必须使用专属代号加关键词来避免冲突,但Codex违规使用了"Review""Result"这类通用词汇,直接与Superpower等同类插件撞车。实测中,我们执行"Codex Review"审查命令时,Superpower插件抢先截胡;输入"Codex Result"查看结果时,又被二次劫持。这种基础层面的适配问题,说明OpenAI在发布前对Claude插件生态的了解严重不足。
输出混乱,关键信息被淹没
Codex插件既没有独立的审查结果面板,也没有按风险等级做色彩高亮或结论置顶。在实测中,一个P1级致命Bug的报告直接被淹没在十几轮对话内容里,我们翻了半天才找到。
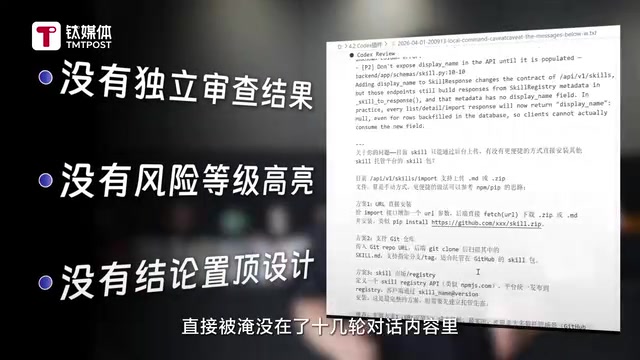
稳定性方面同样堪忧:同一个对抗性审查任务,有时38秒完成,有时卡死在"Starting"状态近三分钟只能手动终止,波动大到离谱。
对抗性安全扫描"偷懒",代码救援"半调子"
对抗性代码审查(Adversarial Code Review)是一种源自红队测试(Red Teaming)思想的安全评估方法,要求审查者以攻击者而非防御者的视角审视代码。传统静态分析工具(如SonarQube、Semgrep)依赖预定义规则库进行模式匹配,对已知漏洞类型覆盖率高,但对业务逻辑漏洞和组合攻击链几乎无能为力。AI驱动的对抗性审查的差异化价值,正在于其能够理解代码的业务语义,推理出跨文件、跨模块的攻击路径。然而,这种能力的发挥高度依赖扫描范围的完整性。
对抗性审查理应覆盖项目全量代码,实现无死角安全扫描。但默认状态下,它只扫描了项目中负责用户登录的文件,虽然挖出了四个漏洞,却对同仓库其他文件夹内的SQL注入、SSRF等同等致命风险完全视而不见。只有手动补充指令,明确要求"从安全缺陷、逻辑缺陷、设计缺陷多维度进行深度全面排查"时,它才勉强扩大扫描范围。不熟悉这个隐藏逻辑的开发者,很容易陷入"假安全
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。