Codex+Ollama本地部署教程:零成本搭建AI编程助手

Ollama接入Codex,实现免费本地AI编程环境搭建
Ollama正式支持接入Codex应用,开发者可在本地运行Gemma、Qwen、LLaMA等开源大模型,零成本获得代码生成、审查、可视化编辑等完整AI编程体验。该方案数据完全不出本机,保障隐私安全,只需中端显卡即可流畅运行,四步即可完成配置部署。虽然本地小模型在复杂任务上不及顶级闭源模型,但足以覆盖绝大多数日常开发需求。
引言:本地AI编程的大门正式打开
AI编程工具的版图正在被重新划分。Ollama近期正式支持接入Codex应用,这意味着开发者可以直接在Codex中调用本地运行的开源大模型,不花一分钱就能获得完整的AI编程体验。对于看重隐私保护、希望降低成本、偏好本地化工作流的开发者而言,这无疑是一次关键性的突破。
这篇教程将从原理到实操,完整讲解Codex与Ollama的集成方案——包括它能带来什么、怎么配置、实际效果如何,帮你用最短时间搭好属于自己的免费AI编程环境。
什么是Codex和Ollama?
Codex:不止写代码的AI编程助手
Codex是一款功能丰富的AI编程助手,能协助开发者完成从代码编写、编辑到审查和交付的全流程工作,被不少开发者视为当前最好用的AI编程工具之一。与GitHub Copilot、Cursor等主流AI编程工具不同,Codex并非以IDE插件的形式存在,而是提供了一个独立的应用环境,将代码编辑、浏览器预览和AI对话整合在同一个界面中。这种设计思路更接近"AI原生开发环境"的理念——不是在传统编辑器上叠加AI功能,而是围绕AI能力重新构建开发工作流。
它的核心能力包括:
- 可视化编辑:加载本地服务器后,可以直观地编辑几乎任何页面。这种所见即所得(WYSIWYG)的编辑模式,让开发者无需在代码和浏览器之间反复切换,大幅缩短了前端开发的反馈循环
- 内置浏览器:直接访问网页并在页面上做标注
- 代码审查:在工作区内审查代码、发表评论,无需切换到其他工具
- 快速迭代:通过对话框直接应用修改,所见即所得
目前Codex支持macOS和Windows平台(Linux版本即将推出),应用本身完全免费。
Ollama:一行命令跑起开源大模型
Ollama是一款专为本地运行开源大语言模型设计的工具。安装过程极其简洁——终端里一条命令就能搞定。装好之后,你可以在自己的机器上运行Gemma、Qwen、LLaMA等主流开源模型,完全脱离云端服务,代码数据始终留在本地,隐私安全无忧。
从技术角度看,Ollama的核心价值在于它极大地降低了本地大模型推理的门槛。大语言模型的原始权重文件通常体积庞大(一个70B参数的模型原始精度下可能超过140GB),直接加载对消费级硬件来说几乎不可能。Ollama内置了对GGUF格式的支持,这是由llama.cpp项目推动的一种高效模型格式,通过量化技术(Quantization)将模型权重从32位浮点数压缩到4位甚至2位整数,在可接受的精度损失范围内将模型体积缩小到原来的1/4到1/8。同时,Ollama会自动检测系统中的GPU并利用CUDA(NVIDIA显卡)或Metal(Apple芯片)进行硬件加速推理,在没有独立显卡的机器上也能回退到CPU推理模式,只是速度会慢一些。
在开源LLM生态中,Ollama扮演的角色类似于Docker之于容器化部署——它不生产模型,但让模型的获取、运行和管理变得像安装一个普通软件一样简单。目前Ollama的模型库已经收录了数百个开源模型,覆盖了从通用对话到代码生成、从文本处理到多模态理解的各种场景。
Codex + Ollama组合的核心优势
把Ollama接入Codex之后,开发者相当于拿到了一套极具性价比的AI编程方案:
- 零成本使用:不需要订阅任何付费服务,本地显卡就是你的算力来源。作为参考,目前主流AI编程工具的订阅费用并不低——GitHub Copilot个人版每月10美元,Cursor Pro每月20美元,而使用Claude或GPT-4o的API进行高频编程辅助,月均开销轻松突破50美元。本地部署方案的唯一成本是一次性的硬件投入和电费,对于已经拥有游戏显卡或Apple Silicon设备的开发者来说,这部分成本几乎为零
- 数据不出本机:所有代码和对话都在本地处理,杜绝隐私泄露风险。这一点在企业开发场景中尤为重要——许多公司的安全合规政策明确禁止将源代码上传到第三方服务器,即便是加密传输也不被允许。2023年三星就曾因员工将内部代码粘贴到ChatGPT中而引发严重的数据泄露事件,此后多家科技公司对云端AI工具实施了严格的使用限制。本地部署方案从根本上消除了这一风险
- 模型随心切换:Gemma 4、Qwen 3、LLaMA 3.1……想用哪个用哪个
- 功能基本完整:代码生成、审查、可视化编辑等Codex核心功能照常可用
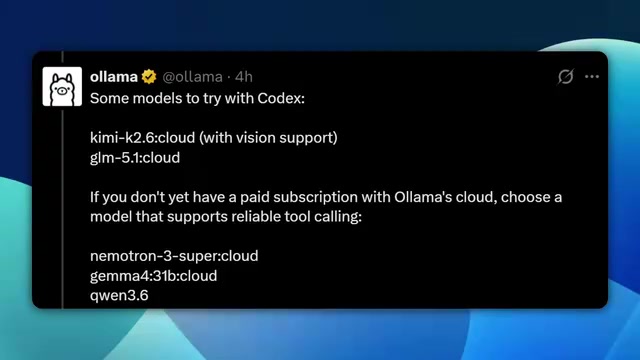
补充一句:Ollama也提供付费的云端API服务,推荐模型包括Qwen 2.5、支持视觉功能的LLaMA 3.1以及Numatron 3 Super。不过本文聚焦的是完全免费的本地部署方案。
完整配置教程:四步搭建本地AI编程环境
第一步:检查硬件能不能带得动
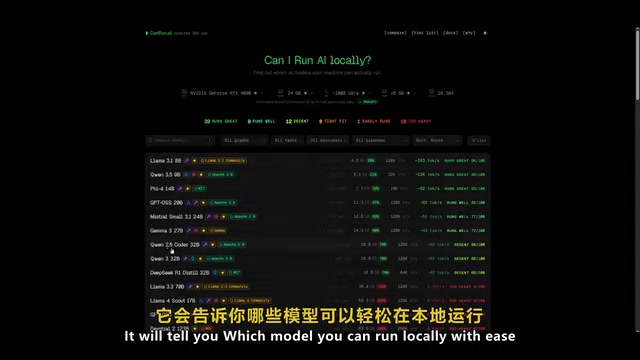
装模型之前,先确认你的硬件跑得起来。推荐使用 Can I Run AI(canirun.ai)做个快速检测:
- 输入你的GPU型号
- 填写显存大小、系统内存和CPU核心数
- 工具会自动列出你能流畅运行的模型清单
理解硬件需求的关键在于显存(VRAM)。大模型推理时需要将模型权重完整加载到显存中,显存不足时会溢出到系统内存甚至硬盘,导致推理速度断崖式下降。一个简单的估算公式是:模型所需显存(GB)≈ 参数量(B)× 量化位数 ÷ 8。以LLaMA 3.1 8B的4位量化版本为例,大约需要8×4÷8=4GB显存,加上推理过程中的KV缓存和上下文开销,实际需要约6-8GB显存才能流畅运行。
如果你的设备没有独立显卡,也不必完全放弃——Apple Silicon芯片(M1/M2/M3/M4系列)的统一内存架构允许GPU直接访问系统内存,16GB内存的MacBook就能流畅运行大多数7-8B参数的模型。纯CPU推理虽然也可行,但生成速度通常只有GPU推理的1/5到1/10,体验会打折扣。
一般来说,一块中端显卡(RTX 3060/4060级别,12GB显存)就能流畅跑LLaMA 3.1 8B。如果选择Gemma 4,2B版本最轻量,4B版本则在性能和效果之间取得了不错的平衡。
第二步:安装Ollama
安装方式很简单,二选一:
- 在终端直接运行官方安装命令
- 从 Ollama官网 下载安装包
⚠️ 版本要求:Ollama版本必须是 0.24或更高,低于此版本可能无法正常对接Codex。安装完成后执行 ollama --version 确认一下。
第三步:下载模型并简单测试
以下是几个适合本地AI编程的推荐模型,了解它们各自的技术背景有助于你做出更合适的选择:
| 模型 | 推荐版本 | 特点 |
|---|---|---|
| Gemma 4 | 2B / 4B | Google出品,轻量高效 |
| Qwen 3 | 多种尺寸可选 | 阿里出品,中文编程能力突出 |
| LLaMA 3.1 | 8B | Meta出品,综合能力均衡 |
Gemma 4 是Google DeepMind推出的轻量级开源模型系列,基于Gemini的技术架构蒸馏而来。它的最大特点是在极小的参数规模下保持了相当不错的代码生成能力,2B版本甚至可以在没有独立显卡的笔记本上运行。Gemma 4还原生支持多模态输入,这意味着它可以理解截图中的UI布局并生成对应代码,与Codex的可视化编辑功能形成了天然的互补。
Qwen 3(通义千问广告)是阿里云推出的开源大模型,在代码生成基准测试(如HumanEval、MBPP)中表现亮眼,尤其在中文编程场景下优势明显——无论是中文注释生成、中文技术文档理解,还是涉及中文业务逻辑的代码编写,Qwen 3都比其他同级别模型更加得心应手。Qwen 3还引入了"思考模式"(Thinking Mode),在处理复杂编程问题时会先进行推理再输出答案,类似于OpenAI o1的思维链机制。
LLaMA 3.1 是Meta开源的旗舰模型,8B版本是目前开源社区中综合能力最均衡的"万金油"选手。它的训练数据覆盖了大量高质量代码语料(包括GitHub公开仓库和Stack Overflow等),在Python、JavaScript、TypeScript等主流编程语言上的表现尤为稳定。LLaMA系列还拥有开源社区中最丰富的微调版本生态,如果你后续想针对特定编程任务进行定制化微调,LLaMA是最佳起点。
以Gemma 4的4B版本为例,打开终端执行:
# 确保Ollama已在后台运行
ollama run gemma4:4b
模型文件大约9.6GB(这是经过4位量化后的体积,原始精度下4B参数模型约为8GB,加上GGUF格式的元数据和量化表开销后略有增加),下载完成后会自动进入聊天界面。建议先随手问几个编程问题,确认模型响应正常再往下走。
第四步:把Ollama接入Codex
这一步是整个流程的关键。在终端执行Ollama为Codex提供的专用启动命令:
ollama launch codex-app
执行后Ollama会自动扫描你已安装的本地模型,列出可用选项。选中目标模型(比如Gemma 4B),回车确认,Codex就会加载该模型并完成启动。
从技术实现上看,这个对接过程的本质是Ollama在本地启动了一个兼容OpenAI API格式的HTTP服务端点(默认监听在localhost:11434),Codex应用则作为客户端向这个端点发送请求。这种基于OpenAI兼容API的对接方式已经成为AI工具集成的事实标准,也意味着未来其他支持自定义API端点的AI编程工具同样可以通过类似方式接入Ollama。
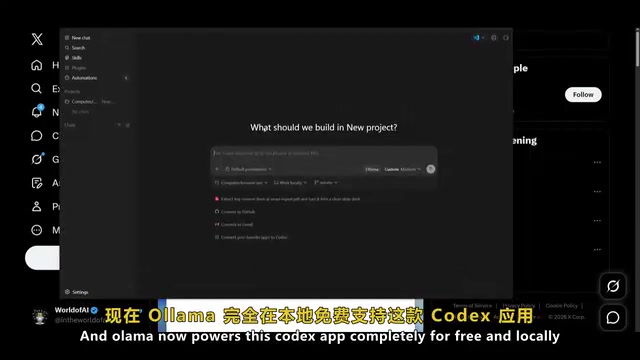
启动成功后,Codex界面上会显示"由Ollama驱动"的标识,说明本地模型已经接入,所有AI编程功能均可正常使用。
想恢复默认设置?
如果需要切回Codex的原始配置,执行以下命令即可:
ollama launch codex-app --restore
所有设置会恢复到之前的状态,已下载的模型文件不受影响。
本地模型实测:Gemma 4B能做到什么?
在实际测试中,我用Gemma 4B(40亿参数)在本地生成了一个完整的SaaS产品落地页。全程没有调用任何云端API,生成的HTML代码直接丢进浏览器就能预览,页面结构清晰、样式也像模像样。
从日常使用来看,本地开源模型在这些场景下表现靠谱:
- ✅ 日常代码生成与智能补全
- ✅ 前端页面快速搭建
- ✅ 代码审查与优化建议
- ✅ 常见Bug排查与修复
当然也要说实话:碰到复杂架构设计、大规模代码重构这类高难度任务,本地小模型的表现确实不如GPT-4o或Claude这些顶级闭源模型。这种差距的根源是多方面的。首先是参数规模的绝对差异——GPT-4o的参数量估计在数千亿级别,是Gemma 4B的上百倍,更大的参数量意味着模型能够编码更丰富的代码模式和架构知识。其次是训练数据的差异,闭源模型通常使用了经过精心筛选和清洗的海量私有数据集,包括企业级代码库和专业技术文档,而开源模型的训练数据在规模和质量上往往有所不及。最后是**RLHF(基于人类反馈的强化学习)**的投入程度,顶级闭源模型在对齐阶段投入了大量人工标注资源,使其在理解复杂指令、处理边界情况和生成结构化长代码方面表现更加稳健。
不过值得注意的是,这种差距正在快速缩小。2024年以来,开源模型在代码生成基准测试上的得分提升速度已经超过了闭源模型的迭代节奏,Qwen 2.5 Coder 32B在部分编程基准上甚至已经追平了GPT-4o。随着模型蒸馏、合成数据训练等技术的成熟,未来小参数开源模型的能力天花板还会继续抬高。
但对于绝大多数日常开发需求,这套免费方案已经绰绰有余。
总结与展望
Ollama与Codex的打通,让开源AI编程工具迈入了一个新阶段。开发者不用再为AI编程助手掏订阅费,也不必纠结代码数据会不会被上传到别人的服务器。只要手头有一台配置过得去的电脑,就能搭起一套功能完整的本地AI编程工作流。
随着Gemma、Qwen、LLaMA等开源模型的迭代节奏越来越快,本地AI编程的体验只会持续提升。无论你是独立开发者、初创团队成员,还是对数据安全有严格要求的企业开发者,这套方案都值得尽早上手试试。
现在就打开终端动手吧——你的下一个项目,说不定就从一个免费的本地AI编程助手开始。
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。