Codex零基础教程:接国内大模型+四大实战案例

零基础用 Codex 接国产大模型,四案例掌握 AI 编程核心能力。
文章整理自 B 站 UP 主「数字生命卡兹克」的 Codex 新手教程,面向零技术背景读者。先讲安装三步:下载安装 Codex、登录账号,再用 CC Switch 把后端切换为 DeepSeek 等国产大模型,并开启用量查询监控 Token 消耗。接着说明界面模式与必装插件,强调插件并非越多越好,Computer Use 和一款隐藏的黑色图表插件即可。随后拆解四个实战案例:用 PPT Skill 生成网页版 PPT、用图表插件做动态图表、用 AnySearch Skill 补足深度调研、用计划模式七步搭建个人工作台,并解释了上下文额度与压缩、agents.md 规则文件等关键概念。最后归纳出 Skill 固化流程、插件扩展边界、API 补足专业度、计划模式管理复杂任务四项通用能力。
Codex 是 OpenAI 推出的 AI 编程工具,但很多人装完之后的第一反应是——然后呢?B站 UP 主「数字生命卡兹克」发布了一期号称「全网最适合文科生」的 Codex 新手教程,从下载安装到接入国内大模型,再到 PPT、动态图表、深度调研、工作台四个实战案例,几乎覆盖了普通人用 AI 编程工具的高频场景。这篇文章把视频中的核心信息拆解整理,适合零技术背景的读者快速上手。
安装三步走:下载、安装、接大模型
Codex 现在已经和 ChatGPT 合并,直接搜索 Codex 就能找到下载入口,安装包会根据你的操作系统自动匹配版本。装好后需要登录 ChatGPT 账号,但国内用户用不了 GPT,所以关键一步是把「脑子」换成国内大模型。
UP 主打了个比方:大模型是大脑,负责思考和规划;Codex 是手脚,负责执行和落地。两者分离之后,需要 CC Switch 这个转换工具来桥接。在 CC Switch 的工具栏里选中 Codex,再添加 DeepSeek广告 作为供应商,填入从 DeepSeek 平台获取的 API Key,点击启用即可完成切换。
切换成功后还有一个容易被忽略的设置:打开用量查询并保存配置。这个面板会实时显示 Token 消耗,充值之后也能看到余额,UP 主把它叫做「赛博雪条」——随时知道自己花了多少钱。
API Key 是什么:API Key 是一串由大模型服务商生成的密钥字符串,相当于你调用该服务的「身份证 + 付费卡」。Codex 本身不产生智能,它需要把对话内容发给大模型后端,而这个请求必须携带 API Key 才能被服务商识别和计费。因此把 Codex 接到 DeepSeek 时,必须先在 DeepSeek 开放平台注册账号、创建 Key 并充值,再把 Key 填入 CC Switch。Key 一旦泄露,他人可以冒用你的额度消费,所以不要把它贴到公开仓库或聊天群里。
CC Switch 的作用:CC Switch 是一个本地配置切换工具,它并不代理模型请求,而是帮你改写 Codex 的配置文件,把默认指向 OpenAI 的地址替换成第三方兼容接口。这也是为什么切换供应商后需要「启用」——本质上是让 Codex 在下次启动时读取新的配置。
界面与必装插件:裸机要先装「左右手」
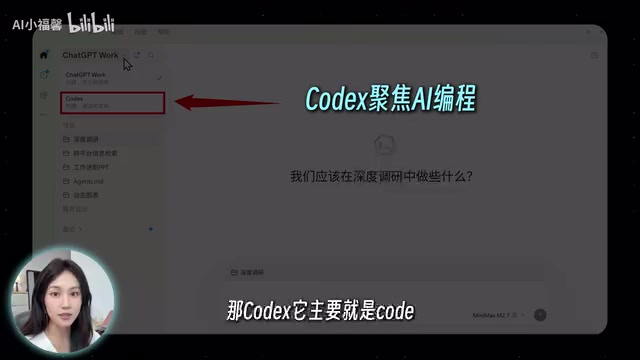
Codex 主界面左上角有两个模式:ChatGPT Work 和 Codex。Work 偏向办公场景,做表格、写文档都可以;Codex 模式则聚焦 AI 编程。根据任务类型灵活切换即可。
刚装好的 Codex 是裸装状态,需要先装插件和技能(Skill)。插件相当于外接工具箱,让 Codex 能调用外部工具或数据库;技能更像操作手册,让 Codex 按照固定流程干活。
必装插件有两个。第一个是 Computer Use,装完之后 Codex 可以调用你电脑里的 App,自动截图、读取窗口内容都靠它。第二个是做可视化图表的黑色插件,UP 主特别提到它在改版后从公开界面消失了,只能通过搜索找到,但实测效果远好于其他同类插件,做动态图表一次成功。
其余插件 UP 主基本没装——插件不是越多越好,大部分普通人根本用不到。
插件与 Skill 的区别:插件(Plugin)和技能(Skill)在 Codex 里是两套不同的扩展机制。插件面向「能力」,通常以 MCP(Model Context Protocol)服务的形式存在,给 Codex 增加它能调用的外部工具,比如操作浏览器、读取数据库、控制本机应用;Skill 面向「流程」,一般是一份 Markdown 写成的操作手册加配套资源,告诉 Codex 遇到某类任务时该按什么步骤、用什么模板。简单说,插件决定 Codex「能不能做」,Skill 决定它「做得像不像样」。这也是为什么做 PPT 要先装 Skill,而做动态图表要先装插件。
案例一:用 Skill 做 PPT
第一个案例用 AI 博主张杂拉开源的 PPT Skill,内含 34 个高颜值模板。操作流程是:切到 Work 模式,新建项目并绑定本地文件夹,让 Codex 获得该文件夹的完全访问权限,这样所有对话和资料都会归档到项目里,方便后续查找。
接着从 GitHub 复制该 Skill 的地址,让 Codex 安装,并约定「后续制作 PPT 时请调用这个 Skill」。正式制作时,先让 AI 整理好 PPT 文案并上传为附件,再给出指令:调用指定模板,根据内容合理运用和扩充模板样式,内容太长可以分批制作。
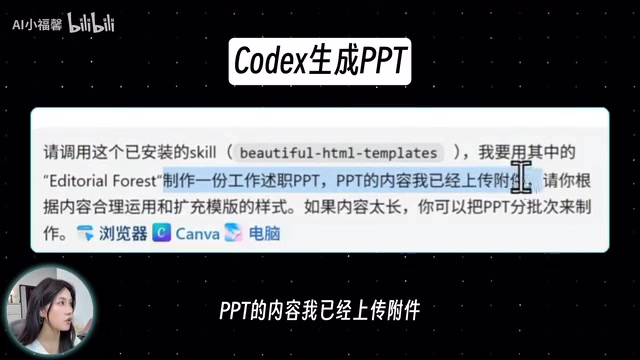
UP 主强调这一版提示词调整了四五遍,是实测效果最好的版本。生成结果是一个本地网页格式的 PPT,只能在本机打开,发给别人是打不开的。做汇报时要么直接投屏,要么让 Codex 把网页部署上线。
案例二:用插件做动态图表
动态图表是 UP 主试过多个方法后才跑通的场景,最终靠前面提到的那个黑色图表插件一次成功。流程是:Work 模式新建项目,上传数据表格,提示词要求「在保证数据正确性的前提下,充分考虑数据可视化的美观度,匹配合适的动态图表样式」,然后在加号菜单里选中已安装的图表插件再发送。
生成完成后如果不知道文件存在哪,直接问 Codex 要路径,复制到文件夹地址栏回车就能打开。同样是网页格式,同样可以继续对话微调细节。
案例三:深度调研靠 Skill 补深度
用 AI 检索信息常见的毛病是「太泛、深度不够」。UP 主推荐安装 AnySearch 这个辅助搜索 Skill,同样复制 GitHub 地址让 Codex 安装,并约定后续深度调研时自动调用。
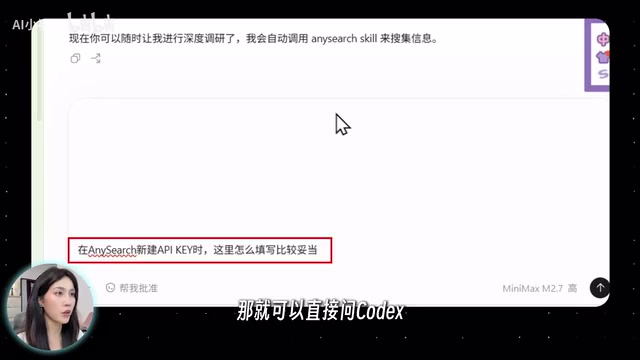
安装后 Codex 会提示配置 API Key 以获得更好的调研效果。在 AnySearch 官网注册后新建 API Key,需要填名称和配额。配额拿不准怎么办?UP 主直接把这个问题抛给 Codex,Codex 通过 Computer Use 插件自动截图当前页面,给出保守的配额建议(10000)。
拿到 Key 后发给 Codex 即可。这里 UP 主顺带解释了一个新手常见困惑——上下文额度。每个项目像一个有页数上限的笔记本,每轮对话都会记录在案,Codex 每次回复前都要从头读一遍。聊得太久笔记本写满,就会出现话没说完直接结束的情况。解决办法有两个:点分叉开新对话(相当于加空白页),或者输入斜杠调用「压缩」功能,把前面的对话打包压缩。UP 主实测压缩后上下文占用从 73% 降到 14%。
上下文窗口与压缩:大模型的上下文窗口指的是单次对话中它能「看见」的 token 总量上限,包括系统提示、历史对话、上传的文件和即将生成的回复。Codex 每轮回复前都要把整个项目的历史重新送进模型,所以对话越长,占用越高,触及上限时就会截断或报错。斜杠调用的「压缩」功能,本质是让模型把早期对话总结成一段更短的摘要,替换掉原文,从而腾出空间;开新分支则是保留原对话、另起一条干净的会话线。两者都只能缓解,不能突破模型本身的窗口上限,因此复杂项目仍建议按阶段拆分项目。
案例四:七步搭建个人工作台
最后一个案例用 Codex 的计划模式搭建内容团队的项目管理工作台。计划模式适合「你根本没想清楚」的复杂任务,让 AI 先帮你规划再执行。整个过程分七步:
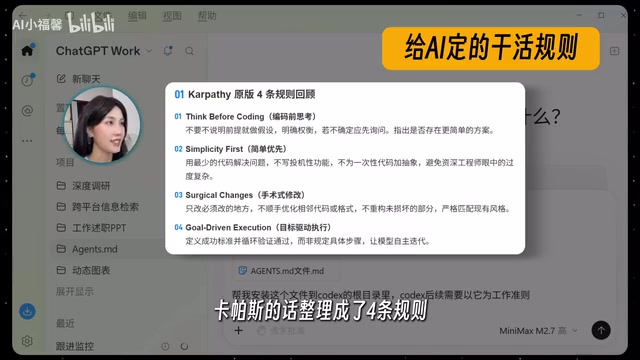
第一步,定规则。 在 Codex 根目录创建 agents.md 项目指令文件,相当于给 AI 定下的干活规则,每次开工前 Codex 都会先读它。UP 主提到,有人把 AI 圈大神 Karpathy 的四条规则整理进这类文件,让 AI 编程的错误率从 41% 降到 11%。UP 主把这四条规则发给 Codex,让它针对新手做了调整。
第二步,讲需求和痛点。 说清楚自己是干什么的、业务是什么、遇到什么问题、希望 AI 做什么,并强调在正式编程前先把需求理清楚,要求 AI 提出专业意见,避免一上来就写代码。同时打开计划模式,让 Codex 拆解任务、列出问题清单。
第三步,锁定 MVP。 最小可用产品,先只做一个核心功能(比如工作计划表),其余环节后续迭代,别一口气吃成胖子。
第四步,产出需求文档、技术文档和 demo。 demo 一定要做,可以提前看到界面长什么样、怎么交互,提前验收和反馈。
第五步,正式 AI 编程。 切到 Codex 模式,把需求文档、技术文档、demo 一起发过去。
第六步,测试和迭代。 自己大量测试,发现问题直接让 Codex 改,满意后进入第二轮加功能。
第七步,部署上线。 只给自己用可以跳过;要给团队用就必须部署到公网。
agents.md 与规则文件:agents.md 是一种约定俗成的项目级指令文件,放在仓库根目录,Codex 每次开始工作前会自动读取。它和你在对话框里临时提的要求不同——后者只对当前会话生效,而 agents.md 是持久化的「员工手册」,会约束之后所有对话。常见的写法包括:技术栈与目录约定、禁止改动的文件、提交前必须运行的测试、代码风格要求等。Karpathy 那四条规则之所以有效,核心在于把「先想清楚再动手」「小步修改可验证」这类工程纪律写成了 AI 每次都必须遵守的硬约束,而不是靠用户反复提醒。
MVP 与计划模式:MVP(最小可用产品)指只保留一个核心闭环、能跑通即可的初版,目的是尽早拿到可验收的东西。计划模式则让 Codex 在写代码前先输出任务拆解和问题清单,等你确认后再执行,避免方向跑偏后大量返工。两者配合,正好对应「先做对的事,再把事做对」。
四个案例背后的通用能力
回看这四个案例,其实对应的是 AI 编程工具的四项核心能力:用 Skill 固化流程(PPT)、用插件扩展边界(动态图表)、用 API 补足专业能力(深度调研)、用计划模式管理复杂任务(工作台)。UP 主在视频里反复说的一句话是——功能点不需要死记硬背,掌握这四个高频场景,就能举一反三套用到自己的需求上。对于零基础用户来说,这可能是比背快捷键更实际的入门路径。
相关推荐
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。
GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率
gpu-unlock 项目探索 Nvidia 3000 系显卡在 FP16/BF16 计算上的指令发射率限制,本文解读其测量方法、解锁思路、社区争议以及对 GPU 性能优化的实际意义。