COILD:以印度语言为核心的机器翻译平行语料库与基准

COILD 是首个以印度语言为核心、含116万条人工校验句对的平行语料库,旨在突破印度语言机器翻译的数据瓶颈。
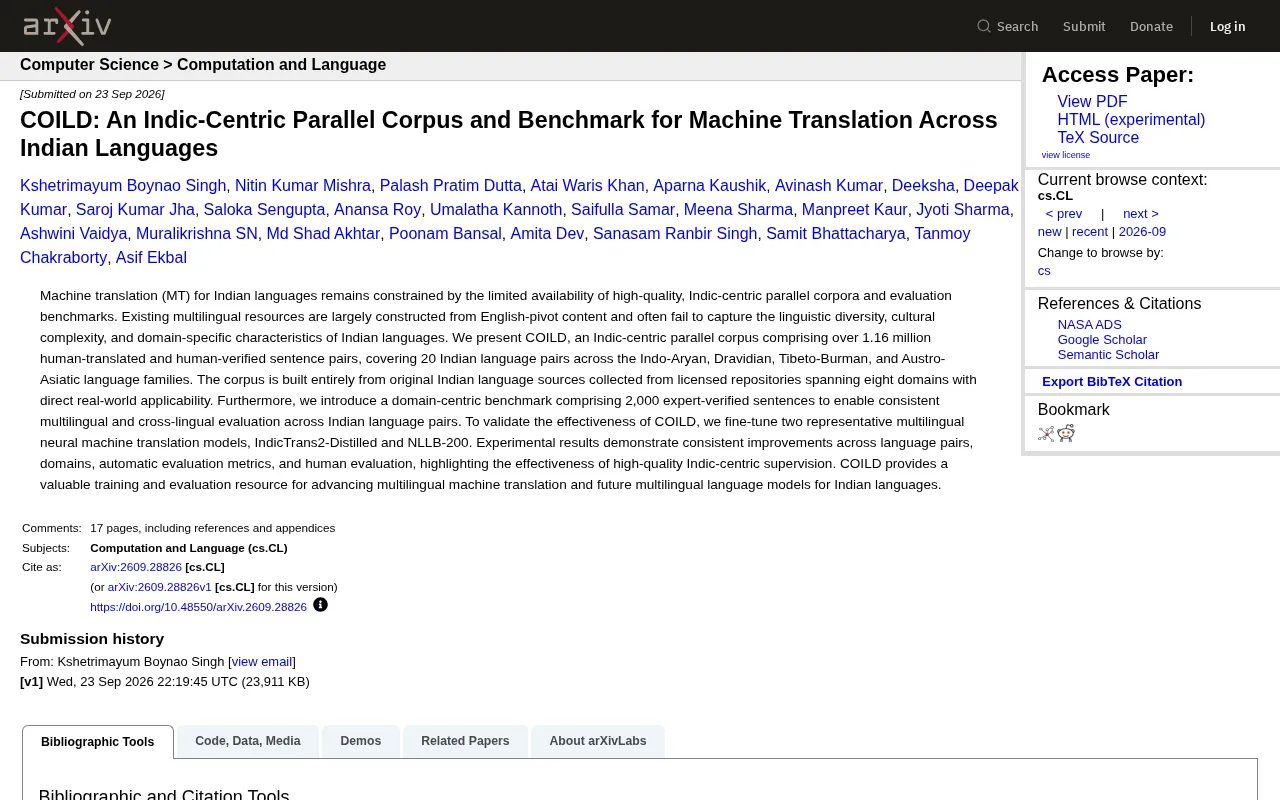
印度语言机器翻译长期受困于两大瓶颈:缺乏高质量平行语料库,以及缺乏可靠评测基准;且现有资源多以英语为枢纽构建,丢失了原生语言的文化与语境信息。为此,研究团队推出 COILD——一个真正以印度语言为核心的平行语料库,包含超过 116 万条人工翻译并校验的句对,覆盖 20 个语言对和四大语系,数据跨越八个贴近现实的领域。配套的 2000 句专家校验评测基准则填补了跨语言一致性评估的空白。在 IndicTrans2-Distilled 和 NLLB-200 两个代表性模型上的微调实验证明,COILD 在自动指标与人工评测中均带来一致提升,为低资源印度语言的多语言 AI 研究提供了重要的基础设施。
印度语言机器翻译的长期困境
机器翻译技术在过去数年间取得了长足进步,但这种进步在不同语言之间的分布极不均衡。对于印度语言而言,高质量翻译资源的匮乏一直是难以逾越的障碍。研究者在最新论文中指出,印度语言的机器翻译长期受制于两个瓶颈:缺乏高质量、以印度语言为核心的平行语料库,以及缺乏合适的评测基准。
更深层的问题在于现有资源的构建方式。当前大多数多语言资源都是以英语为枢纽(English-pivot)构建的——先把内容翻译成英语,再从英语转译到目标语言。这种做法看似高效,却往往丢失了印度语言本身的语言多样性、文化复杂性以及领域特定的表达特征。换句话说,用英语作为中介翻译出来的印度语言文本,可能在语法上正确,却在文化语境和真实使用场景中显得生硬。
平行语料库(Parallel Corpus)是机器翻译的核心训练材料,指由源语言句子与其对应目标语言翻译共同组成的双语对齐数据集。神经机器翻译模型需要大量此类数据才能学习语言之间的对应规律。对于英语、中文、法语等"高资源语言",互联网上存在海量的双语新闻、法律文件、字幕等天然平行语料;但印度多数地方语言缺乏这类大规模数字化双语资源,导致模型训练数据严重不足,翻译质量远落后于主流语言。这种资源分布不均的现象在 NLP 领域被称为"低资源语言"问题,是当前多语言 AI 研究的核心挑战之一。
COILD 语料库:规模与覆盖
为了突破这一瓶颈,研究团队推出了 COILD,一个真正以印度语言为核心(Indic-centric)的平行语料库。它的规模相当可观:包含超过 116 万条经过人工翻译和人工校验的句对,覆盖 20 个印度语言对。
这些语言对横跨四大语系——印度-雅利安语系(Indo-Aryan)、达罗毗荼语系(Dravidian)、藏缅语系(Tibeto-Burman)以及南亚语系(Austro-Asiatic)。这种跨语系的覆盖尤为重要,因为印度的语言多样性极高,不同语系之间的语法结构和表达习惯差异巨大,单一来源的语料很难兼顾。
与依赖英语枢纽的做法不同,COILD 完全从印度语言的原始素材构建而来,数据取自获得授权的语料库,并覆盖八个与现实应用直接相关的领域。这意味着语料不仅规模大,而且贴近真实使用场景,减少了英语中介带来的文化和语境偏差。
领域导向的评测基准
有了训练数据还不够,如何一致地评估翻译质量同样关键。COILD 因此配套引入了一个以领域为中心的评测基准,包含 2000 条经过专家校验的句子。
这个基准的价值在于它支持跨印度语言对的多语言和跨语言一致性评估。在过去,不同研究往往使用各自的测试集,导致结果难以横向比较。一个统一、经过专家审核的基准,能够为后续研究提供可复现、可对比的标准,这对整个领域的健康发展意义重大。
实验验证:微调带来一致提升
为验证 COILD 的实际效果,研究团队选取了两个具有代表性的多语言神经机器翻译模型进行微调:IndicTrans2-Distilled 和 NLLB-200。这两个模型分别代表了印度语言专用模型和通用多语言模型的路线。
实验结果显示出一致的提升——无论是在不同语言对、不同领域,还是在自动评测指标和人工评测中,微调后的模型都取得了改进。这种跨维度的一致性提升是一个有说服力的信号,说明改进并非来自某个特定测试集的偶然,而是高质量、以印度语言为核心的监督数据带来的普遍收益。
值得关注的是人工评测与自动指标的双重验证。机器翻译领域常见的问题是自动指标(如 BLEU)与实际翻译质量脱节,而 COILD 的实验同时依赖两类评估,增强了结论的可信度。
BLEU(Bilingual Evaluation Understudy)是机器翻译领域最广泛使用的自动评测指标,通过计算机器译文与参考译文之间的 n-gram 重叠比例来量化翻译质量,分值范围为 0 到 100。BLEU 的优点是计算高效、可大规模复现,但其局限性同样显著:它对同义词替换、语序变化不敏感,有时无法反映译文的流畅度和语义准确性,与人类判断的相关性在形态丰富的语言(如印度诸语言)上尤为薄弱。因此,COILD 实验同时引入人工评测,由双语评估者对译文的忠实度和流畅度打分,两类评估结果的一致性能更有力地支撑语料库有效性的结论。
对多语言 AI 的意义
COILD 的贡献不止于提供一批训练数据。它为推进印度语言的多语言机器翻译,乃至未来的多语言大语言模型,提供了一份兼具训练与评测价值的资源。
在大模型时代,数据质量对模型能力的影响愈发凸显。对于长期处于低资源状态的印度语言而言,一个规模超百万、人工校验、跨语系覆盖的语料库,有望成为后续研究和产品开发的重要基础设施。它所倡导的"摆脱英语枢纽、回归原生语言"的构建思路,对其他低资源语言的研究同样具有借鉴意义。
IndicTrans2-Distilled 是专为印度语言设计的神经机器翻译模型,由 AI4Bharat 研究团队开发,支持二十余种印度语言与英语之间的互译,是目前印度语言机器翻译领域的主流基线模型之一。NLLB-200(No Language Left Behind)则是 Meta AI 于 2022 年发布的通用多语言翻译模型,覆盖全球 200 种语言,旨在为低资源语言提供基础翻译能力。选取这两类模型进行对比实验,既能检验 COILD 对印度语言专用架构的增益,也能评估其对通用多语言模型的迁移价值,使实验结论具有更广泛的适用性。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。