CollabSciReM:科学对话对齐新框架,分解奖励破解LLM科研协作难题

CollabSciReM 将科研对话奖励拆为质量、严谨性与效率三维,匹配长度下胜率达65.3%。
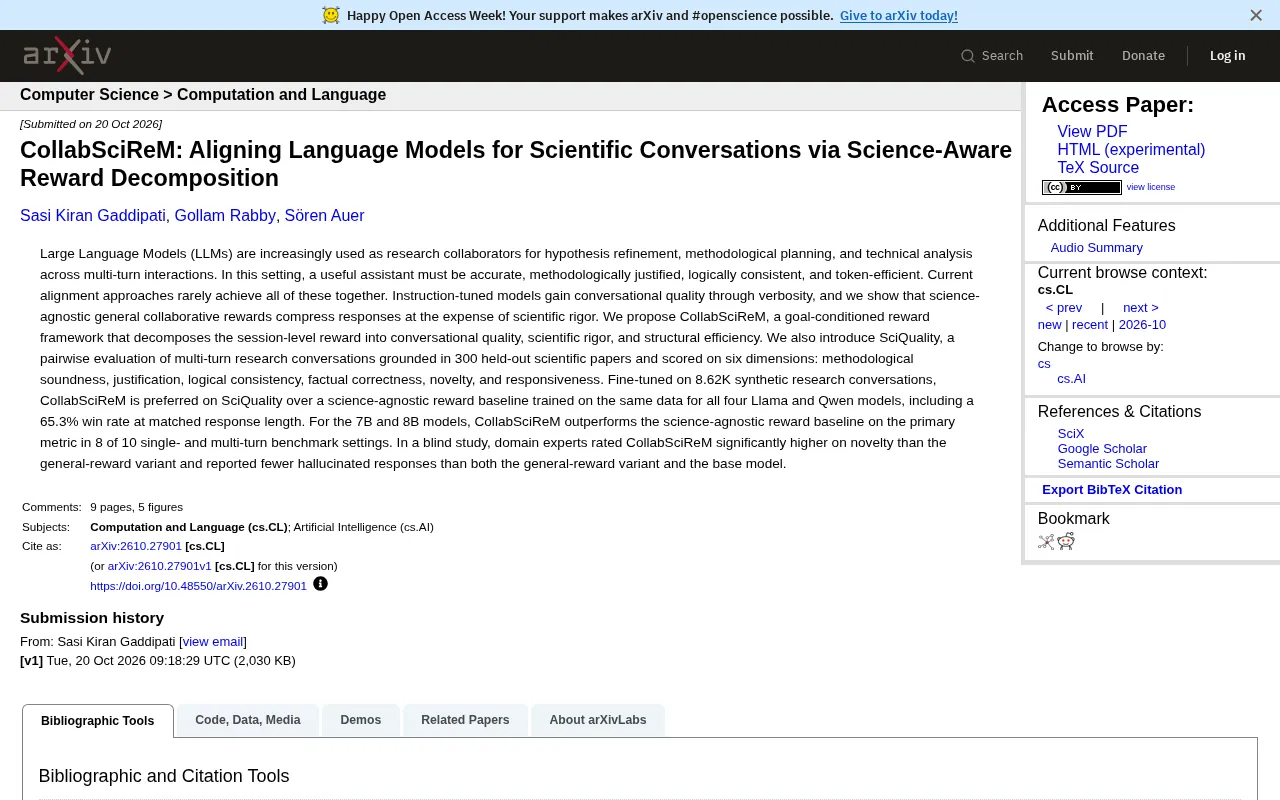
大型语言模型在科研协作中需要兼顾准确、严谨、逻辑自洽与简洁,但现有对齐方法常顾此失彼。CollabSciReM 框架将模糊的会话级奖励分解为对话质量、科学严谨性和结构效率三个可独立优化的分量,避免单一奖励信号在不同目标间被迫妥协。研究团队基于 300 篇留出论文构建 SciQuality 六维成对评测集,并在 8.62K 条合成科研对话上微调模型。实验显示,在响应长度匹配条件下,CollabSciReM 对科学无关奖励基线取得 65.3% 胜率;7B/8B 模型在 10 个基准设置中 8 个主指标超越基线;专家盲测亦显示其新颖性更优、幻觉更少。
大型语言模型正从通用聊天工具演变为科研协作伙伴,但要让它们在多轮科学对话中同时做到准确、方法严谨、逻辑自洽且不啰嗦,现有对齐方法往往顾此失彼。一项新研究提出 CollabSciReM 框架,通过将奖励分解为对话质量、科学严谨性和结构效率三个维度,在多项评测中显著优于科学无关的通用奖励基线。
当LLM成为科研合作者,对齐面临三重矛盾
研究团队指出,LLM 在假设细化、方法规划和技术分析等场景中承担着越来越重的角色。一个合格的科研助手需要同时满足四个条件:事实准确、方法论有据、逻辑一致、token 使用高效。
然而现有对齐方案存在结构性缺陷。指令微调模型倾向于用冗长换取对话流畅度,而科学无关的通用协作奖励虽然能压缩回答长度,却以牺牲科学严谨性为代价。这种"按下葫芦浮起瓢"的困境,正是 CollabSciReM 试图解决的核心矛盾。
奖励分解:把会话级信号拆成三个可独立优化的目标
CollabSciReM 的核心设计是一个目标条件化的奖励框架,将原本模糊的会话级奖励拆解为三个明确分量:
- 对话质量:追踪多轮交互中的连贯性与响应性
- 科学严谨性:考察方法论合理性、论证充分性与事实正确性
- 结构效率:控制冗余表达,鼓励 token 高效利用
这种分解方式的价值在于,它避免了单一奖励信号在不同目标之间被迫妥协。研究团队同时构建了 SciQuality 评测集——基于 300 篇留出科学论文构造多轮研究对话,并从方法论可靠性、论证充分性、逻辑一致性、事实正确性、新颖性和响应性六个维度进行成对评估。
目标条件化奖励(Goal-Conditioned Reward) 是强化学习与对齐中的常见设计:奖励函数不直接给出单一标量,而是以任务目标为条件,分别计算不同维度的得分,再按预设权重或约束组合。其优势在于让模型可以针对不同目标分别优化,避免一个笼统的“好回答”信号模糊掉具体维度上的要求。在 CollabSciReM 中,目标条件化体现为对话质量、科学严谨性和结构效率三个可独立评估的分量,训练时通过加权或约束方式整合为最终奖励,从而让模型在多个目标间取得更可控的平衡。
成对评估(Pairwise Evaluation) 是当前 LLM 评测的主流范式之一:给定同一输入下的两个模型回答,由评审器(自动模型或人类专家)判断哪一个更好,而非直接打绝对分数。成对比较降低了对评分量表的依赖,也更容易控制评审偏差。SciQuality 正是采用成对评估,从六个维度比较 CollabSciReM 与基线的回答。文中“65.3% 胜率”即来自成对比较中 CollabSciReM 被判定更优的比例;胜率显著高于 50% 表明优势并非随机波动。
实验证据:匹配长度下65.3%胜率
研究团队在 8.62K 条合成科研对话上微调模型。结果显示,在全部四个 Llama 和 Qwen 模型上,CollabSciReM 在 SciQuality 评测中均优于同等数据训练的科学无关奖励基线。
关键数据是:在响应长度匹配的条件下,CollabSciReM 取得 65.3% 的胜率。这一数字排除了"靠更长回答刷分"的可能,说明提升来自内容质量本身。对 7B 和 8B 模型而言,在 10 个单轮与多轮基准设置中,CollabSciReM 在 8 个设置的主指标上超过基线。
盲测环节提供了另一层佐证:领域专家认为 CollabSciReM 在新颖性上显著优于通用奖励变体,同时报告的幻觉回答少于通用奖励版本和基础模型。
响应长度匹配(Length-Matched Comparison) 是针对“奖励黑客”的一种控制手段。由于人类评审和自动评审都倾向于给更长的回答更高分,若不加控制,模型可能通过堆砌冗余内容来提升胜率,而非真正改善质量。长度匹配要求在比较时只选取长度相近的回答对,或对长度差异进行统计校正,从而把“长度效应”从质量差异中剥离。CollabSciReM 在长度匹配条件下仍取得 65.3% 胜率,说明其优势来自科学内容本身,而非回答更长。
多源交叉验证下的共识与分歧
该研究的结论在多个独立评测路径上得到相互印证。SciQuality 自动成对评估、10 项标准基准测试和专家盲测三条证据链指向同一方向——科学感知的奖励分解确实带来了可测量的质量提升。据论文描述和 SciQuality 评测数据,模型规模在 7B 至 8B 区间的四款模型均呈现一致趋势,这种跨模型族的一致性增强了结论的可信度。
需要诚实指出的是,目前公开信息主要来自研究团队自身的评测设计,SciQuality 作为新提出的评测集尚缺乏第三方独立复现。合成对话数据(8.62K 条)与真实科研协作场景之间的分布差异,也是后续需要验证的维度。
留出论文(Held-out Papers) 指在构建评测集时,从模型训练数据中排除、未参与训练的科学论文。用留出论文构造对话,可以避免模型因“见过原文”而表现出虚高的流畅度或事实 recall,使评测更接近真实科研场景中的新问题。SciQuality 基于 300 篇留出论文生成多轮研究对话,正是为了保证评测样本对被测模型而言是未见过的,从而更可信地衡量其科学对话能力。
对科研AI工具开发的启示
CollabSciReM 的思路提示了一个更普遍的方向:面向专业领域的对齐不应沿用通用对话的奖励设计。当用户期待模型给出方法论上站得住脚的判断时,用"像不像人聊天"作为优化目标会系统性偏离需求。把严谨性拆成可独立度量的分量,并显式约束效率,是一种值得借鉴的工程路径。对构建科研辅助工具的产品团队而言,SciQuality 的六维评价框架本身也可作为内部质量评估的参考模板。
论文标题:CollabSciReM: Aligning Language Models for Scientific Conversations via Science-Aware Reward Decomposition
相关推荐
AI工程师的职责变了:从写代码到构建智能体工厂
Arize AI的Aparna Dhinakaran在AI Engineer大会分享AI工程师角色转变:从写功能到构建智能体循环,详解Signal始终在线智能体的触发、沙箱、记忆与评估器评估机制,以及追踪一切的数据飞轮。
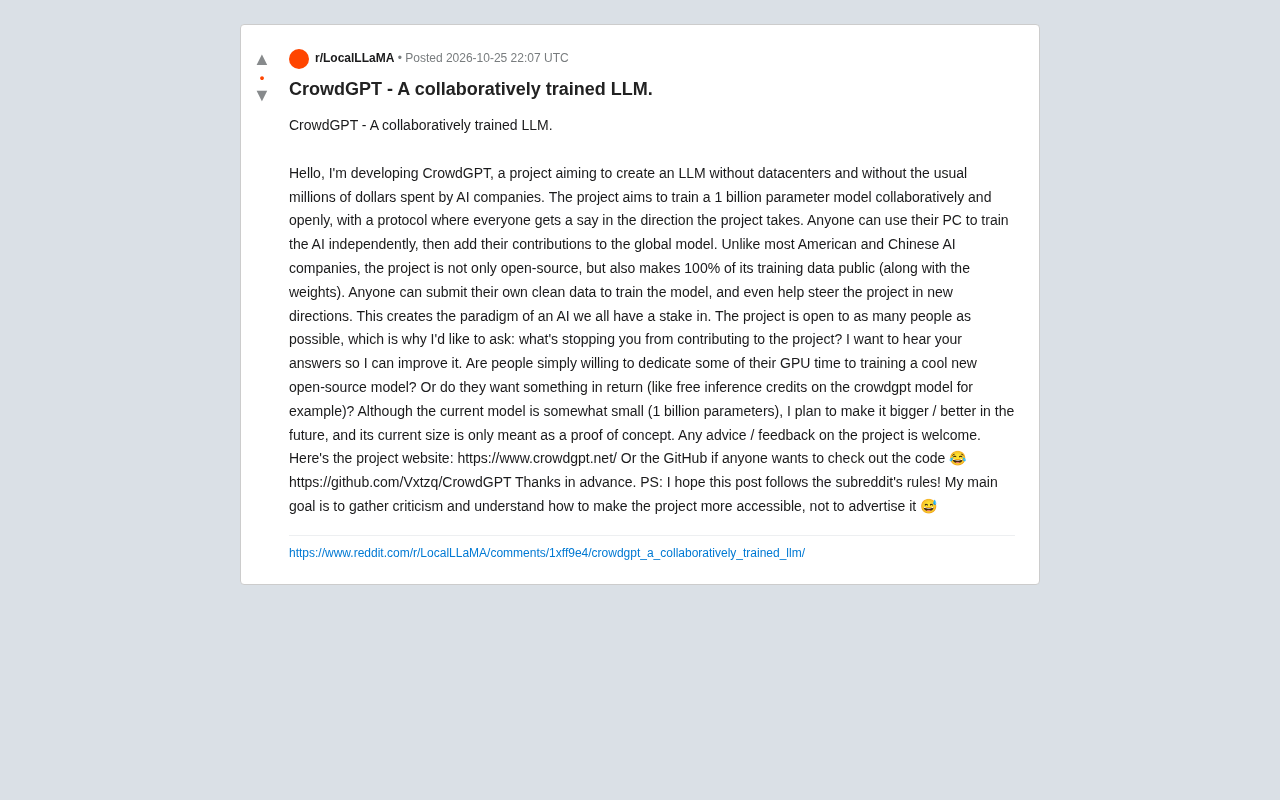
CrowdGPT:去中心化协作训练LLM的野心与挑战
CrowdGPT项目试图通过全球志愿者协作训练10亿参数开源LLM,公开全部训练数据和权重。本文分析其去中心化训练模式的技术挑战、社区激励机制及与主流开源模型的差异。
Apollo报告:AI在科技业外“零财务回报”
Apollo研究指出AI在科技行业之外尚未带来可量化的财务回报。本文分析资本开支与收益错配、组织变革滞后、财务计量盲区三大原因,并探讨对企业和AI从业者的启示。