Compute:Arena:社区众包的本地AI性能基准测试平台
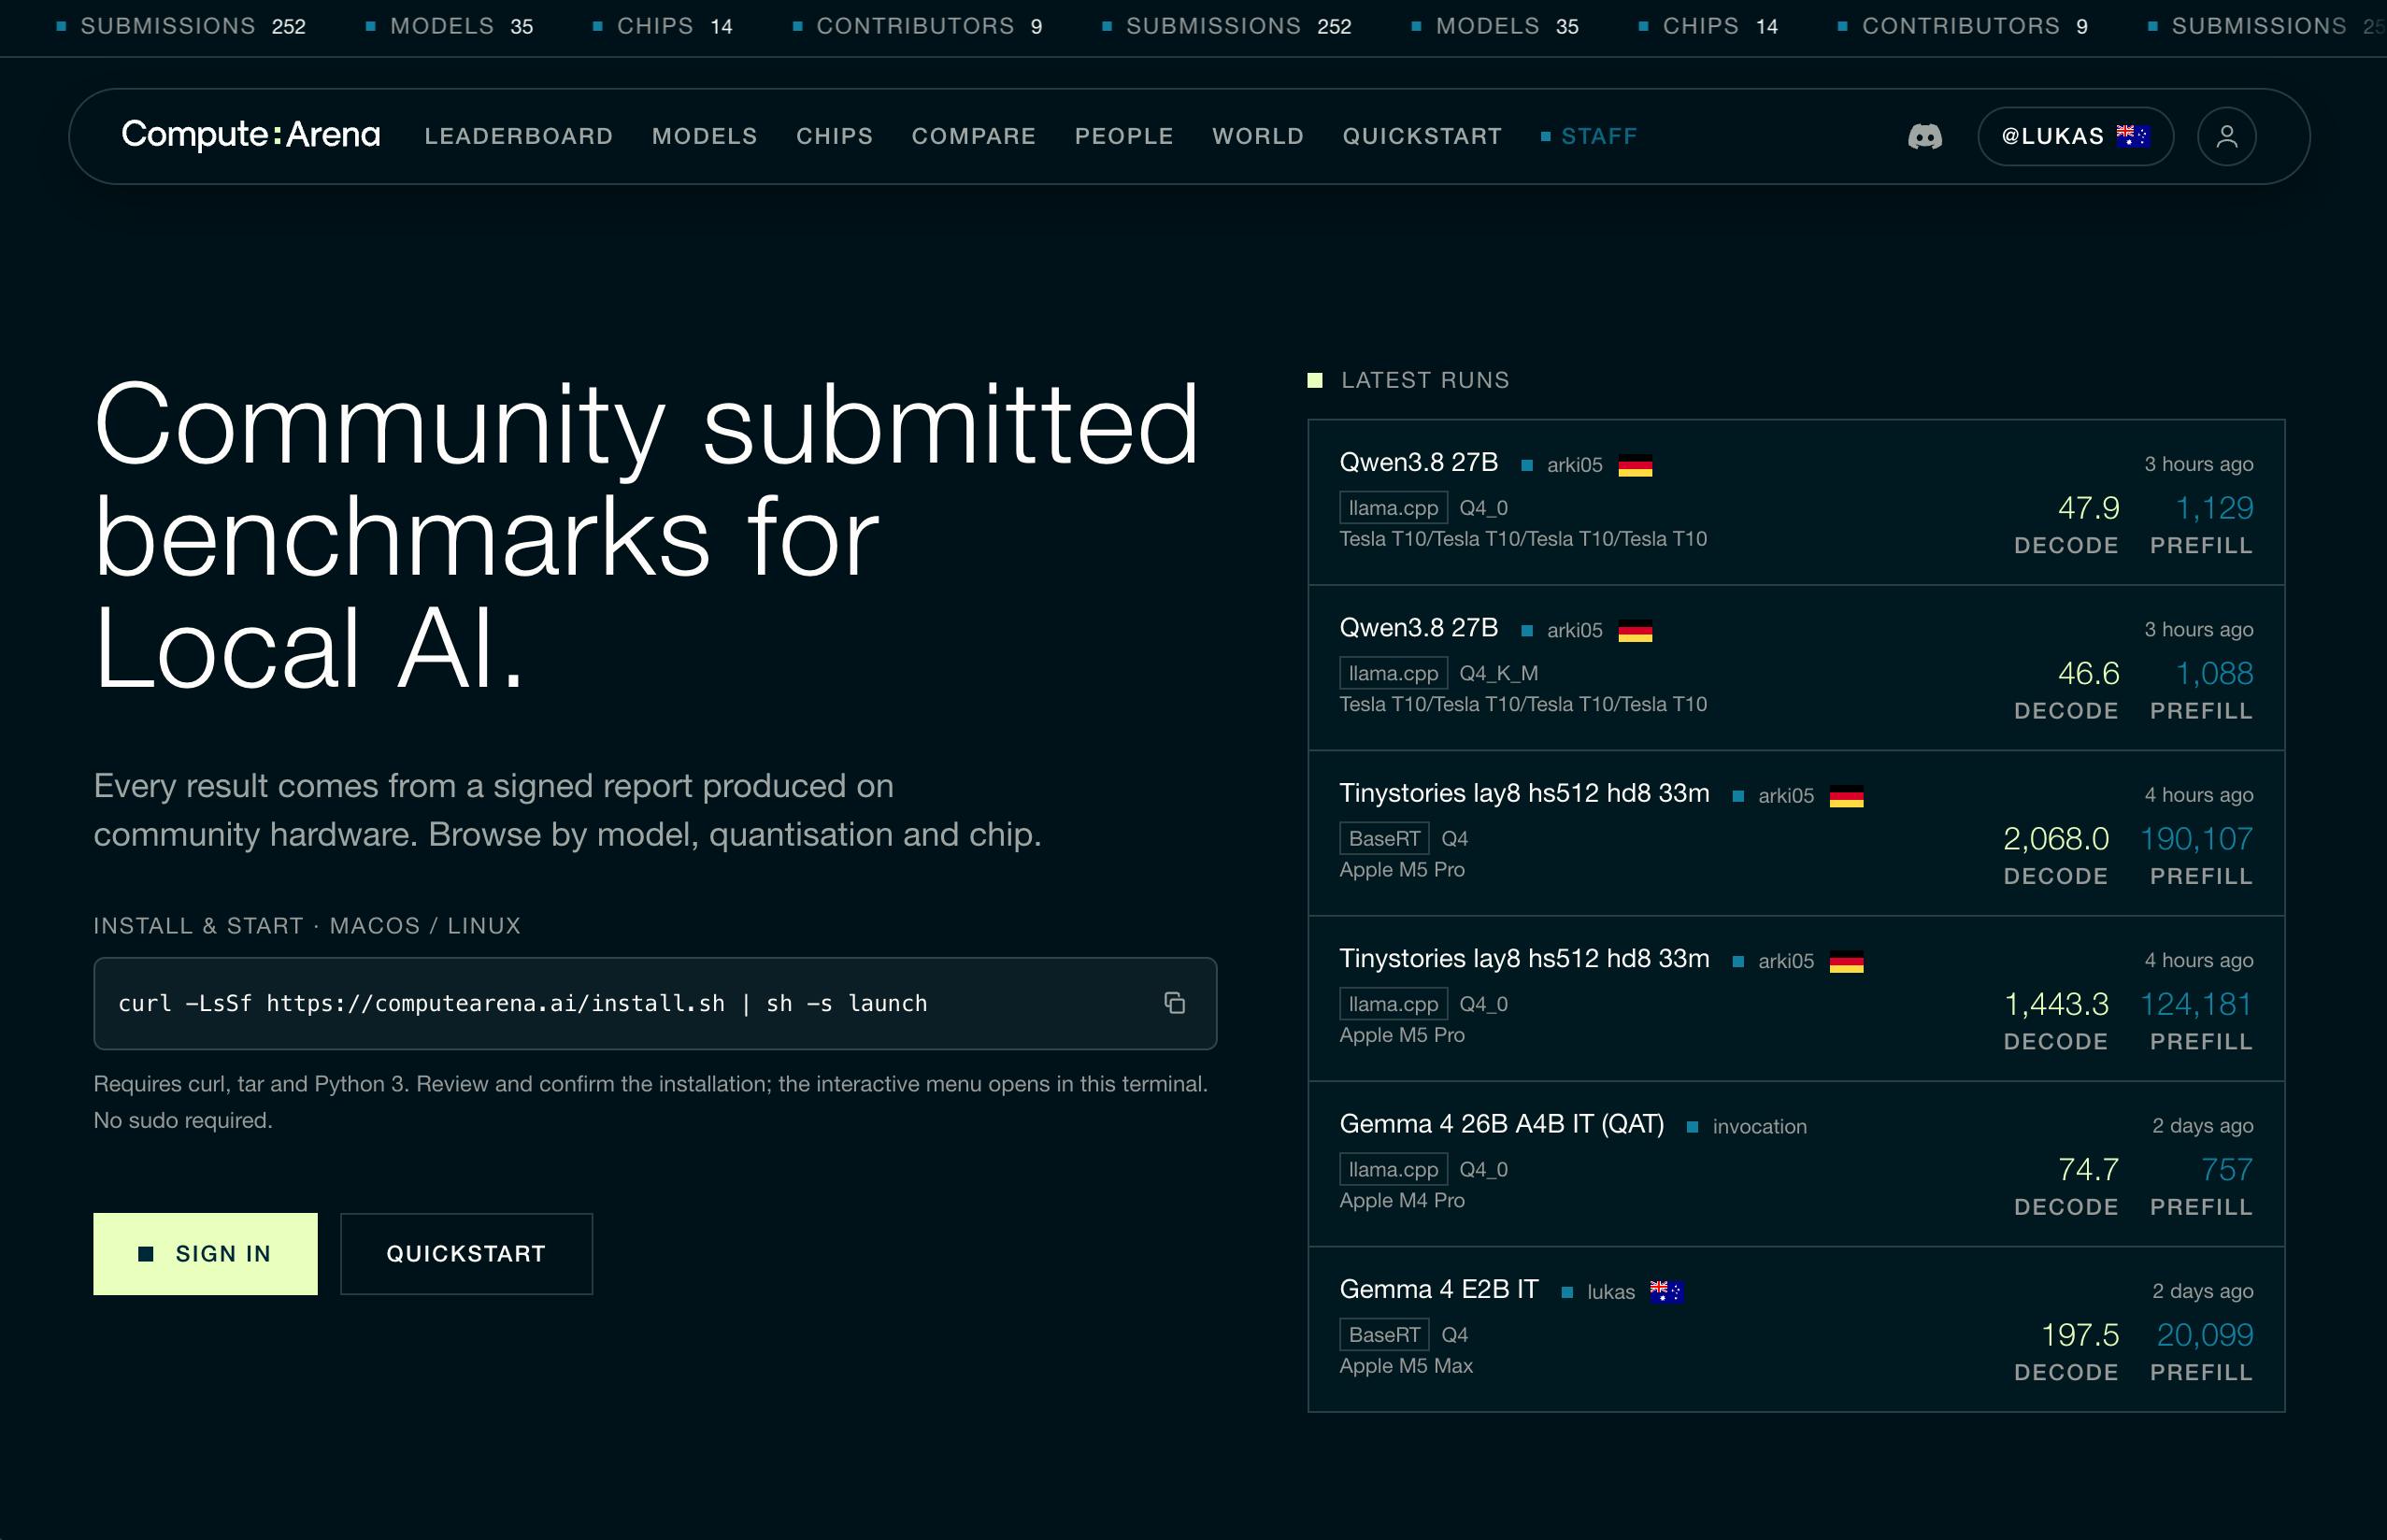
Compute:Arena 用社区众包方式汇聚本地AI模型在不同硬件与量化方案下的实测性能数据。
本地AI模型的性能因硬件、运行时和量化方案的不同而差异显著,但社区中的测试数据长期零散且难以横向比较。Compute:Arena 以开源、众包的方式切入这一痛点,搭建一个可检索、可比较的本地AI性能基准数据库,覆盖消费级显卡、Apple Silicon 等多样化硬件,以及 llama.cpp、Ollama、MLX 等主流运行时。其开源属性保障了测试方法的透明与可复现性,Apple 标签则暗示平台对 M 系列芯片本地推理场景有专门关注。产品目前登陆 Product Hunt 获 74 票,仍处于早期阶段,最终价值取决于能否建立严格的提交规范并形成持续贡献的社区生态。
本地运行AI模型正成为越来越多开发者和爱好者的选择,但一个绕不开的问题始终存在:同样一个模型,在不同硬件、不同运行时、不同量化方案下,到底能跑多快?Compute:Arena 试图用社区众包的方式来回答这个问题。
一个由社区驱动的本地AI基准库
Compute:Arena 的定位相当明确:为本地AI模型提供社区提交的性能基准,覆盖任意硬件、任意运行时、任意量化方案。它于近期登陆 Product Hunt,获得 74 个投票,位列当日榜单第 17 名,被归类在开源、人工智能、GitHub 与 Apple 等标签之下。
这个定位背后有一个现实痛点。当你想在自己的机器上跑一个大语言模型时,社区里的性能数据往往零散且不可比——有人在 M2 Max 上测,有人用 RTX 4090,有人跑 Q4 量化,有人跑 Q8,运行时可能是 llama.cpp、Ollama 或 MLX。缺乏统一的收录口径,就意味着你很难在购买硬件或选择配置前得到可靠参考。Compute:Arena 想做的,正是把这些散落各处的实测数据汇聚成一个可检索、可比较的公共数据库。
为什么“众包”是关键
本地AI硬件生态的多样性,注定了任何一家团队都无法覆盖全部测试组合。消费级显卡、Apple Silicon 各代芯片、不同代际的 CPU,再乘以数十种模型和多种量化精度,排列组合的数量极其庞大。
众包模式的价值就在这里:让真正拥有这些硬件的用户上传自己的实测结果,用群体的力量填补覆盖盲区。这种思路与游戏领域早已成熟的硬件跑分社区颇为相似——单点测试永远不如海量真实用户数据来得全面。对于打算搭建本地推理环境的人来说,一个足够丰富的众包基准库,能直接影响硬件采购与量化策略的决策。
开源属性带来的想象空间
从 Product Hunt 的分类标签看,Compute:Arena 带有明显的开源与 GitHub 属性。开源意味着基准测试的方法、数据口径乃至提交流程都可能对外透明,这对基准测试类产品尤为重要——只有测试方法可复现、可审计,社区提交的数据才具备横向可比性。
值得关注的是其中包含 Apple 标签,暗示平台对 Apple Silicon 平台的本地推理场景给予了专门关注。随着 M 系列芯片在统一内存架构下展现出的本地大模型运行能力,这一细分方向的基准数据需求正在快速增长。
Apple Silicon 的统一内存架构(Unified Memory Architecture,UMA)是其在本地大模型推理中表现突出的关键原因。传统 PC 架构中,CPU 与 GPU 拥有各自独立的内存池,数据在两者之间传输会产生带宽瓶颈;而 M 系列芯片将 CPU、GPU、Neural Engine 共享同一块高带宽内存,模型权重无需跨总线复制即可被 GPU 直接访问。这意味着即便是消费级的 M2/M3 MacBook,也能以较低延迟在本地运行参数量达 70B 的量化模型。MLX 正是苹果官方专门为这一架构优化的机器学习框架,与 llama.cpp 的 Metal 后端共同构成了 Apple Silicon 本地推理的主要技术路径。这一细分场景的性能数据目前在社区中尤为稀缺,也解释了 Compute:Arena 为何对 Apple 平台给予专门标注。
目前能确认与仍待观察的
受限于当前公开信息,Compute:Arena 更多呈现的是一个清晰的产品愿景与定位,而具体的数据规模、测试标准化程度、社区活跃度等关键指标还有待进一步验证。产品页面目前评论数仅为 1,说明它仍处于早期阶段。
对这类社区驱动的工具而言,成败往往取决于两点:一是能否建立起足够严格且易于执行的提交规范,保证数据质量;二是能否形成正向循环,让贡献者持续上传新硬件、新模型的测试结果。如果这两点跑通,Compute:Arena 有机会成为本地AI社区的一个实用基础设施。
小结
Compute:Arena 抓住了本地AI浪潮中一个真实而具体的需求——用统一、开放、众包的方式解决“我的硬件到底能跑多快”的问题。它的开源与社区属性让人对其透明度和覆盖广度抱有期待。对于正在评估本地推理方案的开发者和爱好者,这是一个值得加入书签、持续观察的项目。
背景补充
量化(Quantization)是本地推理场景中影响性能的核心变量之一。它指的是将模型权重从高精度浮点数(如 FP32、FP16)压缩为低精度整数(如 INT8、INT4)的过程,以此换取更小的内存占用和更快的推理速度,代价是一定程度的精度损失。常见的量化方案如 Q4_K_M、Q8_0 等来自 GGUF 格式的命名体系,不同方案在同一硬件上的吞吐量差异可达数倍。与此同时,llama.cpp、Ollama、MLX 等运行时对量化格式的支持和底层优化路径各不相同,这使得"同一模型、同一硬件"下的跨运行时对比同样复杂。正因如此,一个能够精确记录"模型 × 量化方案 × 运行时 × 硬件"四维组合的基准库,对有选择困难的用户具有切实的参考价值。
相关推荐
Fable 5.2灰度测试曝光:Anthropic或将超越GPT-6 Astra
Anthropic疑似灰度测试Fable 5.2和Opus 5.2,社区测试者称其推理能力超越GPT-6 Astra,但代价是更慢的生成速度与更高成本。本文梳理泄露细节、IPO商业博弈与AI安全叙事争议,并提醒相关信息未获官方证实。
免费调用 GPT-6 Astra:配合 Cline 实测生成 4 款 3D 游戏
详解如何免费试用 GPT-6 Astra 模型:通过 Zenslab 关联 Telegram 领取积分,配合 VS Code 的 Cline 扩展接入 API,实测生成烹饪游戏、战术射击及 Dust2 地图等 4 款 3D 游戏,并分析免费额度的实际能力与限制。
警惕第三方ChatGPT充值陷阱:三种方式的风险辨析
针对社交平台流行的第三方ChatGPT充值教程,本文客观辨析代充网站、境外信用卡直充、移动端内购三种方式的流程与风险,重点提示所谓"不给密码就安全"的误导性及封号隐患。