从2D显微图像推断3D细胞生物物理特性的群体监督框架

用群体监督框架从2D红细胞图像推断MCV/RDW/MCH等临床指标,并严格分析可识别性边界。
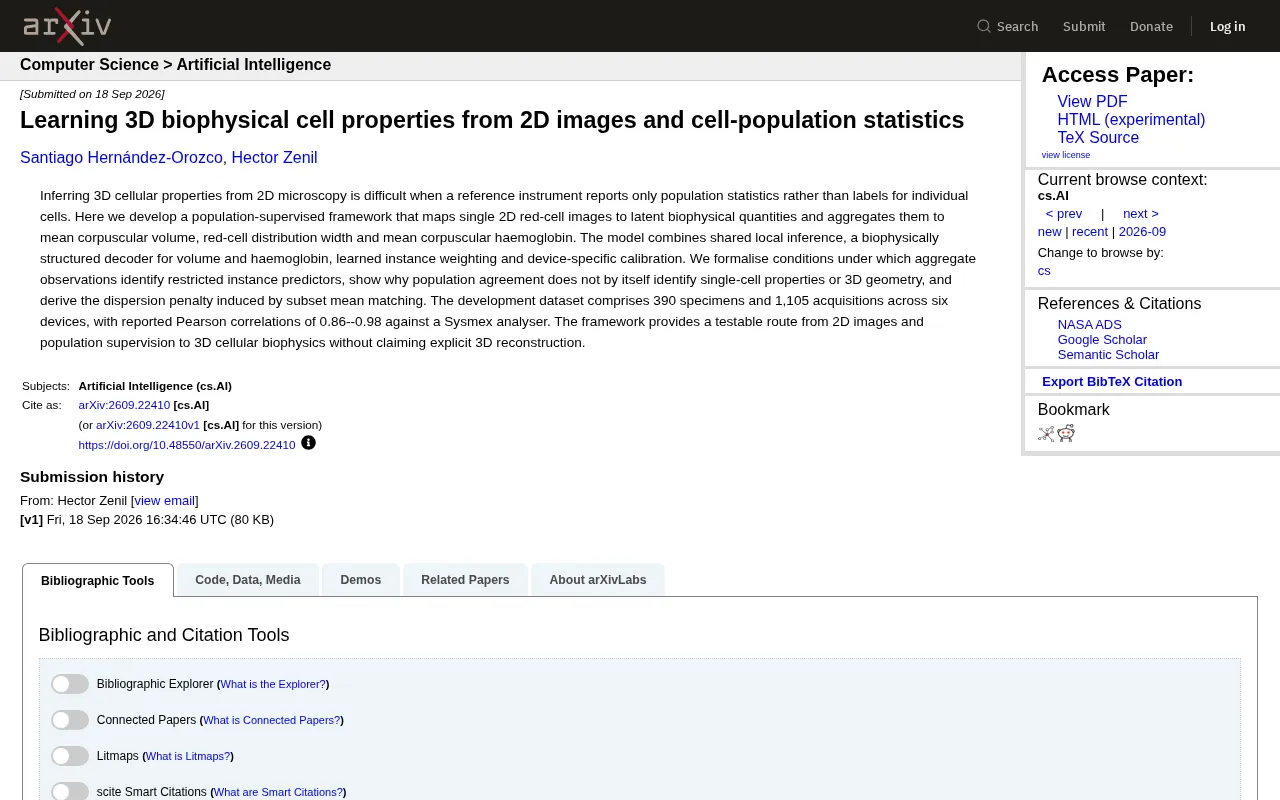
这项研究针对"参考仪器只输出群体统计、缺乏单细胞标签"的现实困境,提出了一套群体监督(population-supervised)框架,将单张二维红细胞显微图像映射到生物物理潜变量,再聚合为MCV、RDW、MCH等临床血液学指标。模型核心由生物物理结构化解码器、学习到的实例加权和设备特定校准三部分构成,在390份标本、六台设备的1105次采集上,与Sysmex分析仪的皮尔逊相关系数达0.86–0.98。更值得关注的是研究的理论层面:作者形式化分析了可识别性条件,并明确指出群体一致性不能单独证明单细胞属性或三维几何得到了准确重建,从而为这类弱监督范式划定了清晰的方法论边界。
研究背景:当参考仪器只给群体统计而非单细胞标签
从二维显微图像推断三维细胞属性一直是计算生物学中的难题。核心矛盾在于:临床和实验室常用的参考仪器(如Sysmex血液分析仪)通常只报告群体层面的统计量,而非单个细胞的标注数据。这意味着研究者手中缺乏可用于监督学习的单细胞真值(ground truth),传统的监督学习范式难以直接套用。
这项发表于arXiv的研究提出了一套群体监督(population-supervised)框架,试图绕过单细胞标注缺失的障碍,将单张二维红细胞图像映射到潜在的生物物理量,再聚合出临床关心的指标。
Sysmex血液分析仪是临床血液学中广泛使用的全自动血细胞分析设备,其工作原理基于电阻抗法(库尔特原理)和射频/激光散射技术,通过测量细胞通过微孔时引起的电信号变化来统计细胞数量与体积分布。仪器输出的是整份血样中数千乃至数万个细胞的聚合统计量,如MCV(均值)、RDW(分布宽度)等,而不会为每个细胞单独打标签。这种测量方式在临床上高效可靠,但对机器学习研究者而言,意味着无法直接获取"第i个细胞的体积=X fL"这类逐实例的监督信号。传统显微图像分析若想对接临床参考值,就必须跨越这道从"单细胞预测"到"群体统计"的鸿沟,这正是本研究所要解决的核心工程与理论问题。
方法框架:从单细胞映射到群体聚合
该框架的核心逻辑是先在单细胞层面进行推断,再聚合到群体统计量上,用群体级别的观测作为监督信号。整个模型由几个关键组件构成:
共享局部推断与生物物理解码器
模型对每张二维红细胞图像进行共享的局部推断,提取潜在的生物物理量。特别之处在于它设计了一个生物物理结构化解码器(biophysically structured decoder),专门用于估计细胞体积(volume)和血红蛋白含量(haemoglobin)。这种把物理约束嵌入解码器的做法,有助于让潜在表示对应到有实际意义的生物量,而非纯粹的黑箱特征。
实例加权与设备校准
框架还引入了学习到的实例加权(learned instance weighting)和设备特定校准(device-specific calibration)。前者允许模型对不同单细胞样本赋予不同权重,后者则应对多台设备之间的系统性差异——这在真实的多设备采集场景中至关重要。
最终,单细胞层面的估计被聚合为三项临床指标:平均红细胞体积(MCV)、红细胞分布宽度(RDW)和平均红细胞血红蛋白量(MCH)。
MCV(平均红细胞体积)、RDW(红细胞分布宽度)和MCH(平均红细胞血红蛋白量)是全血细胞计数(CBC)中的核心红细胞参数,在临床上用于贫血分类与鉴别诊断。MCV反映红细胞平均大小,正常范围约80–100 fL,偏低提示小细胞性贫血(如缺铁),偏高提示大细胞性贫血(如叶酸/B12缺乏);RDW衡量细胞大小的离散程度,升高提示红细胞大小不均一(异形红细胞增多);MCH则反映每个红细胞携带的血红蛋白绝对量,与细胞体积及血红蛋白浓度共同决定携氧能力。这三项指标均为群体统计量,恰好契合本研究所能提供的聚合预测输出,也是选择它们作为验证目标的临床依据。
理论贡献:群体一致性能识别什么,不能识别什么
这项工作在方法论上的一个亮点是它没有停留在工程实现,而是对**可识别性(identifiability)**进行了形式化分析。研究者明确给出了在何种条件下,聚合观测能够识别受限的实例预测器(restricted instance predictors)。
更重要的是,作者诚实地指出了这一范式的边界:群体层面的一致性本身并不能识别单细胞属性或三维几何结构。换句话说,即使模型在群体统计上与参考仪器高度吻合,也不能据此断言它准确重建了每个细胞的真实三维形态。研究还推导了由子集均值匹配(subset mean matching)所引入的离散度惩罚(dispersion penalty),这为理解模型行为提供了理论支撑。
这种对方法局限性的坦诚,恰恰是该研究值得称道的地方——它明确声明不主张显式的三维重建,而只是提供一条从二维图像与群体监督通向三维细胞生物物理的可检验路径。
可识别性(identifiability)是统计学与机器学习中的基础概念,指模型参数能否从可观测数据中被唯一确定。在传统监督学习中,逐样本标签通常保证了模型的可识别性;但当监督信号仅来自群体聚合(如均值、方差)时,可识别性条件会大幅收窄。直觉上,相同的群体统计量可以由无数种不同的单细胞分布所生成——这被称为"聚合不可逆"或"生态学谬误"的技术背景。该研究通过形式化分析明确了在施加何种约束(如参数族的限制)后,聚合观测才能唯一确定受限的实例预测器。这一分析的意义在于:它不仅为模型设计提供了理论保障,也诚实地划定了方法的上限——对于超出这些约束条件的单细胞属性,群体监督原则上无法提供可靠的推断依据。
实验数据与验证结果
开发数据集规模包括390份标本、跨越六台设备的1,105次采集。在与Sysmex分析仪的对比中,模型报告的皮尔逊相关系数达到0.86至0.98。
这一相关性区间对于仅依赖群体监督、且不使用单细胞标注的方法而言相当可观。它表明,通过合理的结构设计和聚合监督,模型确实能捕捉到与临床血液学指标高度相关的生物物理信息。跨六台设备的验证也在一定程度上说明框架具备设备间的泛化与校准能力。
意义与展望
这项研究的价值不仅在于血液学应用本身,更在于它提出了一种可推广的弱监督推断范式:当我们只有群体统计而无个体标签时,如何在保持理论严谨的前提下推断个体属性。
对于医学影像、细胞组学乃至更广泛的科学测量场景,这种"从聚合观测反推个体量"的思路具有借鉴意义。同时,作者对可识别性边界的清晰界定,也为后续研究划出了值得警惕的陷阱:群体拟合良好 ≠ 个体推断准确。未来若能引入部分单细胞真值进行半监督校验,或结合真正的三维成像数据做验证,这条路径的可信度将进一步提升。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。