从AdaBoost理解集成学习:弱模型如何组合成强模型
AdaBoost通过组合弱模型与动态错误传递,颠覆"单模型越强越好"的直觉,并与深度学习思想相通。
一位系统学习机器学习的学生在掌握AdaBoost后,感叹自己"离深度学习更近了",这一感受揭示了集成学习的核心颠覆性:我们不追求单个完美模型,而是让一群"犯错"的弱模型协同作战。AdaBoost的精髓在于权重的动态调整——被错误分类的样本获得更高权重,迫使后续弱学习器专注于前者遗留的难题,错误被逐级传递与攻克,最终融合出高准确率的强分类器。这套"协作、分工、迭代修正"的系统思维,与深度学习中简单神经元分层组合、反向传播逐层修正误差的哲学高度相通,使AdaBoost成为通向更复杂模型的重要认知台阶。学习建议方面,该学生的做法具有参考价值:先吃透理论直觉,再从零手写原始代码,并公开至GitHub接受社区审视,兼顾原理理解与作品集积累。
一位正在系统学习机器学习的学生在社区分享了他学习 AdaBoost 的感悟:当他完成这个算法的理论部分后,突然意识到自己离深度学习越来越近了。这个看似简单的分享,其实点出了集成学习中一个颠覆直觉的核心思想——我们不是在追求完美的模型,而是在利用一群"犯错"的弱模型。
为什么 AdaBoost 让人"开窍"
大多数机器学习初学者接触的第一批算法,无论是线性回归、逻辑回归还是决策树,核心目标都高度一致:最小化误差。模型越准越好,错误越少越好。这套逻辑简单直接,也符合人的常识。
但 AdaBoost 的思路完全不同。正如这位学习者所描述的:"在 AdaBoost 里,我们希望模型去犯错,然后把错误传递给下一个模型,它的错误又传给再下一个模型,不断调整权重。最终,一群从完全错误的预测开始的模型,竟然能给你最好的准确率。"
这种认知上的反差,正是很多人觉得 AdaBoost 是"思维转折点"的原因。它第一次让学习者意识到:单个模型的表现并不等于系统的最终表现。
AdaBoost 的核心机制:错误驱动的接力
AdaBoost(Adaptive Boosting,自适应提升)的运作方式可以理解为一场有策略的接力赛。
弱学习器的角色分工
AdaBoost 并不挑选"最强"的模型,而是收集许多不完美的弱模型(weak learners),通常是只比随机猜测稍好一点的简单模型(比如单层决策树,也叫决策树桩)。单看每一个,它们都很平庸,甚至经常出错。
关键在于:不同的弱模型擅长处理不同类型的错误。当它们被恰当地组合在一起时,各自的短板被互相弥补,整体就形成了一个强大的集成分类器。
决策树桩(Decision Stump)是 AdaBoost 中最常见的弱学习器形式,本质上是深度为 1 的决策树——仅对一个特征设置一个阈值,将样本一分为二。它的分类能力极其有限,在复杂数据集上的准确率往往只比 50% 高一点点。正因为如此简单,单个决策树桩几乎毫无实用价值;但在 AdaBoost 的框架下,数十乃至数百个决策树桩按权重叠加后,整体分类器的精度可以显著超越单棵深层决策树。这种"弱弱联合"的效果,在数学上由 Schapire 和 Freund 的提升理论(Boosting Theory)严格保证:只要每个弱学习器的准确率略高于随机猜测,组合后的错误率就会随迭代轮数指数级下降。
权重调整是灵魂
AdaBoost 的精髓在于权重的动态调整:
- 每一轮训练后,被错误分类的样本会被赋予更高的权重;
- 下一个弱学习器会把更多注意力放在这些"难搞"的样本上;
- 同时,表现更好的弱学习器在最终投票中拥有更大的话语权。
这样一轮一轮迭代下来,前面模型没能解决的难题,交给后面专门"盯着"这些难题的模型。错误被逐级传递、逐级攻克,最终融合成一个高准确率的整体。
从 AdaBoost 到深度学习的直觉联系
这位学习者直觉上感到"离深度学习更近了",这种感受并非偶然。虽然 AdaBoost 和神经网络在数学结构上差异巨大,但它们在某些思想层面确实存在共鸣:
组合简单单元构建复杂能力。深度学习同样是通过堆叠大量简单的神经元和层,让每一层学习不同层次的特征表达,最终组合出强大的表征能力。AdaBoost 用"弱分类器的组合",神经网络用"简单单元的分层组合",底层哲学相通。
误差的逐级传递与修正。AdaBoost 通过权重调整把错误信号往后传递;深度学习则通过反向传播把误差梯度逐层回传,不断修正参数。两者都把"从错误中学习"作为驱动力。
理解了集成学习中"多个组件协同"的思想,再去理解神经网络中层与层之间的协作,确实会顺畅不少。这也是为什么集成方法常被视为通向深度学习的重要台阶。
值得一提的是,AdaBoost 与深度学习的联系不止于直觉层面。梯度提升(Gradient Boosting)将 AdaBoost 的思想推广到任意可微损失函数,其核心操作——每一轮新模型拟合上一轮的残差——与神经网络反向传播中沿梯度方向修正参数在数学形式上高度类似。XGBoost、LightGBM 等现代提升框架正是沿着这条路发展而来,在结构化数据任务上甚至常常超越深度神经网络。因此,AdaBoost 不仅是深度学习的"思维台阶",也是通向整个梯度提升方法家族的入口,理解它的迭代修正逻辑,能为后续学习这些强大工具打下坚实基础。
从理论到代码:学习路径的实践建议
这位学习者的做法很值得借鉴:先看理论和直觉,理解透彻后再动手写原始代码(raw code),然后再逐步优化结构。他目前已经完成了一版基础实现,并计划进一步规范代码。
他还提到一个很好的学习习惯——打算把自己实现的所有 ML 算法整理上传到 GitHub,一方面作为自己的参考库,另一方面也开放给社区帮忙发现和修复 bug。
这种做法有几个明显好处:
- 从零手写算法比直接调库更能加深对原理的理解;
- 公开代码接受审视,能快速暴露自己思维中的盲点;
- 构建个人作品集,对后续求职或深造都有积累价值。
他坦言代码里"肯定有很多 bug",并且因为第一学期的大型实践考试在进行中,学习进度有所放缓。这其实也反映了多数学习者的真实状态:学习机器学习很少是一帆风顺的全职投入,更多是在课业和实践之间寻找节奏。
写在最后
AdaBoost 之所以常被当作机器学习学习路径上的一个"顿悟点",是因为它打破了"单个模型越强越好"的朴素直觉,引入了协作、分工、迭代修正的系统思维。而这套思维,恰恰是理解更复杂模型(包括深度神经网络)的重要基础。
对于正在学习 ML 的人来说,与其追求一次性掌握最前沿的大模型,不如像这位学习者一样,踏实地把经典算法的直觉吃透、动手实现、公开分享、迭代改进——这条路看起来慢,实际上离深度学习越来越近。
相关推荐
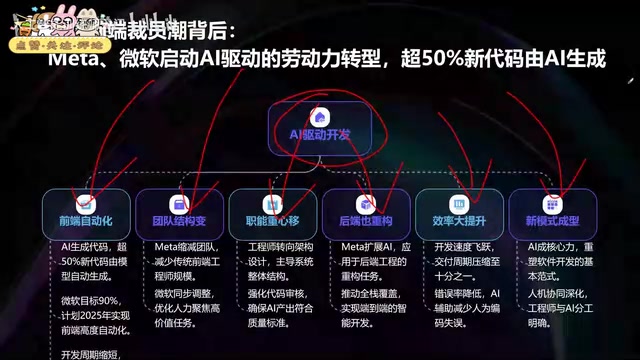
Vibe Coding全栈实战:AI编程从入门到企业级落地
从Cursor到Claude Code,这套B站AI编程实战课程以四个递进项目覆盖全栈开发、开源二次开发与团队协作。文章解析AI编程带来的前端岗位震荡、五人选五十人的效率变革,以及企业级项目所需的方法论。
大卫·布莱恩全球寻访真魔术:从南非到日本与印度
大卫·布莱恩在《Do Not Attempt》特辑中走访南非、日本与印度,记录Spinning车手、黑曼巴蛇保护者、居合术大师与苦行者的真实绝技,探讨魔术与人类极限挑战之间的边界。
触屏MacBook要来了?Vergecast爆料苹果高管回应
Vergecast播客披露记者与苹果高管John Ternus的对话,谈及触屏MacBook与Apple Pencil支持问题。Ternus回应称iPad才是手写笔最佳设备,记者则押注MacBook终将支持Apple Pencil。