CNN到Transformer:AI理解人类语言的进化之路
很多准备大模型岗位面试的技术人都有类似的经历:平时调接口、跑demo游刃有余,但面试官一问到Transformer的注意力机制、BERT与GPT的区别,立刻卡壳。这恰恰是「调包侠」和「算法工程师」的分水岭——工具和API天天在变,底层的逻辑架构却相对稳定。真正理解了这条进化路线,那些看似复杂的公式就无需死记硬背。
本文将沿着 CNN → RNN → Transformer 这条主线,把AI「学会理解人类」的进化故事完整串起来。你会发现,这条技术路线的演进逻辑,其实和人类的学习过程惊人地相似。
CNN:AI理解世界的起点
为什么AI很早就学会了「看图」(人脸识别、自动驾驶),却在自然语言处理上迟迟突破不了瓶颈?答案藏在图像与文本的本质差异里。
在电脑眼里,一张猫的图片就是一堆像素数字的排列。识别一只猫的关键在于抓住特征——尖耳朵、圆眼睛、胡须——而不在于它在画面的左边还是右边、是躺着还是坐着。对图像来说,关键在于特征,而非绝对位置。
文本则完全不同。「我吃苹果」和「苹果吃我」用的是同样的四个字,但顺序一调,意思就彻底反转。在语言里,顺序决定意义,它不是简单的特征堆砌,而是一条流动的、带上下文因果的信息链。
卷积与池化:像猎人一样扫描
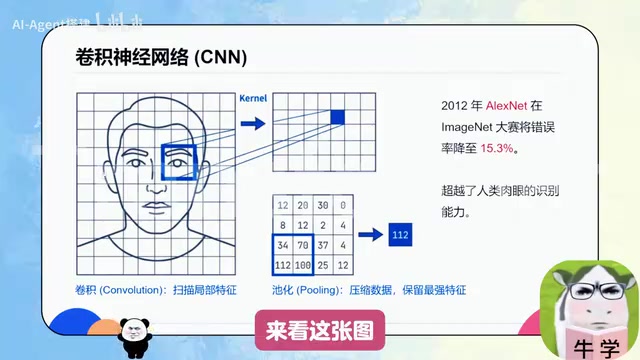
CNN(卷积神经网络)的工作方式,很像一个拿着放大镜的猎人。它用一个小窗口(卷积核)在图像上滑动扫描——某个窗口专门找眼睛,另一个负责找嘴巴,把局部特征逐一抓取出来。
接着是「池化」操作,本质就是压缩:四个格子的数字只保留最大的那个,像做笔记画重点一样,扔掉冗余信息,只留最强特征。
凭借「扫描+压缩」这套组合,2012年经典的AlexNet直接把图像识别错误率降到了15.3%,准确率甚至超过人类肉眼。那一刻,人们真切感受到「AI崛起了」。
背景知识:AlexNet与深度学习的奇点时刻
2012年的ImageNet竞赛是深度学习历史上真正的转折点。Alex Krizhevsky、Ilya Sutskever和「深度学习之父」Geoffrey Hinton提交的AlexNet,将图像识别错误率从26%骤降至15.3%,比第二名低了近11个百分点——这个差距震惊了整个学术界。这一成就背后,是GPU并行计算能力的首次大规模应用于神经网络训练,奠定了此后十年「算力即竞争力」的行业共识。值得一提的是,AlexNet的核心作者Ilya Sutskever后来成为OpenAI联合创始人兼首席科学家,直接参与了GPT系列的诞生——这条技术脉络在人物层面也形成了完整的历史传承。
CNN的致命缺陷:读不懂顺序
但当人们把这套图像处理思路移植到文字上时,问题暴露了。CNN本质是「词袋模型」——它只看局部特征,不管词在哪里。在CNN眼里,「我吃苹果」和「苹果吃我」摇一摇袋子,摇出来的都是同样三个词,根本分不清谁是主语谁是宾语。
这就是CNN的致命缺陷:它理解不了因果逻辑。 用它做出来的语言模型,就像一只记性不好的鹦鹉,能蹦出几个字,却连不成一句人话。
RNN:给AI装上「记忆」
既然问题出在顺序上,专门处理序列的RNN(循环神经网络)便登场了。这里的「循环」意味着它不是直来直去,而是有记忆的。
RNN的核心思想,很像人一边读书一边在脑子里记笔记。读到「我」,它把信息存下来;读到「吃」时,它不仅看当前的字,还会回头看刚才存的「我」,从而生成新的理解——「原来是我在吃」;最后读到「苹果」,再结合前面得出完整意思。
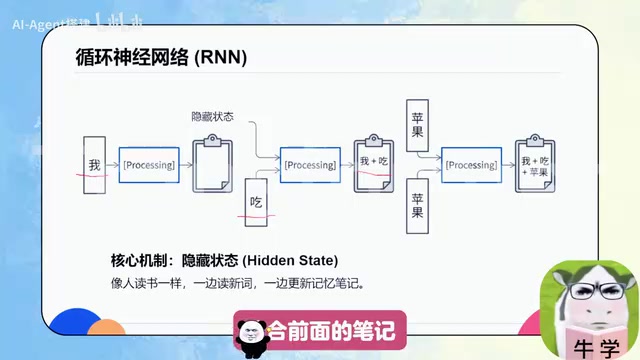
这个「记笔记的小本子」,技术上叫做隐藏状态(hidden state)。凭借它,RNN终于能分清「我吃苹果」和「苹果吃我」的区别。早期机器翻译、情感分析,基本都靠RNN扛大旗。
RNN的两大硬伤
然而RNN身上有两个硬伤,严重限制了它的上限:
第一,无法并行,速度极慢。 RNN像坐火车排队过安检——要算第二个词,必须先算完第一个词;要算第1000个词,得等前面999个全排完队。它没法像CNN那样把所有输入一次性并行计算,导致在海量数据面前根本跑不动。
第二,长距离依赖(健忘症)。 信息一层层传递会逐渐衰减。短句子还好,但如果一篇长文章开头写「Alice拿着钥匙」,中间隔了上千字,等模型读到最后的「他」时,早就忘了主角是谁。所以RNN写短句尚可,一写长文就开始胡言乱语。
背景知识:LSTM与GRU——RNN的补丁方案
为了缓解RNN的「健忘症」,研究者在1997年提出了LSTM(长短期记忆网络),2014年又简化出GRU(门控循环单元)。LSTM引入了「遗忘门」、「输入门」和「输出门」三套阀门机制,让模型自主学习「哪些信息值得长期保留、哪些可以丢弃」——本质上是给隐藏状态装了一个有选择性的过滤器。LSTM一度是NLP领域的标配,谷歌翻译在2016年大规模切换至LSTM架构后翻译质量大幅提升。但即便如此,LSTM仍无法根本解决串行计算慢的问题,这也是Transformer最终取代它的核心原因。
又慢、记性又差——AI的自然语言处理能力,就这样卡在了瓶颈上。
Transformer:Attention is All You Need
2017年,谷歌甩出了改变历史的论文——《Attention is all you need》,提出了全新架构 Transformer。它把复杂的循环、卷积统统扔掉,只保留一个核心武器:注意力机制(Attention Mechanism)。这篇论文基本宣告了自然语言处理进入新时代,也成了今天所有大模型(ChatGPT、DeepSeek广告等)的共同「祖宗」。
背景知识:一篇论文如何改变了整个科技行业
《Attention is All You Need》由Google Brain和Google Research的八位研究员联合撰写,发表于2017年NeurIPS会议。论文题目本身就是一个颇具挑衅性的宣言——它断言注意力机制一个工具就足以取代此前所有复杂的循环和卷积结构。这篇论文截至2024年引用次数已超过10万次,是人工智能领域有史以来被引用最多的论文之一。更值得关注的是,Transformer的影响力早已溢出NLP领域:图像处理的Vision Transformer(ViT)、蛋白质结构预测的AlphaFold2,乃至音乐生成、视频生成模型,底层都沿用了这套注意力机制,真正印证了「注意力就是一切」这个论断。
注意力机制:像人一样画重点
注意力机制其实在模仿人类阅读的习惯。当我们看到「我爱中国」,大脑不是死板地一个字一个字读,而是瞬间抓重点、建联系。
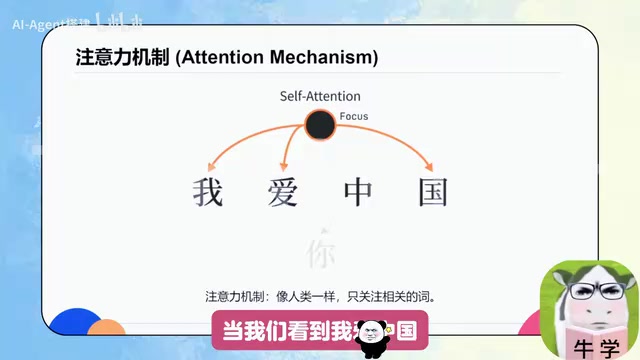
看到「爱」,大脑会自动追问:谁爱?——「我爱」关系紧密,打高分;爱谁?——「中国」强关联,打高分。机器由此学会了像人一样只关注相关的词,而非眉毛胡子一把抓。
深入理解:Q-K-V三元组的数学直觉
注意力机制的核心计算涉及三个向量:Query(查询)、Key(键)和Value(值),这套设计脱胎于信息检索系统的数据库查询逻辑。直觉上可以这样理解:对句子中的每个词,模型都会提出一个问题(Query),然后扫描所有词的「标签」(Key),计算匹配程度后加权提取对应的「内容」(Value)。计算匹配度时用的是点积(dot product),再除以维度的平方根做缩放防止数值过大,最后经过softmax归一化得到注意力权重。这套「Q-K-V」三元组的设计极为通用,几乎所有后续大模型(BERT、GPT、LLaMA)都在此基础上演进,而非另起炉灶。
并行计算 + 位置编码:双管齐下
注意力机制还顺手解决了RNN的速度难题。它计算的是词与词之间的关联程度,不需要串行等待,可以把「我爱中国」四个字一次性全部扔进去同时计算——相当于把「单窗口办事」变成了「多窗口同时办公」,计算速度提升了好几个量级。这才是大模型能吞下海量数据进行训练的基础。
但并行计算带来一个新问题:所有词一起算,顺序不就乱了吗?Transformer的设计者想出了位置编码(Positional Encoding)。每个进入模型的词都发一张「座位号」:「我」是1号、「爱」是2号、「中国」是3号。输入模型的数据是「词义 + 位置」打包在一起的,这样既有并行的速度,又通过号码牌记住了谁前谁后。
抓重点用注意力,提速度用并行,保顺序用位置编码——这套组合拳彻底让AI从蒙昧走向了精通语言。
BERT与GPT:Transformer的两大流派
Transformer后来分化出两大流派。BERT 只用了Transformer的编码器(Encoder),专练理解;大名鼎鼎的 GPT 只用了解码器(Decoder),专练生成(创作)。理解BERT与GPT的区别,是大模型学习的核心关卡之一。
BERT:双向理解的阅读者
BERT最大的特点是双向注意力。比如填空「他在___吃午饭」,BERT既能看左边的「他在」,也能看右边的「吃午饭」,像通读了全文再推断,判断出可能是「公司/家里/餐厅」。
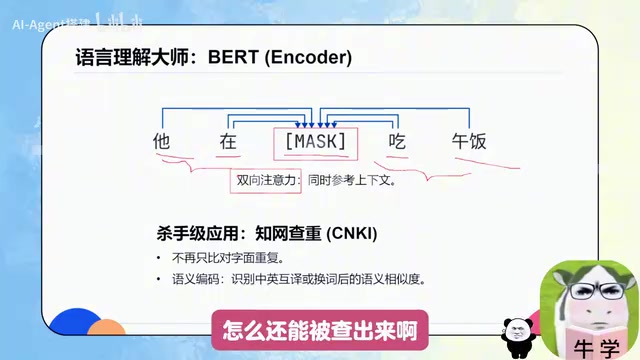
这项技术离我们的生活很近。写过毕业论文的人对知网查重都不陌生——查重系统升级后,把「随着经济发展」改成「伴随经济腾飞」照样能被查出来。原因就在于系统已用BERT去读懂句义,换个词但意思没变,它照样认得。简单的洗稿从此行不通了。
GPT:单向生成的创作者
GPT的思路则完全相反。写文章不能一下子看结尾,所以它只有单向注意力。写「我今天要去___」时,它只能看前面、不能看后面。为防止「偷看答案」,工程师加了一道掩码机制(Mask),把未来的词挡住,让它只能根据已有的词去猜下一个——可能是公司、商场或电影院——猜完一个再猜下一个。这正是GPT输出格外流畅的原因:它模拟了人类一个字一个字往下写的逻辑。
预训练 + 微调 + 大力出奇迹
GPT靠的是「预训练 + 微调」的组合拳。预训练(Pre-training) 阶段把互联网上几乎所有书籍、网页、论文喂给它,学会通用语法与常识,相当于读完九年义务教育加大学通识课;微调(Fine-tuning) 阶段则针对具体任务专项喂料——想让它审合同就喂法律文档,想让它写代码就喂GitHub代码——相当于岗前专业培训。
背景知识:「预训练 + 微调」的产业经济学
这套范式不只是技术方案,更是改变AI产业格局的商业逻辑。预训练大模型的成本极为高昂——GPT-3的单次训练成本估计超过460万美元,这使得只有少数科技巨头或融资充足的初创公司才能独立完成。但微调的门槛却远低于此:企业只需准备数百到数千条高质量的领域数据,花费数十美元即可在云平台上完成微调,获得一个「懂行」的专业模型。这种「基础设施由大厂建,应用层由中小玩家开发」的生态分层,催生了今天围绕GPT、Claude、LLaMA等基础模型的庞大应用开发市场,也是AI创业热潮的底层逻辑所在。
方法论定了,剩下就是拼规模。早期GPT参数量仅一亿多,只能写点简单的短句;到GPT-3飙升至1750亿参数,科学家惊讶地发现:当参数量大到一定程度,模型突然「开窍」了——不仅能写诗、写代码,甚至具备了逻辑推理能力,这被称为「涌现(Emergence)」;到GPT-4,规模更大,还能读懂图片。
背景知识:「涌现」现象的争议与意义
「涌现(Emergence)」在学界至今仍有争议。2022年谷歌的研究论文首次系统描述了这一现象:模型在参数量低于某个阈值时几乎不具备某项能力,但一旦超过阈值,该能力会突然出现并快速提升——就像水在99℃是液体,100℃突然沸腾。然而,斯坦福大学2023年的一篇论文提出质疑:「涌现」可能是测量方式的假象,换用平滑的评估指标后,能力提升其实是连续的而非突变的。这场争论至今未有定论,但无论涌现是否真实存在,大参数模型在复杂推理任务上的显著优势是客观事实,这也是各大科技公司持续投入「规模竞赛」的根本动力。
结语:一场长达十余年的技术接力
回望整条路线,AI并非一夜之间变聪明:它先在CNN学会了「看特征」,又在RNN学会了「记顺序」,最终靠Transformer的注意力机制真正学会了「理解与表达」。
所以,当你打开电脑让AI帮你写周报、做策划、生成图片时,不妨想到——屏幕背后是一场长达十多年的技术接力,是无数工程师在模型结构上一点点精雕细琢,才换来今天这一句流畅的回答。这或许正是我们这个时代最酷的科技浪漫。
核心要点
相关推荐

12GB显卡跑68GB大模型:Betelgeuse引擎实测22 tok/s
开发者发布Betelgeuse推理引擎,在RTX 3060 12GB+16GB DDR4的普通PC上以22 tok/s持续运行68GB Qwen 3.8 Flash Next MoE模型,峰值48 tok/s,且输出100%比特精确。

付费踢人抢网站?这个实验性项目引爆所有权争夺
开发者推出实验性网站 hijackthis.lol,付费1美元即可踢走当前占领者成为网站新主人,保护期与退款机制引发数字所有权博弈。

用领英帖子打造AI分身,靠谱吗?
讨论用多年领英帖子构建知识库型AI分身的可行性:相比模仿文风,引用原始内容的AI克隆更有价值,但面临观点过时、信任授权和持续维护等挑战。